前面留了一个尾巴:
select id,name where name='shenjian'
select id,name,sex where name='shenjian'
多查询了一个属性,为何检索过程完全不同?
什么是回表查询?
什么是索引覆盖?
如何实现索引覆盖?
哪些场景,可以利用索引覆盖来优化SQL?
这些,这是今天要分享的内容。
一、什么是回表查询?
这先要从InnoDB的索引实现说起,InnoDB有两大类索引:
1. 聚集索引(clustered index);
2. 普通索引(secondary index);
InnoDB聚集索引和普通索引有什么差异?
InnoDB聚集索引的叶子节点存储行记录,因此, InnoDB必须要有,且只有一个聚集索引:
1. 如果表定义了PK,则PK就是聚集索引;
2. 如果表没有定义PK,则第一个not NULL unique列是聚集索引;
3. 否则,InnoDB会创建一个隐藏的row-id作为聚集索引;
画外音:所以PK查询非常快,直接定位行记录。
InnoDB普通索引的叶子节点存储主键值。
画外音:注意,不是存储行记录头指针,MyISAM的索引叶子节点存储记录指针。
举个栗子,不妨设有表:
t(id PK, name KEY, sex, flag);
画外音:id是聚集索引,name是普通索引。
表中有四条记录:
1, shenjian, m, A
3, zhangsan, m, A
5, lisi, m, A
9, wangwu, f, B
两个B+树索引分别如上图:
1. id为PK,聚集索引,叶子节点存储行记录;
2. name为KEY,普通索引,叶子节点存储PK值,即id;
既然从普通索引无法直接定位行记录,那普通索引的查询过程是怎么样的呢?
通常情况下,需要扫码两遍索引树
。
例如:
select * from t where name='lisi';
是如何执行的呢?
如粉红色路径,需要扫码两遍索引树:
1. 先通过普通索引定位到主键值id=5;
2. 在通过聚集索引定位到行记录;
这就是所谓的回表查询,先定位主键值,再定位行记录,它的性能较扫一遍索引树更低。
二、什么是索引覆盖(Covering index)?
额,楼主并没有在MySQL的官网找到这个概念。
借用一下SQL-Server官网的说法。
MySQL官网,类似的说法出现在explain查询计划优化章节,即explain的输出结果Extra字段为Using index时,能够触发索引覆盖。
不管是SQL-Server官网,还是MySQL官网,都表达了:只需要在一棵索引树上就能获取SQL所需的所有列数据,无需回表,速度更快。
三、如何实现索引覆盖?
常见的方法是:将被查询的字段,建立到联合索引里去。
还是之前文章的例子:
create table user (
id int primary key,
name varchar(20),
sex varchar(5),
index(name)
)engine=innodb;
第一个SQL语句:
select id,name from user where name='shenjian';
能够命中name索引,索引叶子节点存储了主键id,通过name的索引树即可获取id和name,无需回表,符合索引覆盖,效率较高。
画外音,Extra:Using index
。
第二个SQL语句:
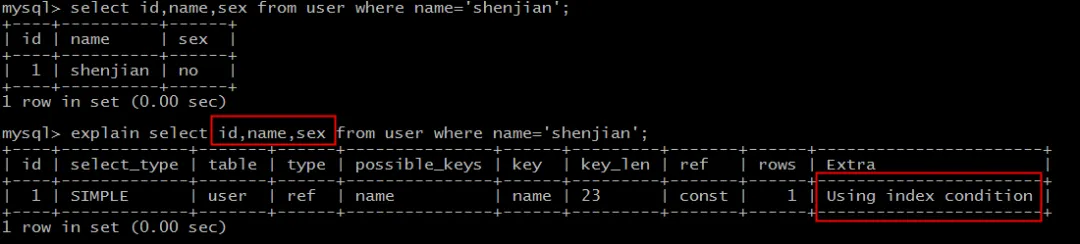
select id,name,sex from user where name='shenjian';
能够命中name索引,索引叶子节点存储了主键id,但sex字段必须回表查询才能获取到,不符合索引覆盖,需要再次通过id值扫码聚集索引获取sex字段,效率会降低。
画外音,Extra:
Using index condition。
如果把(name)单列索引升级为联合索引(name, sex)就不同了。
create table user (
id int primary key,
name varchar(20),
sex varchar(5),
index(name, sex)
)engine=innodb;
可以看到:
select id,name ... where name='shenjian';
select id,name,sex ... where name='shenjian';
都能够命中索引覆盖,无需回表。
画外音,Extra:Using index
。
四、哪些场景可以利用索引覆盖来优化SQL?
场景1:全表count查询优化
原表为:
user(PK id, name, sex);
直接:
select count(name) from user;
不能利用索引覆盖。
添加索引:
alter table user add key(name);
就能够利用索引覆盖提效。
场景2:列查询回表优化
select id,name,sex ... where name='shenjian';
这个例子不再赘述,将单列索引(name)升级为联合索引(name, sex),即可避免回表。
场景3:分页查询
select id,name,sex ... order by name limit 500,100;
将单列索引(name)升级为联合索引(name, sex),也可以避免回表。
五、AI时代,AI如何帮助我们做优化?
随着AI技术的发展,数据库优化也进入了智能化时代。索引覆盖的创建和维护,不再仅仅依赖DBA的经验,AI可以通过分析大量查询模式和数据特征,自动推荐甚至自动创建最合适的覆盖索引。
传统做法需要DBA分析慢查询日志,再手动创建索引。
而AI驱动的方式是:
1. 自动识别高频查询模式;
2. AI系统持续分析SQL日志,自动识别出高频且性能关键的查询;
3. 通过EXPLAIN分析,发现上述查询需要回表,性能有优化空间;
4. 智能推荐覆盖索引;
在这个过程中,AI会推荐联合索引,这个索引包含where条件和select列表的字段,来实现索引覆盖。
AI还会计算索引的选择性、存储成本等,确保推荐合理。创建索引后,AI持续监控其使用效果。如果业务模式变化,AI会自动识别并建议调整或删除不必要的索引。
更具体的,云服务商的数据库AI功能,例如DAS的自动索引推荐、DBbrain的索引优化建议,大家都可以尝试尝试。
InnoDB聚集索引普通索引
,回表,索引覆盖,希望这1分钟大家有收获。