来源:外媒
编辑:keyu
【新智元导读】在机器学习深入工业界时,实际操作并没有想象中那么简单。要部署任何项目,都需要经过完整的生命周期,而这个周期对于开发机器学习模型至关重要。此文深入全面总结了从零开始到正式上线过程中的所有步骤,并总结了各个步骤的常用工具。
在这个「人人AI」的时代,很多人都会或多或少接触过机器学习(ML)。
似乎每一家需要数据的公司,都在尝试利用人工智能和机器学习来分析他们的业务并提供自动化解决方案。
「《财富》的商业洞察板块(Fortune Business Insights)预计,到2027年,机器学习的市值将达到1170亿美元。」
机器学习的火爆,使得许多没有相关背景的新手也纷纷跨入该行业。当然,这本身确实是一件好事,然而,我们也需要明白,将机器学习项目整合到实际生产环境中,其实远没有想象的那么容易。
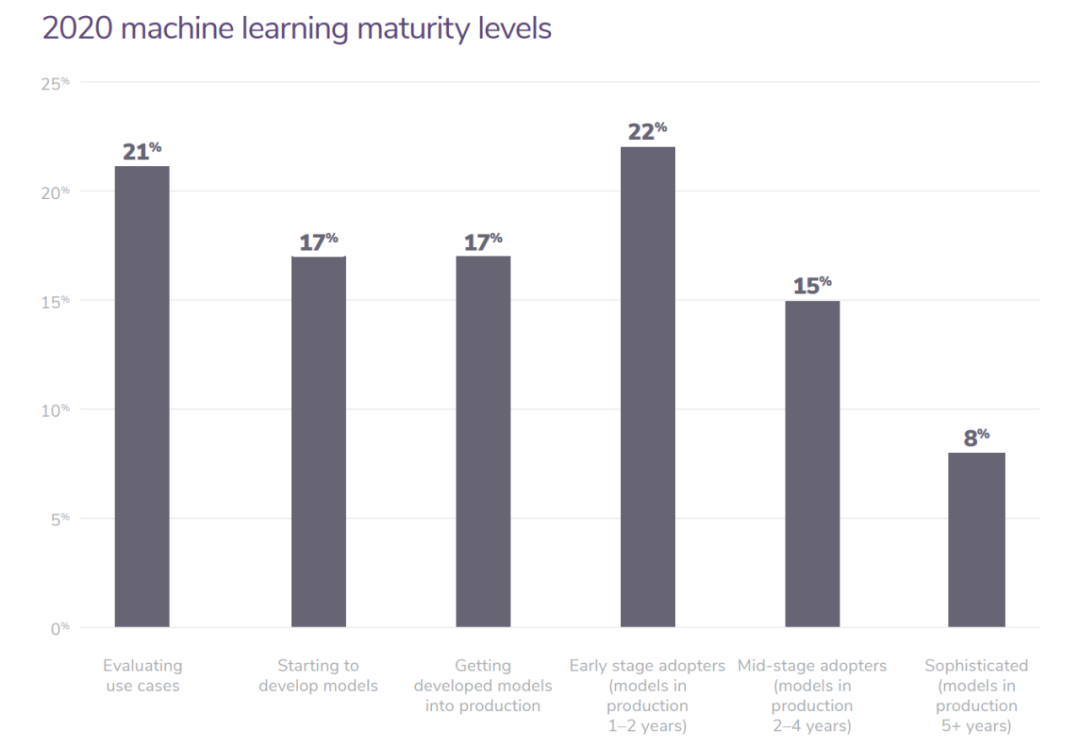
图:Algorithmia公司基于750家企业得出的2020企业ML使用状态图像
「Algorithmia公司经过调查表示:55%从事机器学习模型的企业尚未将其投入生产」
在这里可以一提的是,Algorithmia是一家提供简化机器学习的平台的创业公司,它在2017年6月已经从谷歌那里完成了一项价值1050万美元的a轮融资。
许多人似乎认为,如果有了训练模型所需的数据和计算资源,实现机器学习项目是相当简单的。
但是,其实这是大错特错的——
这种假设很可能会导致在没有部署模型的情况下,消耗大量的时间和金钱成本。
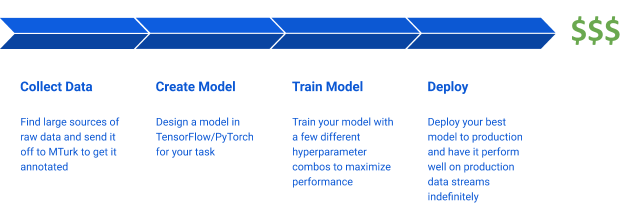
图:机器学习生命周期的朴素假设
在本文中,我们将深入详细地讨论机器学习项目的生命周期实际上是什么样子的,以及周期内每个阶段可以用到的一些工具。
在现实中,机器学习项目并不简单,它是一个在改进数据、模型和评估之间循环往复的过程,并且永远不会真正完成。
这个循环对于开发机器学习模型至关重要,因为它侧重于使用模型结果和评估来细化数据集。此外,高质量的数据集是训练高质量模型最可靠的方法。
这个循环的迭代速度,决定了你需要花费的成本。幸运的是,有一些工具可以帮助你在不牺牲质量的情况下,加速这个循环。
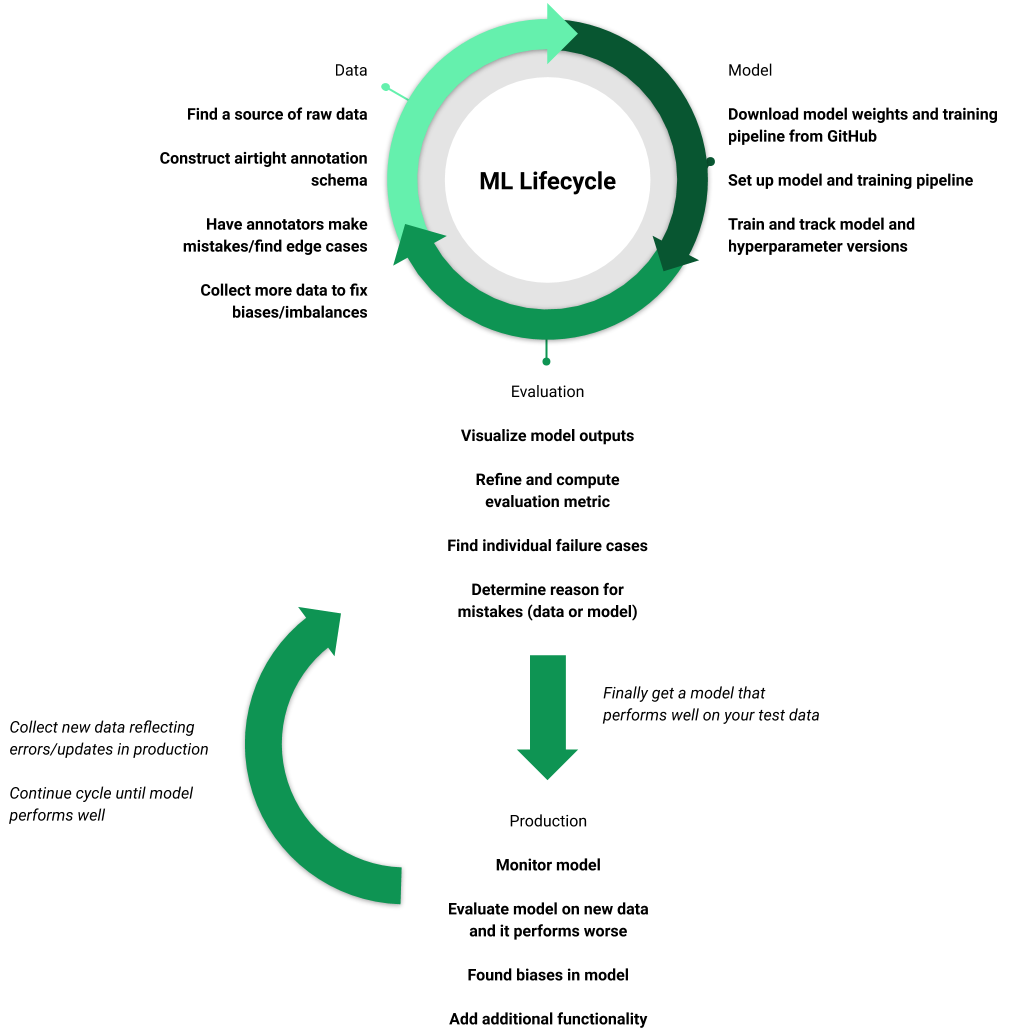
图:机器学习生命周期的一个真实例子
与任何系统非常相似,即使是已经部署的机器学习模型,也需要不断的被监控、维护和更新。我们不能只是部署一个模型,然后忘记它,期望它在接下来的时间里,像在测试集上一样,在现实世界中有着很好的表现。
部署在现实世界环境中的机器学习模型需要被更新——因为我们会发现模型中的偏差,或者添加新的数据源,或者需要额外的功能等等。
而这些都会将整个项目带回到数据、模型和评估周期中。
下一节,我们将深入探讨机器学习生命周期的每个阶段,并重点介绍各个阶段可以用到的当下流行的工具。
图:机器学习周期的数据部分
虽然大家的最终目标是一个高质量的模型,但训练一个好的模型的关键之一,在于传递给它的数据的数量。
机器学习生命周期中,数据方面的相关步骤是:
1、数据收集
第一步,是在不管最终的数据质量的情况下,先收集尽可能多的原始数据。在这部分原始数据中,只有一小部分数据会被注释,这也是大部分成本的来源。
而当模型性能出现问题时,根据需要添加大量数据是很有用的。
下面是常用的公共数据集列表:
https://medium.com/towards-artificial-intelligence/best-datasets-for-machine-learning-data-science-computer-vision-nlp-ai-c9541058cf4f
2、定义注释模式
这个环节,是生命周期里数据阶段最重要的部分之一,而它却经常被忽视。
如果构造了不良的注释模式,那么会出现不明确的类和边缘案例,从而使训练模型变得更加困难。
例如,目标检测模型的性能很大程度上取决于大小、定位、方向和截断等属性。因此,在注释期间将目标大小、密度和遮挡等属性囊括其中,有助于模型可以学习到数据中的关键信息。
下面两个是有助于这个过程的常用工具:
Matplotlib, Plot - 帮你发现数据中的Plot属性
Tableu -可以帮助你更好理解数据的分析平台
3、数据注释
给数据注释是一个冗长乏味的过程,每次都要连续数小时地执行相同重复的任务,这也是注释服务蓬勃发展的原因之一——很多人并不想亲手花大量时间在注释上。
而这样会导致注释者可能犯了很多错误:虽然大多数注释公司都会说明最大误差率(例如2%的最大误差率),但更大的问题是,如果定义不当的注释模式,会导致注释者以不同的方式标记样本。
然而,注释公司的团队很难发现这一点,所以你需要自己检查。
下面是常用的各种注释服务:
Scale, Labelbox, Prodigy - 流行的注释服务
Mechanical Turk - 众包注释
CVAT - DIY的计算机视觉注释
Doccano - NLP专用注释工具
Centaur Labs -医疗数据标签服务
4、改进数据集和注释
在尝试改进模型性能时,你可能会花费大量的时间。
如果模型正在学习的过程中,但性能却不佳,那么罪魁祸首几乎总是包含偏差和错误的训练数据集,这些偏差和错误限制了模型的性能上限。
改进模型通常会涉及到硬样本挖掘(比如如果模型在数据集A上表现不好,那么就在训练数据中添加类似于数据集A的新数据)、根据模型了解到的偏差重新平衡数据集,以及更新注释模式以添加新标签和改进现有标签。
下面是常用的改进数据集和注释的工具:
DAGsHub - 数据集版本控制
FiftyOne - 将数据可视化并找出错误
图:机器学习生命周期中的模型部分
即使在这个过程中的输出是「看起来很重要的模型」,但其实,在整个循环当中,这部分所需要花费的时间是最少的。
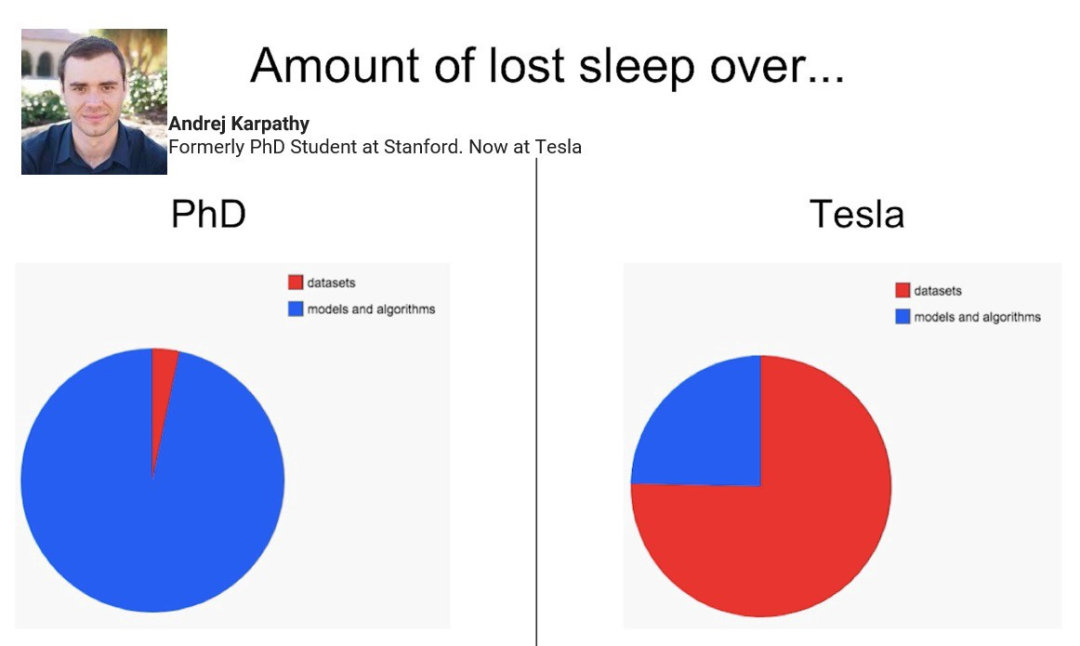
图:在工业界,花费在数据集上的时间比花在模型上的时间更多
探索现有的预训练模型
这个环节的目标是用尽可能多的可用资源,给建立模型的过程一个最好的开始。
「迁移学习」是当今深度学习的核心内容:我们可能不会从头开始创建一个模型,而是对一个已存在的模型进行微调,而该模型是在相关任务上预先训练好的。
例如,如果你想创建一个口罩检测模型,那么你可能会从GitHub下载一个预先训练好的人脸检测模型,因为这个人脸检测模型发展更成熟,更流行,也有更多的前期工作铺垫。
下面是该环节常用的工具和方法:
FiftyOne model zoo - 使用一行代码,即可下载和运行模型
TensorFlow Hub - 训练过的ML模型仓库
modelzoo.oo - 为包含了各种任务和库预先训练的深度学习模型
构建训练循环
你的数据可能并不会和用来预训练的数据完全属于同一类型。
比如,对于图像数据集,在为模型设置训练pipeline时,需要考虑输入分辨率和对象大小等因素。
此外,你还需要修改模型的输出结构,以匹配标签的类和结构。PyTorch lightning就提供了一种简单的方法,使用这种方法,即可用有限的代码扩大模型训练。
下面是该环节常用的工具:
Scikit Learn - 构建和可视化经典机器学习系统
PyTorch, PyTorch Lightning, TensorFlow, TRAX - 流行的深度学习Python库
Sagemaker - 在Sagemaker IDE中建立和训练机器学习系统
实验跟踪
在整个周期内,这一环节可能需要多次迭代。
你最终会训练出很多不同的模型,所以你需要仔细地跟踪模型的不同版本,以及训练时用到的超参数和数据,这将极大地帮助你保持事情的条理性。
在这个过程中,常用的工具有:
Tensorbord,Weights & Biases,MLFlow - 可视化和跟踪模型超参数
除此之外,这里还有一个小Tips:
即使你认为你的任务是完全独特的,在训练前你也可以使用一些技巧。比如你可以研究一下非监督或半监督的方式对模型进行预训练的方法,并且只使用全部原始数据的一小部分进行微调。
根据任务情况,你还可以试着使用合成的数据去预训练你的模型。
这么做的目标是能够获得一个可以很好地表示数据的模型,如此以来,你的微调数据集只需要用来训练几个有价值的模型参数层即可。
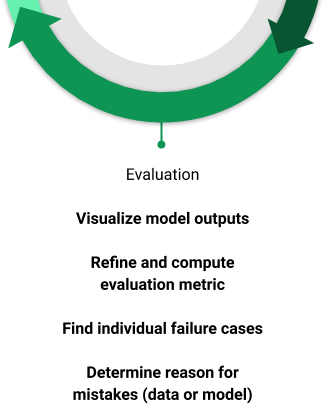
图:机器学习生命周期中的评估部分
一旦你成功地获得了一个学习过训练数据的模型,那么接下来就应该深入研究它在「新数据」上的表现是如何的。
下面是评估机器学习模型的关键步骤:
可视化模型输出
一旦有了一个训练好的模型,你需要立即运行几个测试的例子,并且观察输出结果。
这是在对整个测试集运行评估之前,发现训练或者评估pipeline过程中是否有错误的最好的方法。
此外,这个过程的结果还会让你知道模型中是否有任何明显的错误——比如有两个类被错误标记了。
你可以使用以下工具来辅助:
OpenCV, Numpy, Matplotlib - 可编写自定义可视化脚本
FiftyOne - 可视化针对图像和视频此类计算机视觉任务中的输出
选择正确的衡量标准
在观察到了几个样本的输出结果之后,你需要提出一个或几个衡量标准,这可以帮助你比较模型的整体性能。
对于一个特定的任务,为了确保获得最佳模型,你需要创造一个与最终目标相一致的模型衡量指标。
与此同时,当你发现你想追踪的其他重要特性时,你还需要更新指标:举个例子,比如你想检测你创建的目标检测模型在小规模目标上是如何表现的,那么你就可以使用「边界框< 0.05」作为度量的标准之一。
不过需要注意的是,虽然这些度量指标在比较多个模型的性能时很有用,但它们却很少有助于开发者理解如何提高模型性能的过程。
这个过程中,下面一些工具较为常用:
Scikit Learn - 提供了通用的衡量指标
Python, Numpy - 可以实现开发自定义指标
看看失败案例
你输入的训练数据决定了模型的表现,假设模型学到了一些信息,但是却表现得比你预期的要差,那么你就需要看看数据了。
查看模型运行良好的例子可能会很有用,但是查看模型预测错误的例子是最重要的。在查看了足够多的这些例子之后,你会逐渐发现模型在什么类型的例子上总会表现失败。
例如,下面的图像显示了Open Images数据集的示例,有一个后轮呈现出了假阳性。这个假阳性结果的起因,来源于有一个注释缺失了。因此,检查一遍数据集中的所有注释,并修正其他相似的错误,可以帮助提高该模型在轮胎上的表现性能。
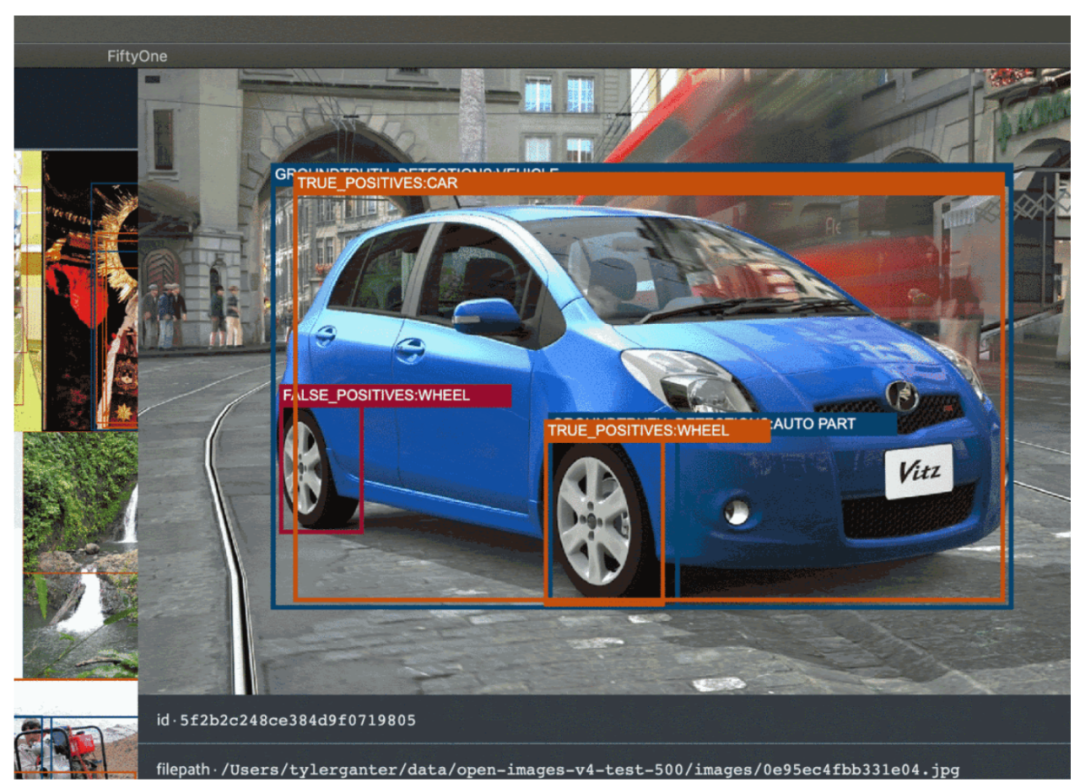
图:来自Tyler Ganter
这一环节中,常用的工具有:
FiftyOne、Aquarium, Scale Nucleus - 可以通过调试数据集来发现错误
制定解决方案
找出提升模型性能的方法的第一步,是明确失败案例的特征。
在大部分情况下,你需要通过添加训练数据来解决问题,但训练数据不是随意添加的,而应该是哪些和测试失败例子相似的数据。此外,你还可以改变pipeline中的预处理或者后续处理的过程,或者修正注释。
不管解决方案是什么,它都是起源于对模型的失败例子的理解而产生的。
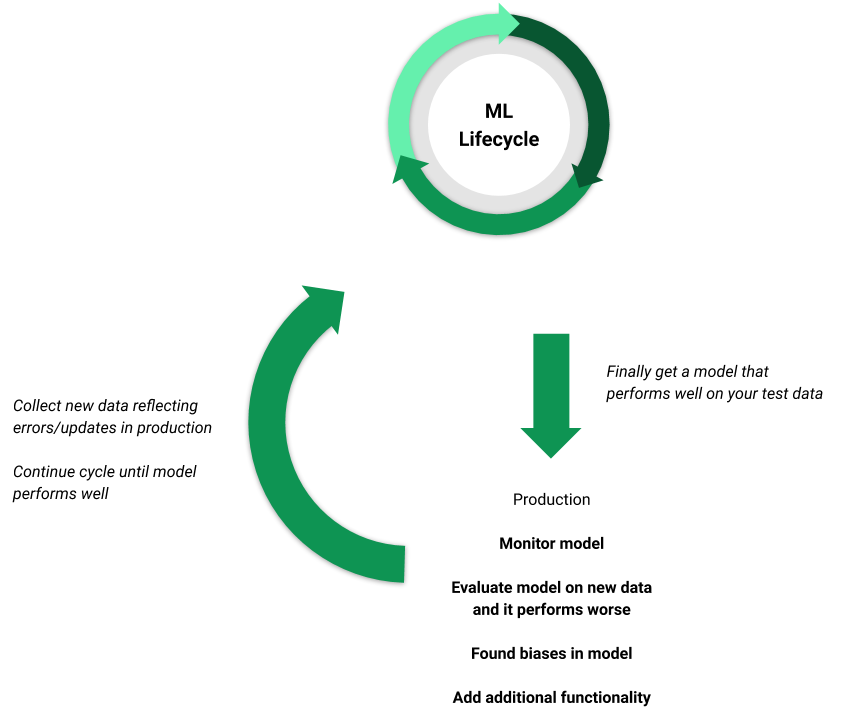
图:部署一个模型
在这个阶段,你终于得到了一个在评估指标上表现还不错的模型,并且在边缘样本上不会产生重大错误。
现在,你需要做什么呢?
监控模型
在这一步骤中, 你需要测试部署情况,以确保模型在测试数据中,仍然按照你的评估指标和推断速度等方面的指标来执行。
这一阶段中,常用的工具有:
Pachyderm, Algorithmia, Datarobot, Kubeflow, MLFlow - 可以帮助你对模型和pipeline军星部署和监控
Amazon Web Services,Google AutoML, Microsoft Azure - 这些是基于云的机器学习模型解决方案
评估新数据
在实际生产过程中使用训练好的模型,意味着你需要经常将从来没有在该模型上测试过的数据不断地输入到整个框架当中。
在这个过程中,有一些举措特别重要:1 用你指定的衡量指标对这些新数据进行评估 2 深入观察特别的例子,使用这些举措,你可以发现模型在新数据上的具体表现情况。
继续理解模型
模型中的一些误差和偏见可能是根深蒂固的,并且需要很长时间才能被发现。
在这个过程中,你需要不断测试和探索你的模型,以发现各种可能导致模型出现问题的边缘情况以及趋势,不然,这些问题就可能会被客户发现。
扩展功能
即使一切都很完美,模型也可能并没有给你带来预期中的利润。
有无数种方法可以扩展当前模型的功能:比如添加新类、开发新数据流以及提高现有模型的效率——这些举措都会使当前模型变得更好。
此外,只要想提升系统的性能,那么你都需要重新启动机器学习的生命周期,来更新数据和模型,并对其进行评估,以此来确保新的系统可以按照预期来顺利工作。
参考链接:
https://towardsdatascience.com/the-machine-learning-lifecycle-in-2021-473717c633bc