(给数据分析与开发加星标,提升数据技能)
来源:SegmentFault - llinvokerl
1 概述
MySQL有两种方式可以实现ORDER BY:
1.通过索引扫描生成有序的结果
2.使用文件排序(filesort)
围绕着这两种排序方式,我们试着理解一下ORDER BY的执行过程以及回答一些常见的问题(下文仅讨论InnoDB存储引擎)。
2 索引扫描排序和文件排序(filesort)简介
我们知道InnoDB存储引擎以B+树作为索引的底层实现,B+树的叶子节点存储着所有数据页而内部节点不存放数据信息,并且所有叶子节点形成一个(双向)链表。
举个例子,假设userinfo表的userid字段上有主键索引,且userid目前的范围在1001~1006之间,则userid的索引B+树如下(这里只是为了举例,下图忽略了InnoDB数据页默认大小16KB、双向链表,并且假设B+树度数为3、userid顺序插入):

现在我们想按照userid从小到大的顺序取出所有用户信息,执行以下SQL:
SELECT *
FROM userinfo
ORDER BY userid;
MySQL会直接遍历上图userid索引的叶子节点链表,不需要进行额外的排序操作。这就是用索引扫描来排序。
但如果userid字段上没有任何索引,图1的B+树结构不存在,MySQL就只能先扫表筛选出符合条件的数据,再将筛选结果根据userid排序。这个排序过程就是filesort。
下文将详细介绍这两种排序方式。
3 索引扫描排序执行过程分析
介绍索引扫描排序之前,先看看索引的用途
SQL语句中,WHERE子句和ORDER BY子句都可以使用索引:WHERE子句使用索引避免全表扫描,ORDER BY子句使用索引避免filesort(用“避免”可能有些欠妥,某些场景下全表扫描、filesort未必比走索引慢),以提高查询效率。
虽然索引能提高查询效率,但在一条SQL里,对于一张表的查询 一次只能使用一个索引(注:排除发生index merge的可能性),也就是说当WHERE子句与ORDER BY子句要使用的索引不一致时,MySQL只能使用其中一个索引(B+树)。
也就是说,一个既有WHERE又有ORDER BY的SQL中,使用索引有三个可能的场景:
举个例子,我们创建一张orderdetail表 记录每一笔充值记录的userid(用户id)、money(充值金额)、createtime(充值时间),主键是自增id:
CREATE TABLE `order_detail` (
`id` int(11) NOT NULL AUTO_INCREMENT,
`userid` int(11) NOT NULL,
`money`
float NOT NULL,
`create_time` timestamp NOT NULL DEFAULT CURRENT_TIMESTAMP,
PRIMARY KEY (`id`),
KEY `userid` (`userid`),
KEY `create_time` (`create_time`)
) ENGINE=InnoDB DEFAULT CHARSET=
utf8
写脚本插入100w行数据(InnoDB别用COUNT(*)查总行数,会扫全表,这里只是为了演示):
SELECT COUNT(*) FROM order_detail;
+----------+
| COUNT(*) |
+----------+
| 1000000 |
+----------+
SELECT * FROM order_detail LIMIT 5;
+----+--------+-------+---------------------+
| id | userid | money | create_time |
+----+--------+-------+---------------------+
| 1 | 104832 | 3109 |
2013-01-01 07:40:38 |
| 2 | 138455 | 6123 | 2013-01-01 07:40:42 |
|
3 | 109967 | 7925 | 2013-01-01 07:40:46 |
| 4 | 166686 | 4307 | 2013-01-01
07:40:55 |
| 5 | 119837 | 1912 | 2013-01-01 07:40:58 |
+----+--------+-------+---------------------+
现在我们想取出userid=104832用户的所有充值记录,并按照充值时间create_time正序返回。
场景一 索引只用于WHERE子句
写出如下SQL并EXPLAIN一下:
EXPLAIN
SELECT *
FROM order_detail
WHERE userid = 104832
ORDER BY create_time;
+------+-------------+--------------+------+---------------+--------+---------+-------+------+-----------------------------+
| id | select_type | table
| type | possible_keys | key | key_len | ref | rows | Extra |
+------+-------------+--------------+------+---------------+--------+---------+-------+------+-----------------------------+
| 1 | SIMPLE | order_detail | ref | userid | userid | 4 |
const | 8 | Using where; Using filesort |
+------+-------------+--------------+------+---------------+--------+---------+-------+------+-----------------------------+
key列的值是userid,可以看出这条SQL会使用userid索引用作WHERE子句的条件过滤,而ORDER BY子句无法使用该索引,只能使用filesort来排序。这就是上文的第一个场景,整个执行流程大致如下:
先通过userid索引找到所有满足WHERE条件的主键id(注:从b+树根节点往下找叶子节点,时间复杂度为O(logN))
再根据这些主键id去主键索引(聚簇索引)找到这几行的数据,生成一张临时表(时间复杂度为O(M*logN),M是临时表的行数)
对临时表进行排序(时间复杂度O(M*logM),M是临时表的行数)
由于本例中M的值可以大概参考 rows列的值8,非常小,所以整个执行过程只花费0.00 sec。
场景二 索引只用于ORDER BY子句
接下来是上文的第二种场景,索引只用于ORDER BY子句,这即是索引扫描排序。
我们可以继续使用上文的SQL,通过FORCE INDEX子句强制Optimizer使用ORDER BY子句的索引create_time:
EXPLAIN
SELECT *
FROM order_detail
FORCE INDEX (create_time)
WHERE userid = 104832
ORDER BY create_time;
+------+-------------+--------------+-------+---------------+-------------+---------+------+--------+-------------+
| id | select_type | table | type | possible_keys | key | key_len | ref | rows | Extra |
+------+-------------+--------------+-------+---------------+-------------+---------+------+--------+-------------+
| 1 | SIMPLE |
order_detail | index | NULL | create_time | 4 | NULL | 998056 | Using where |
+------+-------------+--------------+-------+---------------+-------------+---------+------+--------+-------------+
可以看到Extra字段里的Using filesort已经没了,但是扫过的rows大概有998056行(准确的值应该是1000000行,InnoDB这一列只是估值)。这是因为索引用于ORDER BY子句时,会直接遍历该索引的叶子节点链表,而不像第一种场景那样从B+树的根节点出发 往下查找。执行流程如下:
整个时间复杂度是O(M*logN),M是主键id的总数,N是聚簇索引叶子节点的个数(数据页的个数)。本例中M的值为1000000,所以整个执行过程比第一种场景花了更多时间,同一台机器上耗时1.34 sec。
上述两个例子恰好说明了另一个道理:在某些场景下使用filesort比不使用filesort 效率更高。
场景三 索引既用于WHERE又用于ORDER BY
第三种情况发生在WHERE子句与ORDER BY子句能使用相同的索引时(如: WHERE userid > xxx ORDER BY userid),这样就能省去第二种情况的回表查询操作了。
因此,如果可能,设计索引时应该尽可能地同时满足这两种任务,这样是最好的。----《高性能MySQL》
4 文件排序(filesort)
关于filesort上文其实已经介绍过了一些。
filesort的名字起得很费解,让人误以为它会:将一张非常大的表放入磁盘再进行排序。其实不是这样的,filesort仅仅是排序而已,是否会放入磁盘看情况而定(filesort is not always bad and it does not mean that a file is saved on disk. If the size of the data is small, it is performed in memory.)。以下是《高性能MySQL》中对filesort的介绍:
如果需要排序的数据量小于“排序缓冲区”,MySQL使用内存进行“快速排序”操作。如果内存不够排序,那么MySQL会先将数据分块,可对每个独立的块使用“快速排序”进行排序,再将各个块的排序结果放到磁盘上,然后将各个排好序的块进行“归并排序”,最后返回排序结果。
所以filesort是否会使用磁盘取决于它操作的数据量大小。
总结来说就是,filesort按排序方式来划分 分为两种:
数据量大的情况下涉及到磁盘io,所以效率会低一些。
根据回表查询的次数,filesort又可以分为两种方式:
两次传输排序
两次传输排序会进行两次回表操作:第一次回表用于在WHERE子句中筛选出满足条件的rowid以及rowid对应的ORDER BY的列值;第二次回表发生在ORDER BY子句对指定列进行排序之后,通过rowid回表查出SELECT子句需要的字段信息。
举个例子,我们需要从充值记录表筛选出2018年8月11日到12日的所有userid>140000用户的订单的明细,并按照金额从大到小进行排序(下面只是为filesort举例,不是一种好的实现):
EXPLAIN
SELECT *
FROM order_detail
WHERE create_time >= '2018-08-11 00:00:00' and create_time < '2018-08-12 00:00:00' and userid >
140000
order by money desc;
+------+-------------+--------------+-------+--------------------+-------------+---------+------+------+-----------------------------+
| id | select_type | table | type | possible_keys | key | key_len | ref | rows | Extra |
+------+-------------+--------------+-------+--------------------+-------------+---------+------+------+-----------------------------+
| 1 | SIMPLE | order_detail | range | userid,create_time | create_time | 4 | NULL | 1 | Using where; Using filesort |
+------+-------------+--------------+-------+--------------------+-------------+---------+------+------+-----------------------------+
我们试着分析一下这个SQL的执行过程:
利用createtime索引,对满足WHERE子句createtime >= '2018-08-11 00:00:00' and create_time < '2018-08-12 00:00:00'的rowid进行回表(第一次回表),回表之后可以拿到该rowid对应的userid,若userid满足userid > 140000的条件时,则将该行的rowid,money(ORDER BY的列)放入排序缓冲区。
若排序缓冲区能放下所有rowid, money对,则直接在排序缓冲区(内存)进行快排。
若排序缓冲区不能放下所有rowid, money对,则分块快排,将块存入临时文件(磁盘),再对块进行归并排序。
遍历排序后的结果,对每一个rowid按照排序后的顺序进行回表操作(第二次回表),取出SELECT子句需要的所有字段。
熟悉计算机系统的人可以看出,第二次回表会表比第一次回表的效率低得多,因为第一次回表几乎是顺序I/O;而由于rowid是根据money进行排序的,第二次回表会按照rowid乱序去读取行记录,这些行记录在磁盘中的存储是分散的,每读一行 磁盘都可能会产生寻址时延(磁臂移动到指定磁道)+旋转时延(磁盘旋转到指定扇区),这即是随机I/O。
所以为了避免第二次回表的随机I/O,MySQL在4.1之后做了一些改进:在第一次回表时就取出此次查询用到的所有列,供后续使用。我们称之为单次传输排序。
单次传输排序(MySQL4.1之后引入)
还是上面那条SQL,我们再看看单次传输排序的执行过程:
利用createtime索引,对满足WHERE子句createtime >= '2018-08-11 00:00:00' and create_time < '2018-08-12 00:00:00'的rowid进行回表(第一次回表),回表之后可以拿到改rowid对应的userid,若userid满足userid > 140000的条件时,则将此次查询用到该行的所有列(包括ORDER BY列)取出作为一个数据元组(tuple),放入排序缓冲区。
若排序缓冲区能放下所有tuples,则直接在排序缓冲区(内存)进行快排。
若排序缓冲区不能放下所有tuples,则分块快排,将块存入临时文件(磁盘),再对块进行归并排序。
遍历排序后的每一个tuple,从tuple中取出SELECT子句需要所有字段。
单次传输排序的弊端在于会将所有涉及到的列都放入排序缓冲区,排序缓冲区一次能放下的tuples更少了,进行归并排序的概率增大。列数据量越大,需要的归并路数更多,增加了额外的I/O开销。所以列数据量太大时,单次传输排序的效率可能还不如两次传输排序。
当然,列数据量太大的情况不是特别常见,所以MySQL的filesort会尽可能使用单次传输排序,但是为了防止上述情况发生,MySQL做了以下限制:
我们开发者也应该尽可能让filesort使用单次传输排序,不过EXPLAIN不会告诉我们这个信息,所以我们只能肉眼检查各列的大小看看是否会触发上面两个限制 导致两次传输排序的发生。
5 补充说明
如第3小节所述,既然filesort的效率未必比索引扫描排序低,为什么很多人会想避免filesort呢?
谷歌一下using filesort,几乎都是"如何避免filesort"相关的内容:
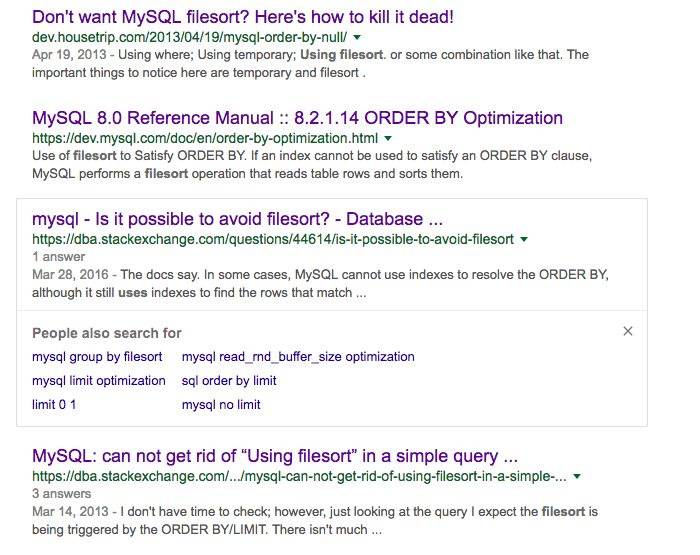
这是因为通常ORDER BY子句会与LIMIT子句配合,只取出部分行。如果只是为了取出top1的行 却对所有行进行排序,这显然不是一种高效的做法。这种场景下 按顺序取的索引扫描排序可能会比filesort拥有更好性能(当然也有例外)。
Whether the optimizer actually does so depends on whether reading the index is more efficient than a table scan if columns not in the index must also be read.
官方文档告诉我们optimizer会帮我们选择一种高效的ORDER BY方式。
但也不能完全依赖optimizer的判断,这时合理建立索引、引导它使用指定索引可能是更好的选择。
6 参考资料
MySQL 8.0 Reference Manual :: 8.2.1.14 ORDER BY Optimization
《高性能MySQL》
Sergey Petrunia's blog » How MySQL executes ORDER BY
MySQL filesort algorithms - Valinv
MySQL技术内幕:InnoDB存储引擎(第2版)
B+ Tree Visualization
B+ Trees(pdf)
MySQL :: MySQL 8.0 Reference Manual :: 8.8.2 EXPLAIN Output Format
What do Clustered and Non clustered index actually mean? - Stack Overflow
- EOF -
看完本文有收获?请转发分享给更多人
推荐关注「数据分析与开发」,提升数据技能
点赞和在看就是最大的支持❤️



