今天,手把手教你入门 Python 爬虫,爬取猫眼电影 TOP100 榜信息。
对于 Python 初学者来说,爬虫技能是应该是最好入门,也是最能够有让自己有成就感的,今天,练习 Python 的手把手系列,手把手教你入门 Python 爬虫,爬取猫眼电影 TOP100 榜信息,将涉及到基础爬虫架构中的 HTML 下载器、HTML 解析器、数据存储器三大模块:
HTML 下载器:利用 requests 模块下载 HTML 网页;
HTML 解析器:利用 re 正则表达式解析出有效数据
数据存储器:将有效数据通过文件或者数据库的形式存储起来
01 构造 HTML 下载器
import requests
from requests.exceptions import RequestException
headers = {'User-Agent':'Mozilla/5.0 '}
def get_one_page(url):
try:
res = requests.get(url,headers = headers)
if res.status_code == 200:
return res.text
return None
except RequestException:
return None
02 构造 HTML 解析器
def parse_one_page(html):
pattern = re.compile('.*?board-index.*?>(\d+).*?src="(.*?)".*?name"> +'.*?>(.*?).*?star">(.*?)
.*?releasetime">(.*?)'
+'.*?integer">(.*?).*?fraction">(.*?).*?',re.S)
items = re.findall(pattern,html)
for item in items:
yield{
'index': item[0],
'image': item[1],
'title': item[2],
'actor': item[3].strip()[3:],
'time': item[4].strip()[5:],
'score': item[5] + item[6]
}
注意事项:
在函数中本来该 return 的地方用 yield,如果用 return,在第一轮循环就会跳出,结果文件只会有一部电影。如果用 yield,函数返回的就是一个生成器,而生成器作为一种特殊的迭代器,可以用 for——in 方法,一次一次的把 yield 拿出来;
re.findall(pattern,string[,flags]):搜索整个 string,以列表的形式返回能匹配的全部子串,其中参数是匹配模式,如 re.S 表示点任意匹配模式,改变“.”的行为。
03 构造数据存储器
def write_to_file(content):
with open ('result.txt', 'a',encoding='utf-8') as f:
f.write(json.dumps(content,ensure_ascii=False) + '\n')
f.close()
注意事项:
为什么 ensure_ascii=False?原因是 json 默认是以 ASCII 来解析 code 的,由于中文不在 ASCII 编码当中,因此就不让默认 ASCII 生效;
要写入特定编码的文本文件,请给 open()函数传入 encoding 参数,将字符串自动转换成指定编码。细心的童鞋会发现,以'w'模式写入文件时,如果文件已存在,会直接覆盖(相当于删掉后新写入一个文件)。如果我们希望追加到文件末尾怎么办?可以传入'a'以追加(append)模式写入。
接下来就是构造主函数,初始化各个模块,传入入口 URL,按照运行流程执行上面三大模块:
def main(offset):
url = 'http://maoyan.com/board/4?offset=' + str(offset)
html = get_one_page(url)
for item in parse_one_page(html):
print(item)
write_to_file(item)
if __name__ == '__main__':
p = Pool()
p.map(main,[i*10 for i in range(10)])
注意事项:
执行代码后,结果如下:
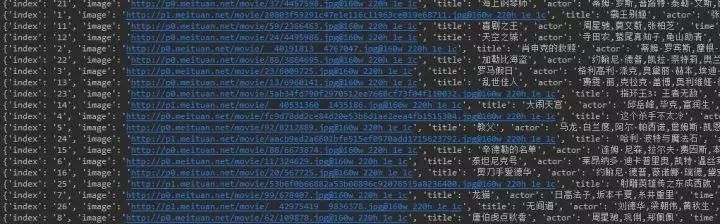
本文中介绍了基础爬虫架构主要的的三个模块(HTML 下载器、HTML 解析器、数据存储器),无论大型还是小型爬虫都不会脱离这三个模块,也希望大家通过这个小小的练习对整个爬虫有个清晰的认识。
get以上技能,加入【Python 网络爬虫数据分析实战】马上掌握!
点击阅读原文查看课程
End.
作者:丁彦军
来源:CSDN