机器学习
Author:louwill
Machine Learning Lab
本文总共涉及了26种机器学习模型与算法,几乎涵盖了全部主流的机器学习算法。包括线性回归、逻辑回归、Lasso回归、Ridge回归、线性判别分析、近邻、决策树、感知机、神经网络、支持向量机、AdaBoost、GBDT、XGBoost、LightGBM、CatBoost、随机森林、聚类算法与kmeans、主成分分析、奇异值分解、最大信息熵、朴素贝叶斯、贝叶斯网络、EM算法、隐马尔可夫模型、条件随机场和马尔可夫链蒙特卡洛方法。
其中决策树、神经网络、支持向量机和聚类算法都各自代表了一个大类算法,比如说决策树具体包括ID3、C4.5和CART,神经网络包括DNN、CNN或者是RNN等其他网络模型,这里仅对大类算法做区分。
下面我们分别从单模型和集成学习模型、监督学习和无监督学习模型和判别式模型和生成式模型、概率模型和非概率模型等多个维度来讨论本书所涉及到的26个算法。

图1 机器学习模型知识体系
单模型与集成模型
从模型的个数和性质角度来看,我们可以将机器学习模型划分为单模型(single model)和集成模型(ensemble model)。所谓单模型,是指机器学习模型仅包括一个模型,以某种模型独立进行训练和验证使用的。本书监督学习模型中大多数模型都可以算作单模型,包括线性回归、逻辑回归、Lasso回归、Ridge回归、线性判别分析、近邻、决策树、感知机、神经网络、支持向量机和朴素贝叶斯等。
与单模型相对立的,就是集成模型,集成模型就是将多个单模型进行组合构成一个强模型,这个强模型能取所有单模型之所长,达到一个相对的最佳性能。集成模型中的单模型既可以是同种类别的,也可以是不同类别的,总体呈现一种“多而不同”的特征。常用的集成模型包括Boosting和Bagging两大类,主要包括AdaBoost、GBDT、XGBoost、LightGBM、CatBoost和随机森林等模型。单模型和集成模型分类如图2所示。
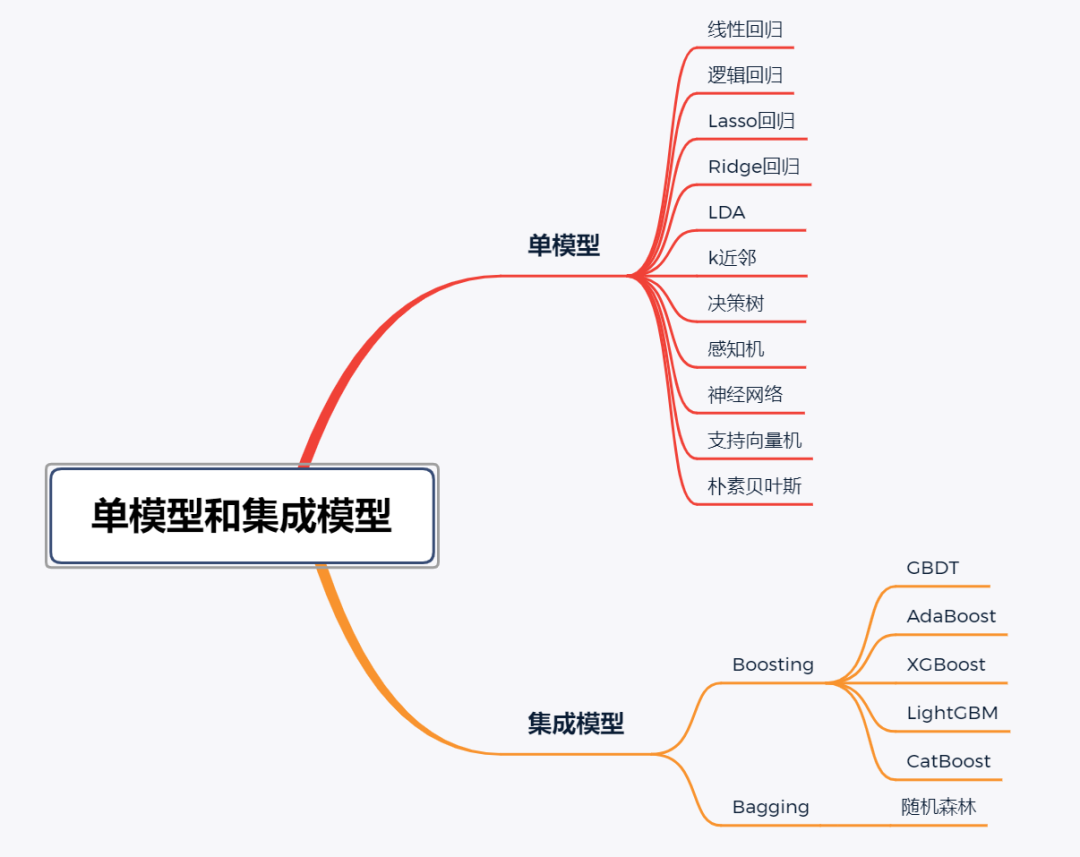
图2 单模型与集成模型
监督模型与无监督模型
监督模型(supervised model)和无监督模型(unsupervised model)代表了机器学习模型的最典型划分方式,几乎所有的模型都可以归类到这两类模型当中。监督模型是指模型在训练过程中根据数据输入和输出进行学习,监督学习模型包括分类(classification)、回归(regression)和标注(tagging)等模型。无监督模型是指从无标注的数据中学习得到模型,主要包括聚类(clustering)、降维(dimensionality reduction)和一些概率估计模型。
图2中所有的单模型和集成模型都是监督模型,以及图1中的一部分概率模型也属于监督模型,包括隐马尔可夫模型和条件随机场,它们属于监督模型中的标注模型。无监督模型主要包括kmeans聚类、谱聚类和层次聚类等一些聚类模型,以及主成分分析和奇异值分解等降维模型。另外,马尔可夫链蒙特卡洛方法也可以作为一种概率无监督模型。监督模型和无监督模型的划分如图3所示。
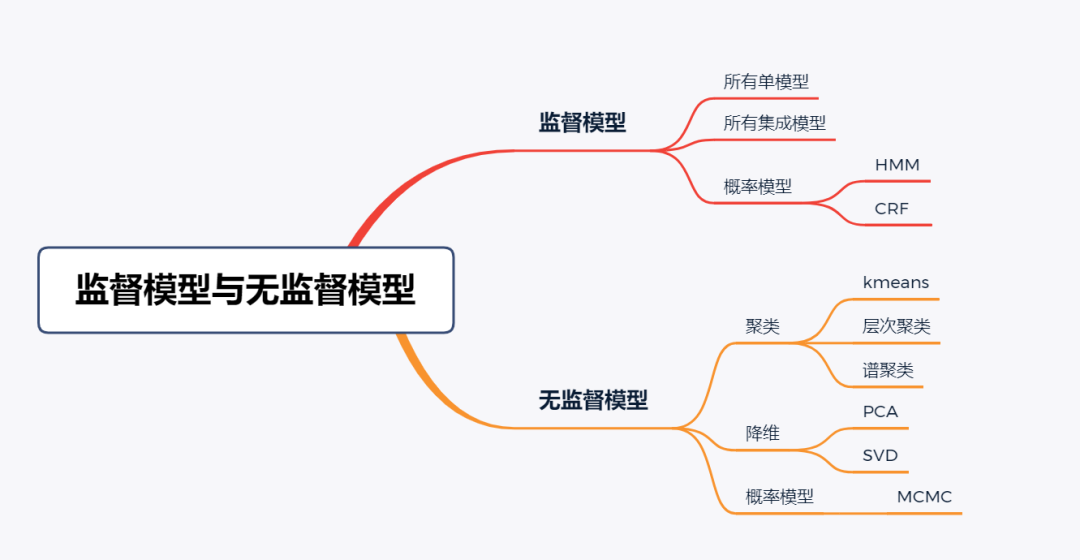
图3 监督模型与无监督模型
生成式模型和判别式模型
监督模型在机器学习模型中占主要部分,针对监督模型,我们又可以根据其模型学习方式将其分为生成式模型(generative model)和判别式模型(discriminative model)。生成式模型的学习特点在于学习数据的联合概率分布,然后基于联合分布求条件概率分布作为预测模型。如下式所示。
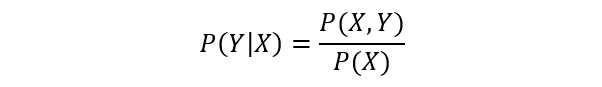
常用的生成式模型包括朴素贝叶斯、隐马尔可夫模型以及隐含狄利克雷分布模型等。
判别式模型的学习特点在于基于数据直接学习决策函数或者条件概率分布作为预测模型,判别式模型关心的是对于给定的输入,应该预测出什么样的。常用的判别式模型有很多,像线性回归、逻辑回归、Lasso回归、Ridge回归、线性判别分析、近邻、决策树、感知机、神经网络、支持向量机、最大信息熵模型、全部集成模型以及条件随机场等,都属于判别式模型。生成式与判别式模型划分如图4所示。
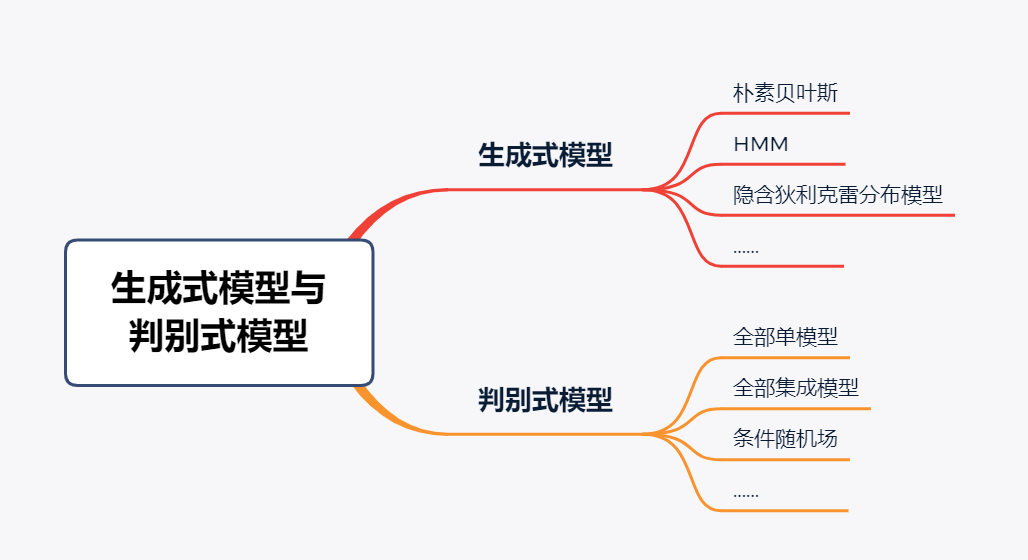
图4 生成式模型与判别式模型
概率模型与非概率模型
机器学习模型还有一种根据模型函数是否为概率模型的方式,将机器学习模型分为概率模型(probabilistic model)和非概率模型(non-probabilistic model)。通过对输入和输出之间的联合概率分布和条件概率分布进行建模的机器学习模型,都可以称之为概率模型。而通过对决策函数建模的机器学习模型,即为非概率模型。
常用的概率模型包括朴素贝叶斯、隐马尔可夫模型、贝叶斯网络和马尔可夫链蒙特卡洛等,而线性回归、近邻、支持向量机、神经网络以及集成模型都可以算是非概率模型。
需要注意的是,概率模型与非概率模型的划分并不绝对,有时候有些机器学习模型既可以表示为概率模型,也可以表示为非概率模型。比如说决策树、逻辑回归、最大熵模型和条件随机场等模型,就兼具概率模型和非概率模型两种解释。概率模型和非概率模型的划分如图5所示。
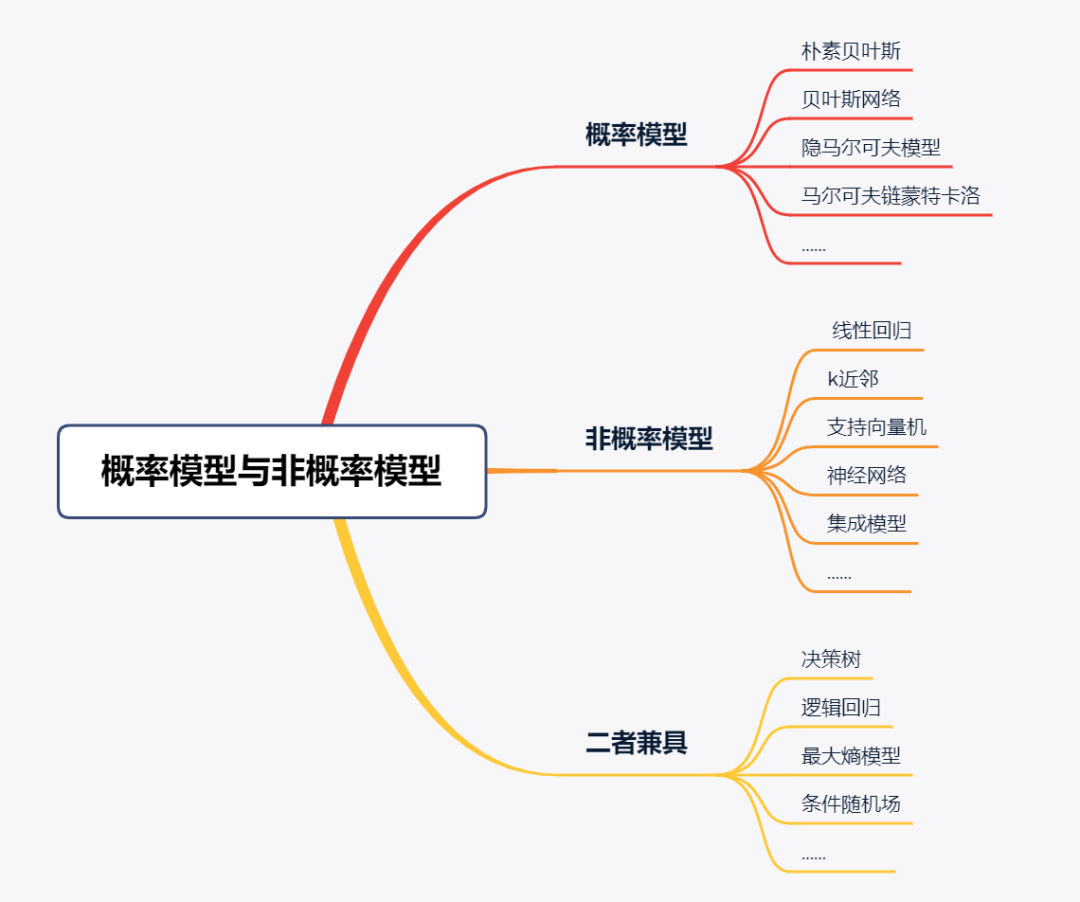
图5 概率模型与非概率模型
本站qq群851320808,加入微信群请扫码: