深度学习家喻户晓,我一直不想理睬它,心想,我干我的,关我什么事。可是,几乎天天听到这个词,别的地方能躲,微信里面也躲不掉,咱又偏偏微信上瘾。前几天,其实是找个借口出去看樱花,顺路就听了一个有关深度学习的报告。
我写过一篇“学问及八卦 (小字体版)”的帖子,如果我和随机森林有牵连属于八卦的话,我和深度学习三十年根深蒂固的渊源却是有证有据的,只是自己才学初浅,直到前几天偶然听到的报告,才让我茅塞顿开。这两天仔细读了深度学习才明白。
在传统的神经网络中,有一个核心技术,他们称“Softmax”,以柔克刚的意思。等统计学家弄明白了,就是我们天天用的逻辑回归函数。可是,他们偏要用个新名词,与统计学划清界限,常用技巧变得神秘了!咱现在不提这旧事了。
在深度学习里,类似的一招又用上了,也有一个关键技术,叫ReLU。这是什么玩意儿? 打字都不方便。洋文叫 Rectified Linear Unit。说了也是白说,直接看见下图:
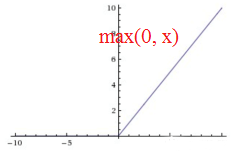
我的祖宗啊,这不就是我天天教学生用的断线回归函数嘛!这周二上午我在课堂上苦口婆心地告诉学生,这个断线函数非常实用,因为它既灵活,又简单。当天下午,我听了那个有关深度学习的报告,发现深度学习和我传授的是同一个技术。道理就好比取钱机出的现钞都是20刀,不太大带灵活性,不太小带方便性。事实上,我在“学问及八卦 (小字体版)”里讲MASAL为什么实用,就是同样道理。说到底,直线太直,一根筋,不灵活。但是,哪怕是高一维度的二次曲线都太不好控制。能折能伸的直线,便成了最好的折中选策。
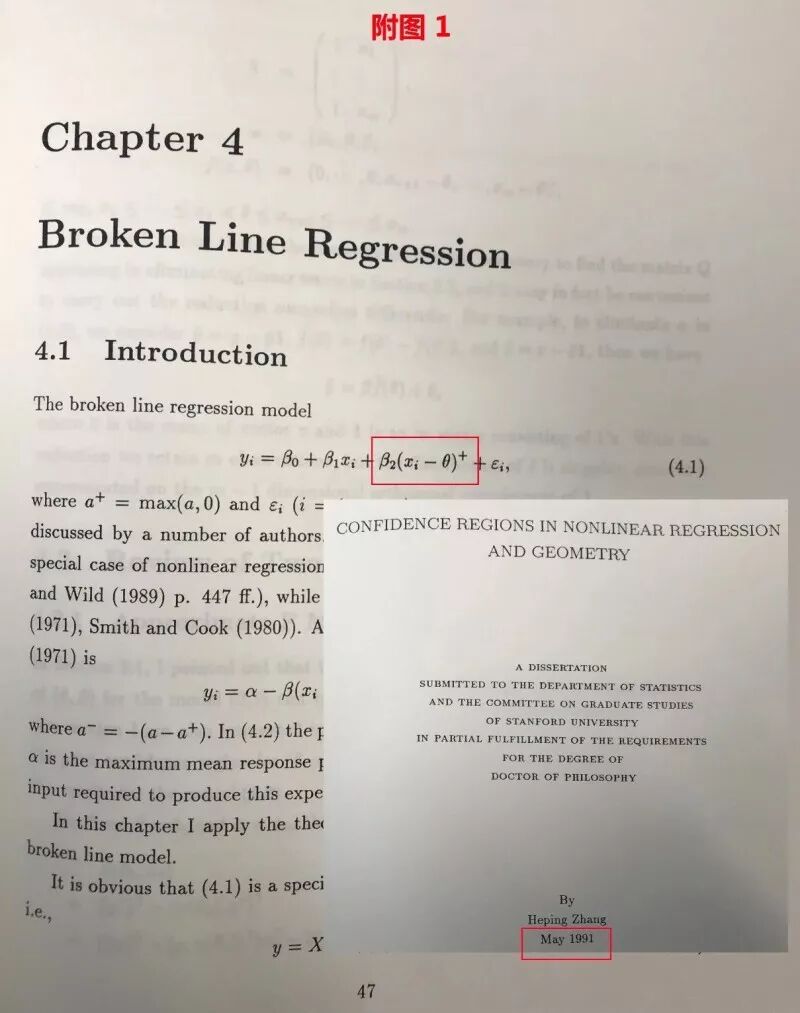
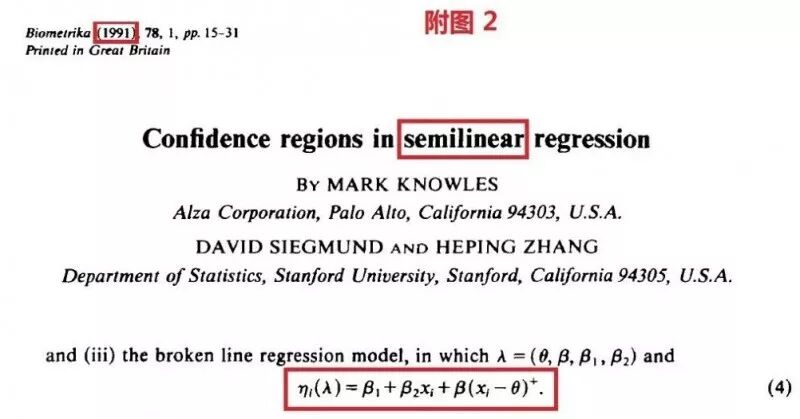
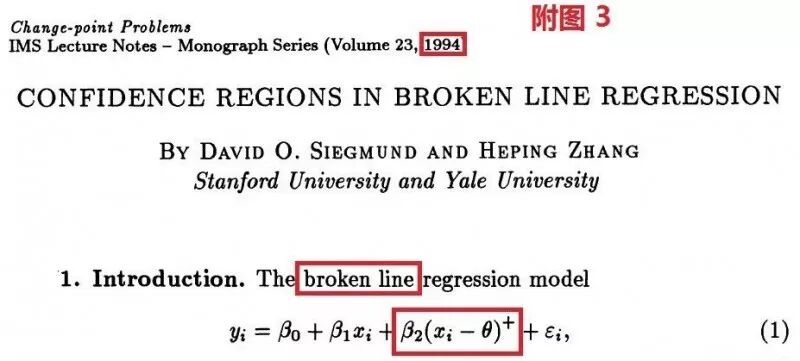
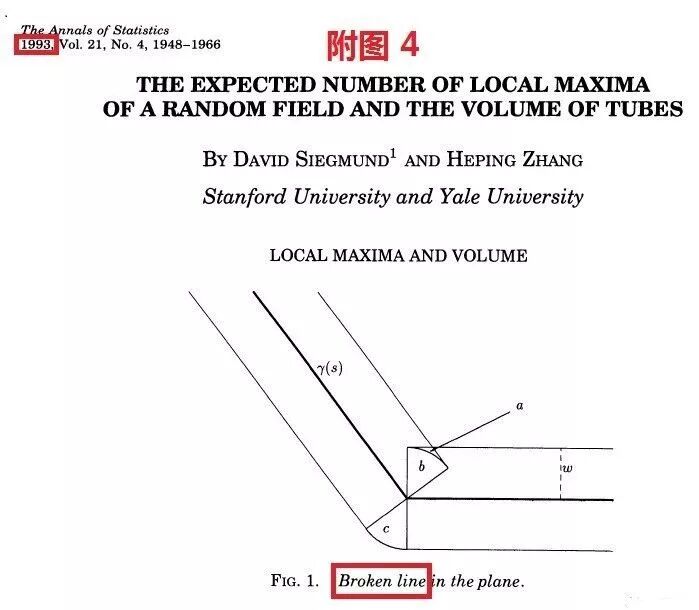
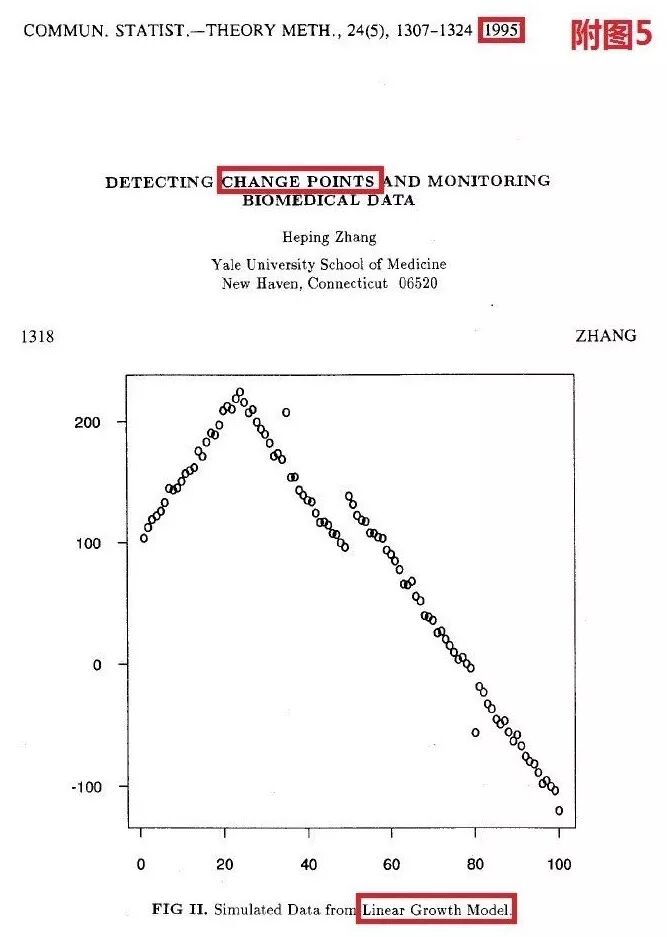
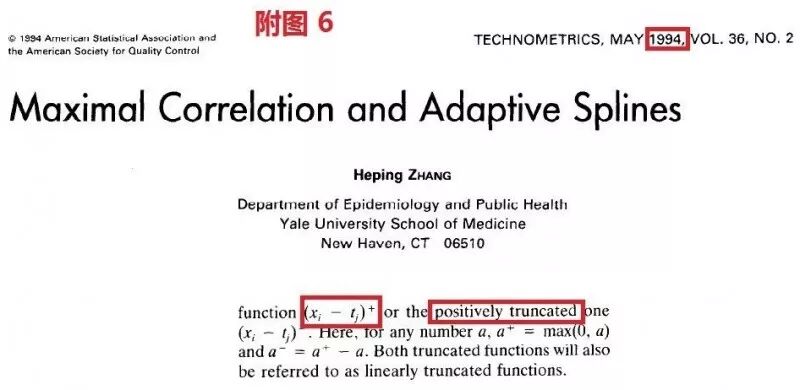
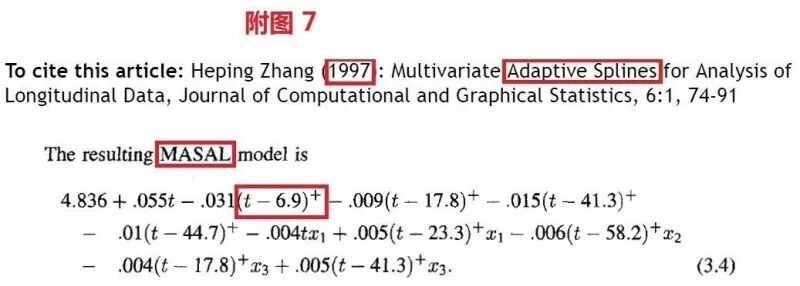
我说的三十年渊源真不吹牛。我1991年的博士论文,专门研究这函数在回归模型中的应用和性质 。(见附图1)我跟我导师早年合作写的几篇论文都是研究这个函数有关的统计诊断问题。(见附图2,3,4)甚至,我这辈子唯一没有真正发表的文章,也逃不过断线魔掌,详情以后八卦。(见附图5)我在“学问及八卦 (小字体版)”中八卦的几篇文章也跟它有关。当时就是用一段一段的线性函数估计高维函数。(见附图6,7)深度学习靠的也就是这个又简单又油滑的绝招。
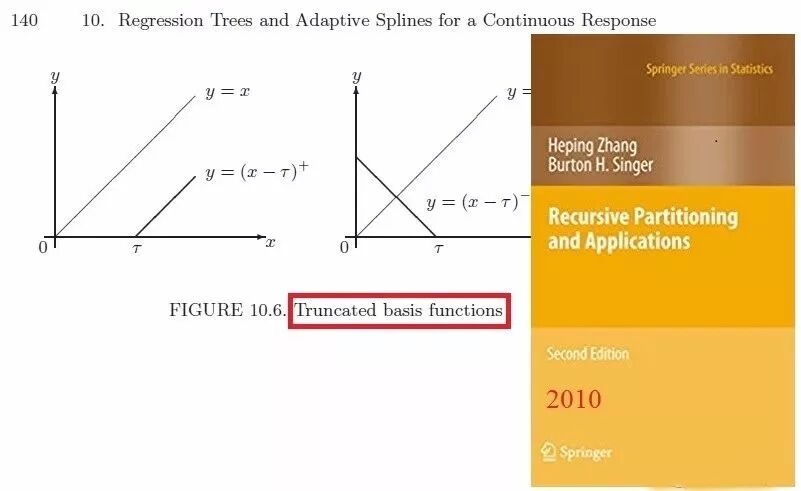
你如果还不信我玩的东东跟深度学习是两兄弟的话,顶上的图是从我书中截下来的,跟ReLU的图比较一下,不是孪生兄弟,也是双胞胎。
如果上面我讲的是深度学习的输入信息, 那么下面我想说的就是我深度学习之后的输出结果。
搞计算机的人,拿着统计常用的方法,当新鲜事物去用,放得开,走得远。
不管读者感觉如何,弄一个新名词。在我自己的文章里面,几乎毎在一个地方用一次,就給那个函数取个容易懂的名字,虽然帮助读者理解上下文,但问题是,一方面失去神秘感,另一方面常常变名字,不利于给读者形成根深蒂固的印象,难以连起来。
搞统计的人担心的事情太多,不利于突破。什么方面都要弄清楚,结果等我们扎扎实实地朝前走了一步,搞计算机的人跑得远远的。
我们怕复杂。我文章里的模型公式在统计里算是复杂的了(见附图6),可是跟深度学习的倒来倒去,简单太多了。当然,简单本身也可以是优势,由具体情况而定。但是,一味求简,过于面面俱到就会影响发展。
不要认为别人用过的东西就不新鲜,退一步海阔天空。早这样的话,说不准深度学习的技术就是我们的了。限制我们的不是技术,是少了一点放远放宽看的思维方式和气度!
欢迎大家阅读我的旧帖:
颠倒的行为
孩子与父母
学问及八卦 (小字体版)
小农工老光头大数据
破球鞋与人的尊严
善良的一家人
我的写作我的事
Reduce white lies but try more