近来,Transformer在CV领域遍地开花,取得了非常好的性能,指标屡创新高。但Transformer的性能距离最佳的CNN仍存在差距,不由产生出一种Transformer不过如此的感觉。
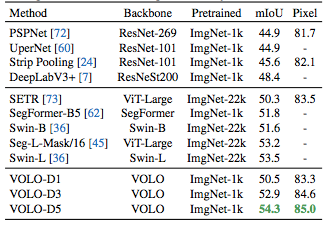
可是,就在今天,Transformer领域的新秀VOLO打破了Transformer无法打败最优CNN的宿命,成为了ImageNet数据上首个无需额外数据达到87.1%的模型;与此同时,VOLO在下游语义分割任上也创新了新记录,比如Cityscapes数据上的84.3%,ADE20K数据上的54.3%。
标题&作者团队
1摘要
视觉识别任务已被CNN主宰多年。基于自注意力的ViT在ImageNet分类方面表现出了极大的潜力,在没有额外数据前提下,Transformer的性能与最先进的CNN模型仍具有差距。在这项工作中,我们的目标是缩小这两者之间的性能差距,并且证明了基于注意力的模型确实能够比CNN表现更好。与此同时,我们发现限制ViTs在ImageNet分类中的性能的主要因素是其在将细粒度级别的特征编码乘Token表示过程中比较低效,为了解决这个问题,我们引入了一种新的outlook注意力,并提出了一个简单而通用的架构,称为Vision outlooker (VOLO)。outlook注意力主要将fine-level级别的特征和上下文信息更高效地编码到token表示中,这些token对识别性能至关重要,但往往被自注意力所忽视。实验表明,在不使用任何额外训练数据的情况下,VOLO在ImageNet-1K分类任务上达到了87.1%的top-1准确率,这是第一个超过87%的模型。此外,预训练好的VOLO模型还可以很好地迁移到下游任务,如语义分割。我们在Cityscapes验证集上获得了84.3% mIoU,在ADE20K验证集上获得了54.3%的mIoU,均创下了最新记录。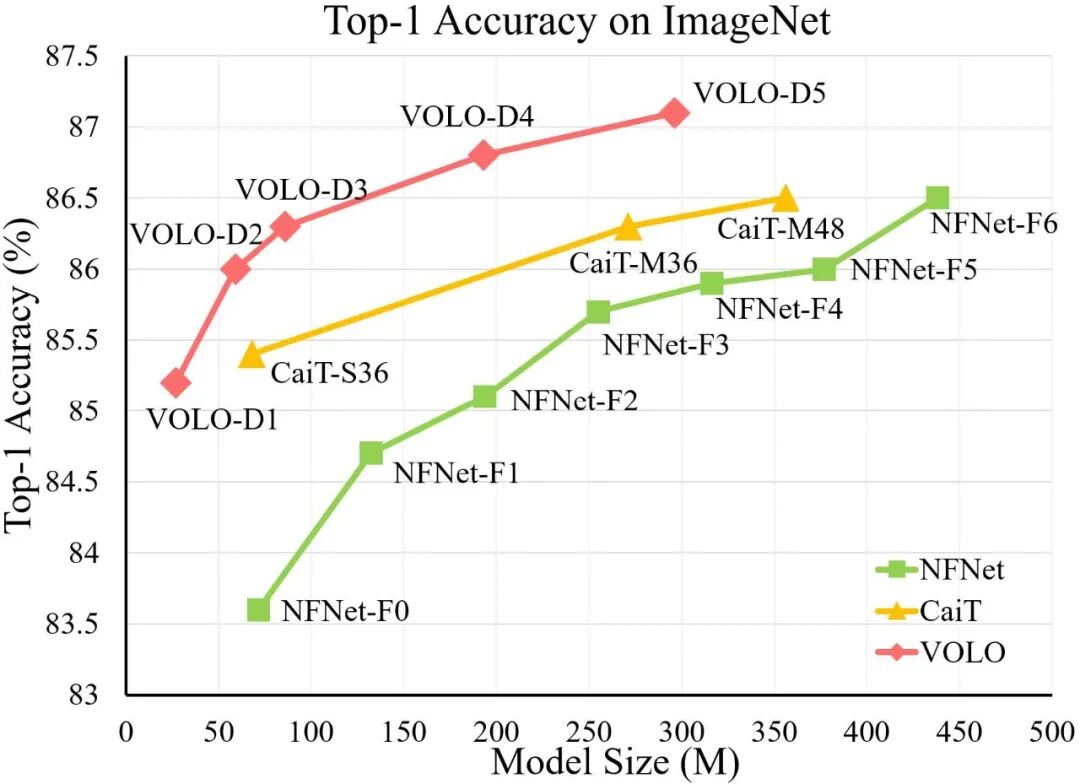
2方法
VOLO可以看作是一个具有两个独立阶段的结构。第一阶段多个用于生成细粒度token表示的Outlookers。第二阶段我们部署一系列Transformer block来聚合全局信息。在每个阶段的最开始,使用一个patch embedding模块将输入映射到期望形状大小的的token表示中。2.1 Outlooker
outlook包括用于空间信息编码的outlook注意力层和用于通道间信息交互的多层感知器(MLP)。给定输入token表示序列, outlooker可以写成如下:
2.2 Outlook attention
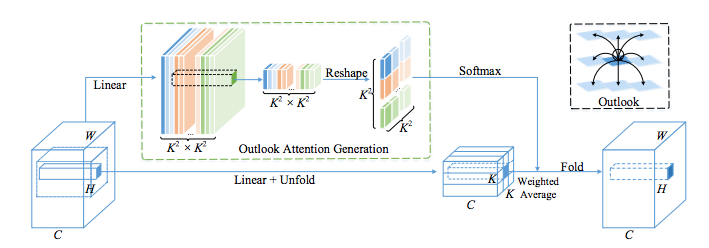
如上图所示,Outlook attention简单,高效,易于实现。它的主要创新点就是:
每个空间位置上的特征足够全面,可以聚集其邻近特征然后生成局部注意力权值;
稠密的局部空间聚合可以高效的编码细粒度信息。
对于每个空间位置, outlook注意力计算以为中心的大小为 的局部窗口内所有邻近结点的相似度。不同于自我注意力需要一个Query-Key矩阵乘法来计算注意力,outlook直接通过一个简单的reshape操作来简化这个过程。具体来说,输入 每个 token使用两个线性层
进行映射得到outlook权重, value表示,然后我们用来表示在以为中心的局部窗口的所有value:
最后,在位置的outlook 权重可以直接用作注意力权值,首先可以通过一个reshape操作()后接Softmax:
outlook 注意力将特征进行聚集映射,即将同一位置的不同加权值相加得到输出:
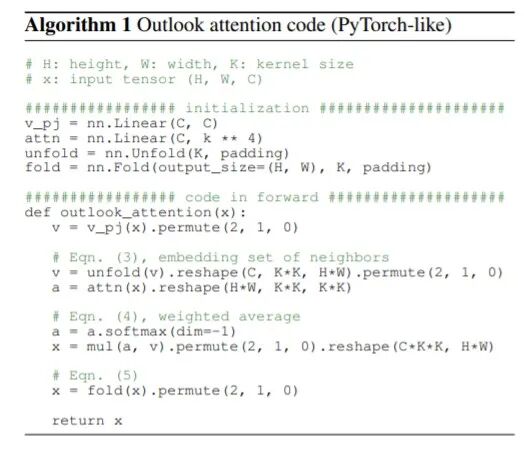
下图给出了Pytorch风格的伪代码实现,其中Eqn3,Eqn4, Eqn5对应上面三个公式。
2.4 Multi-Head Outlook Attention
多头Outlook注意力的实现非常简单,假设头数为N。我们仅需调节的形状为。因此,outlook权值与值嵌入被均匀的拆分为N份:。对于每对,Outlook注意力分别计算后并结果拼接构成多头Outlook注意力的输出。
2.5 Discuss
outlook attention继承了卷积和自我注意力的优点。具体如下:
- outlook注意力通过度量每对标记表示之间的相似性来对空间信息进行编码,在特征学习方面比卷积更具有参数效率;
- outlook attention采用滑动窗口方式,在细粒度级别实现了对标记表示进行局部编码,并在一定程度上保留视觉任务的关键位置信息;
- outlook产生注意力权重的方法简单有效。与依赖于query-key矩阵乘法的自我注意力不同,我们的outlook权重可以通过一个简单的reshape操作直接产生,节省计算。具体示例如下:我们比较了在滑动窗口大小为, token大小为上计算参数量:
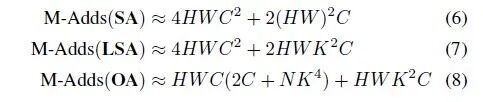
可以看到,当C=384,K=3,N=6时,因为,,所以outlook attention在计算资源利用上更高效。
3模型架构
主要借鉴了LV-ViT模型,VOLO的具体设置如下:为了获取到细粒度的token表示,在第一阶段,我们首先调整patch嵌入模块,使其在大小为的小图像patch上进行标记序列化,而不是 。然后通过堆叠一系列Outlookers生成更具细粒度特征表达能力的token表示。第二阶段,利用另一个patch embedding 模块对标记进行下采样。然后采用一组Transformer block对全局信息进行编码。我们基于VOLO提出了五个版本: VOLO: VOLO-D1, VOLO-D2,VOLO-D3, VOLO-D4, and VOLO-D5. 具体详细结构及配置信息如表2,表3所示: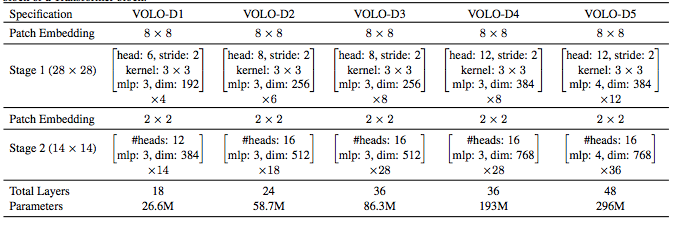
4实验结果
我们首先在ImageNet上进行了所提方法的性能对比,然后在下游任务上进行迁移能力对比。
4.1 ImageNet Classification
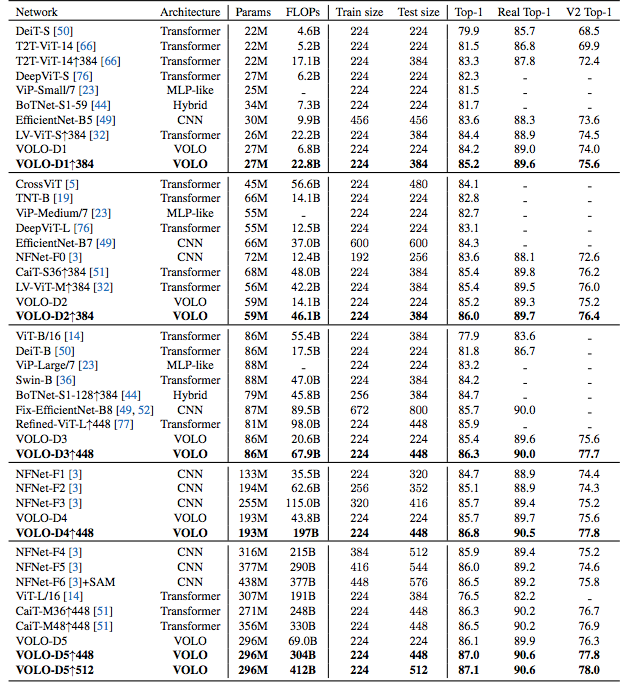
如上表所示,在不同的模型尺寸水平上,我们提出的VOLO取得了比当前最先进的模型更佳的性能。具体如下:
4.2 Semantic Segmantation
接下来,我们以前述预训练模型在语义分割任务上进行迁移能力验证。
如下表9所示,在Cityscapes数据上,所提方法超过了其他所有方法,包含最近的SegFormer-B5. 所提VOLO-D4+UperNet取得了当前最佳84.3%,以0.3%指标优于此前最佳,创造了Cityscapes验证集的新记录。
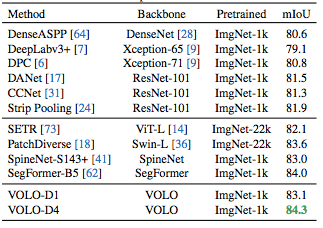
如下表10所示,在ADE20K数据集上,所提方法同样取得了超过其他所有方法的性能。VOLO-D5取得了54.3%的指标,同样刷新了ADE20K数据集上的记录。
4.3 Ablation Analysis
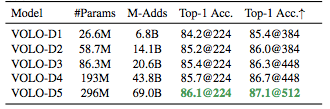
上表对比了模型缩放的性能影响,从中可以看到:
- 模型缩放有助于提升模型性能,比如VOLO-D1到VOLO-D2可以带来1%的性能提升,VOLO-D5可以带来额外的1%提升;
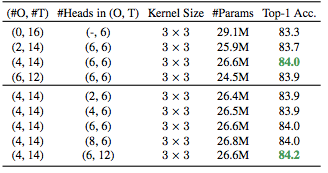
上表对比了,Outlooker数量与头数的影响对比,从中可以看到:
- 当步采用Outlooker时,基线模型的性能为83.3%,添加Outlooker可以提升模型型性能,当增加到4时性能达到饱和。Outlooker与Transformer的比例约为1:3时取得最佳性能。
- Outlooker中使用更多的头可以带来轻微的性能提升且几乎不会造成额外参数量提升。
5总结
本文亮点总结
1. 本文发现,限制ViT在ImageNet分类方面性能的主要原因在于其将细粒度特征编码为词表达过程的低效性。2. VOLO可以视作两阶段架构,第一个阶段包含多个用于生成细粒度词表达的Outlookers;第二个阶段采用transformer序列集成全局信息。3. 无需任务额外训练数据,VOLO成为ImageNet分类任务上首个达到87.1%top1精度的模型。预训练VOLO在下游任务上的迁移能力也非常好,在语义分割任务中,在ADE20K验证集上达到了54.3%,在Cityscapes验证集上达到了84.3%的mIoU指标,均创下了新记录。
Well,今天的分享就到此结束,更多论文相关的交流学习可到迈微微信交流群,跟同伴一些学习交流。
备注:姓名-学校/公司-研究方向-城市
(如:小C-北大-目标检测-北京)
じゃあ、お疲れ様です!更多细节可参考论文原文。
- END -



