深度学习各类优化器
借用古代炼丹的一些名词,我们可以把训练模型中的数据比做炼丹药材,模型比做炼丹炉,火候比做优化器。那么我们知道,同样的药材同样的炼丹炉,但是火候不一样的话,炼出来的丹药千差万别,同样的对于深度学习中训练模型而言,有时候模型性能不好,也许不是数据或者模型本身的原因,而是优化器的原因。由此可见优化器对于深度学习来说是多么重要了,那么今天小编就带大家了解一些常见的优化器。
优化算法设计原理
深度学习中的优化算法采用的原理是梯度下降法,即最小化目标函数 ,最优化的求解过程,首先求解目标函数的梯度 ,然后将参数 向负梯度方向更新,, 为学习率,表明梯度更新的步伐的大小,最优化的过程依赖的算法称为优化器,可以看出深度学习优化器的两个核心是梯度与学习率,前者决定参数更新的方向,后者决定参数的更新程度。
我们定义 为待优化的参数, 为目标函数,初始学习率为 。再进行一次梯度下降过程中优化算法的执行框架如下:
1、计算目标函数关于当前参数的梯度:
2、根据需要计算历史梯度的一阶和二阶动量:
3、计算当前时刻的下降梯度:
4、进行梯度下降更新
对于各种优化器而言,步骤 和步骤 都是一样的,主要差别是体现在步骤 和步骤 ,下面我们就来具体讲解这些优化器的设计思路。
非自适应优化器
在优化过程中,学习率全程不变,或者按照一定的 随时间变化,称之为非自适应优化器,这类包括最常见的 (随机梯度下降法),带 的 、带 的 等。
1、( )
其梯度更新公式为:
在每次更新梯度的时候,采用整个训练集的数据来计算 对参数的梯度,所以计算起来非常慢,遇到很大量的数据集也会非常棘手,而且不能投入新数据实时更新模型。
2、 随机梯度下降法( )
其梯度更新公式和 类似。
的梯度下降过程,类似于一个小球从山坡上滚下,它的前进方向只于当前山坡的最大倾斜方向一致(最大负梯度方向),每一个时刻的初速度为 0。梯度更新规则为: 每次更新时对一个 内每个样本进行梯度更新,这样使得网络更新参数速度很快。但是其缺点也很明显,因为 更新梯度非常频繁,会造成 会有严重的震荡,有可能在全局最小值处来回震荡跳出全局最优值。
3、( )
其实我们更多时候把 称之为 ,其梯度更新公式和 类似。梯度更新规则为: 每一次利用一个 样本,即 个样本进行计算,这样它可以降低参数更新时的方差,收敛更稳定,另一方面可以充分地利用深度学习库中高度优化的矩阵操作来进行更有效的梯度计算。和 中 的区别是每一次循环梯度更新的时候不是使用每个样本,而是一个 内的 个样本。在下面文章中提到的 就指代这里的 。
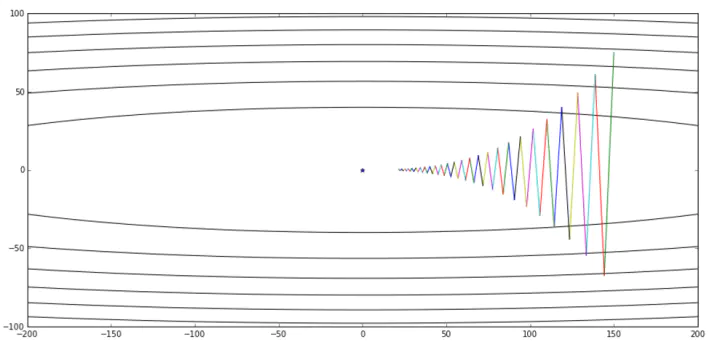 图 更新时的梯度变化
优点:
1、虽然看起来在更新过程中 的 波动非常大,会走很多弯路,但是对梯度的要求很低(计算梯度快),而且对于引入噪声,大量的理论和实践工作证明,只要噪声不是特别大, 都能很好地收敛。
2、应用大型数据集时,训练速度很快。比如每次从百万数据样本中,取几百个数据点,算一个 梯度,更新一下模型参数。相比于标准梯度下降法的遍历全部样本,每输入一个样本更新一次参数,要快得多。
缺点:
1、不能保证很好的收敛性;- 每次仅使用数据集中的一部分进行梯度下降,所以每次下降并不是严格按照朝最小方向下降,只是总体下降趋势是朝着最小方向,极度容易陷于局部最小值。
2、 如果太小,收敛速度会很慢,如果太大, 就会在极小值处不停地震荡甚至偏离。(有一种措施是先设定大一点的学习率,当两次迭代之间的变化低于某个阈值后,就减小 ,不过这个阈值的设定需要提前写好,但这样的话就不能够适应数据集的特点)。
3、对于非凸函数,还要避免陷于局部极小值处,或者鞍点处,因为鞍点周围的梯度都接近于 , 很容易被困在这里。在这里解释一下鞍点就是:一个光滑函数的鞍点邻域的曲线,曲面,或超曲面,都位于这点的切线的不同边。如下图 所示。
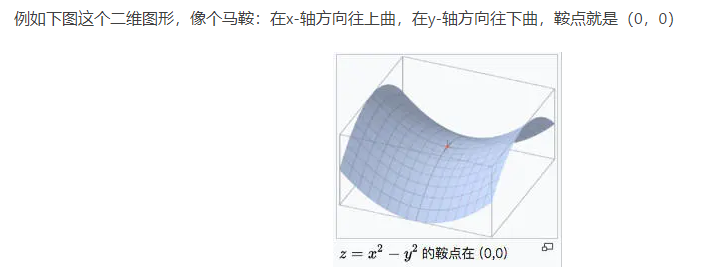 图 鞍点示意图
4、(带有 动量的 )
为了解决在上面的优化算法中容易出现的问题, 应用而生,在原有的 上加入了一阶动量,从直观理解就是加入了一个惯性,在坡度比较陡的地方,会有较大的惯性,下降的就会比较快;坡度平缓的地方,惯性较小,下降的会比较慢。
其梯度更新公式为:
通过加入 ,将其定义为动量, 常用的值为 。使用动量后在梯度下降过程中可以使得梯度方向不变的方向上下降速度变快,梯度方向有所改变的方向上的下降速度变慢。在这里我们举一个比较贴近的例子:在原本的梯度下降中一直朝着一个方向去下降,而当遇到山沟的时候(也就是一个拐点),越过山沟此时就在另一边山坡,这个时候梯度方向是跟之前相反的,此时由于之前梯度大小的累加,在两个山坡间的变化就会被互相抵消掉,也就不会一直在两个山坡振荡,容易朝山沟向下走,也就是会减少震荡。 的梯度更新时的状态如下图 所示,和图
相比,震荡明显减少。
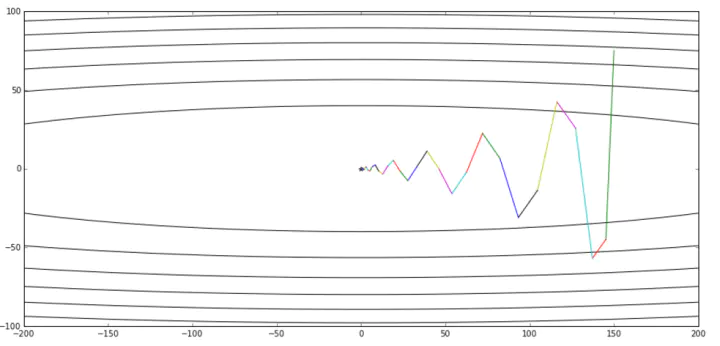 图 更新时的梯度变化
5、( )
上面介绍的 的每下降一步都是由前面下降方向的一个累积和当前点的梯度方向组合而成,但当刚好下降到拐点附近时,如果这个时候继续以这样的方式更新参数,我们会有一个较大的幅度越过拐点,即:模型遇到拐点不会自动减弱更新的幅度。NAG 针对上述问题对动量方法进行了改进,其表达式如下:
利用当前位置处先前的梯度值先做一个参数更新,然后在更新后的位置再求梯度,将此部分梯度跟之前累积下来的梯度值矢量相加,简单的说就是先根据之前累积的梯度方向模拟下一步参数更新后的值,然后将模拟后的位置处梯度替换动量方法中的当前位置梯度。那么这种方式为什么解决了之前说的那个问题呢?因为 有一个预测后一步位置梯度的步骤,所以当下降到拐点附近时, 预测到会跨过拐点,该项梯度就会对之前梯度有个修正,相当于阻止了其跨度太大。
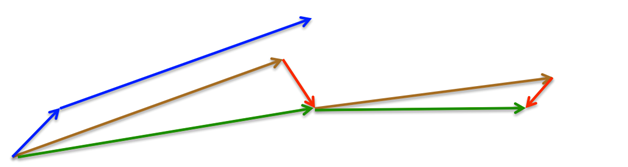 图
如上图 所示,我们举个例子来简单示意一下 的更新原理,其中蓝色线表示方法,蓝色短线表示当前位置梯度更新,蓝色长线表示之前累积的梯度;第一个红色线表示用 算法预测下一步位置的梯度更新,第一条棕色线表示先前累积的梯度,其矢量相加结果(绿色线)就是参数更新的方向。 在更新梯度时的状态图如下图 所示,从图中可以看出,相对于 和 , 表现出来的性能更好。
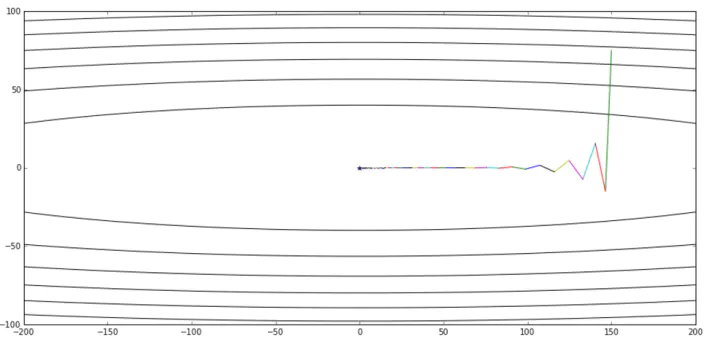 图 更新时的梯度变化
自适应优化器
在优化过程中,学习率随着梯度自适应的变化,并尽可能去消除给定的全局学习率的影响,叫做自适应优化器,常见的包括 、、、 等。
1、
其实是对学习率进行了一个约束,对于经常更新的参数,我们已经积累了大量关于它的知识,不希望被单个样本影响太大,希望学习速率慢一些;对于偶尔更新的参数,我们了解的信息太少,希望能从每个偶然出现的样本身上多学一些,即学习速率大一些。而该方法中开始使用二阶动量,意味着“自适应学习率”优化算法时代的到来。
在这里我们说明一下二阶动量 的定义:它是用来度量参数历史更新频率的,二阶动量是迄今为止所有梯度值的平方和。 的表达式为:
其中 为 时刻参数梯度,下面来讲解为什么 可以实现不同频率特征对其参数学习率改变。首先,我们看到二阶动量 ,它是梯度平方累加和,对于训练数据少的特征,自然对应的参数更新就缓慢,也就是说他们的梯度变化平方累加和就会比较小,所以对应于上面参数更新方程中的学习速率就会变大,因而对于某个特征数据集少,相应参数更新速度就快。为了防止上述分母为 ,所以往往添加一个平滑项参数 ,参数更新方程也就变成:
但是 同样也有问题,就是其分母随着训练数增加,也会跟着增加,这样会导致学习速率越来越小,最终无限接近于
,从而无法有效更新参数。
2、
针对于 的缺点, 对二阶动量 进行了改进,和 相比,就是分母换成了过去的梯度平方的衰减平均值,这个分母相当于梯度的均方根值 ( )。其表达式如下:
其中对梯度的二阶动量变化为 ;对变量的变化量的二阶动量为 ,并使用其将其替换学习率。通过 优化算法,我们甚至可以不需要设置一个默认的学习率,因为在新的规则中已经移除了这项。
3、
和 都是为了解决 学习率急剧下降问题而被提出来的。 与 的计算公式非常相似,只不过在相同的时间内被独立的提出,其表达式为:
由此可以看出, 还需要自己手动设置一个初始的学习率 。作者建议将 设置为 0.9,学习率 设置为 0.001。
4、(
)
算法是另一种计算每个参数的自适应学习率的方法。它是一种将动量 和 结合起来的办法方法,同时引入了两个参数 和 ,其表达式为:
其中 默认值为 , 默认值为 , 为 , 集合了动量和 两者的优点,从经验中表明 在实际中表现很好,同时与其他自适应学习算法相比,更有优势。
总结
我们来看一下上面几种优化算法在鞍点和等高线上的表现:
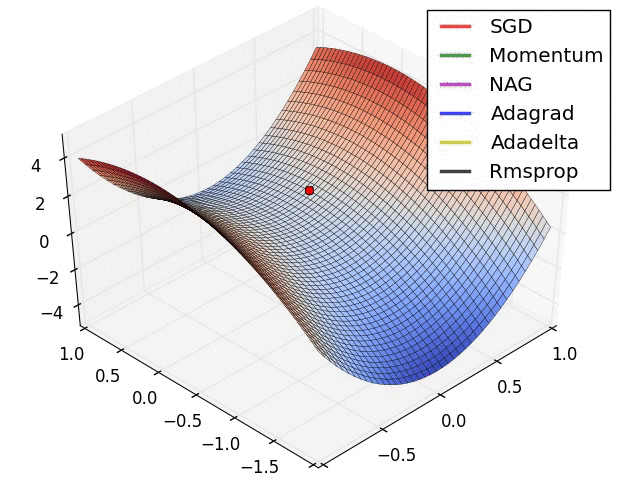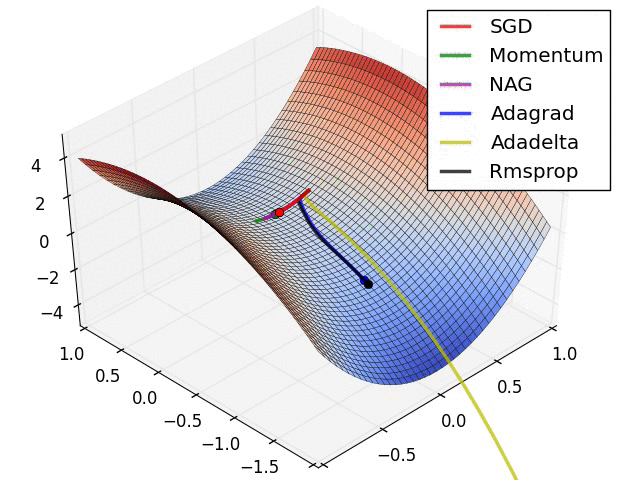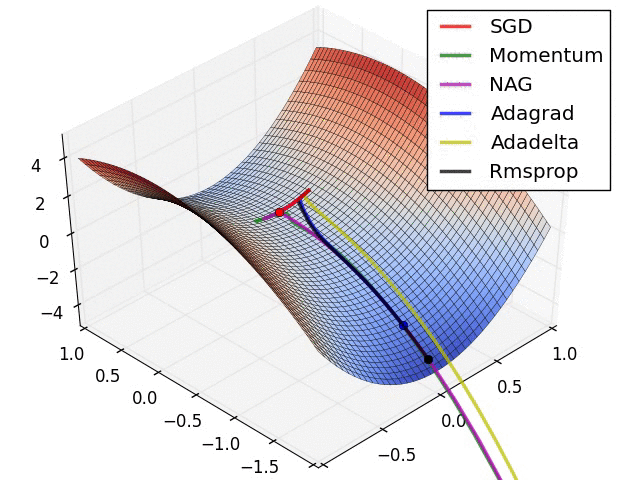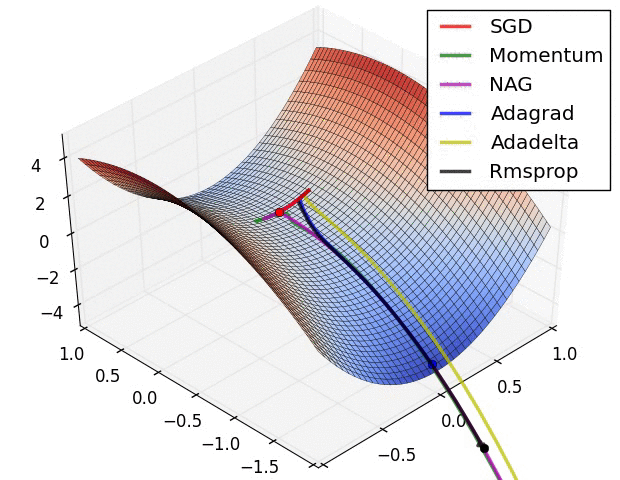 图 各个优化算法在鞍点处表现
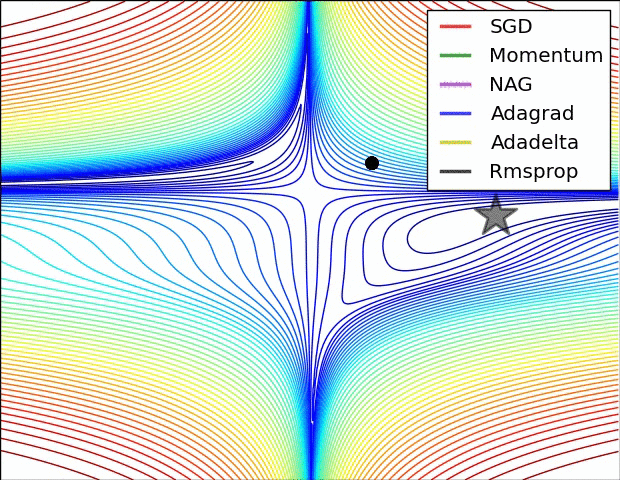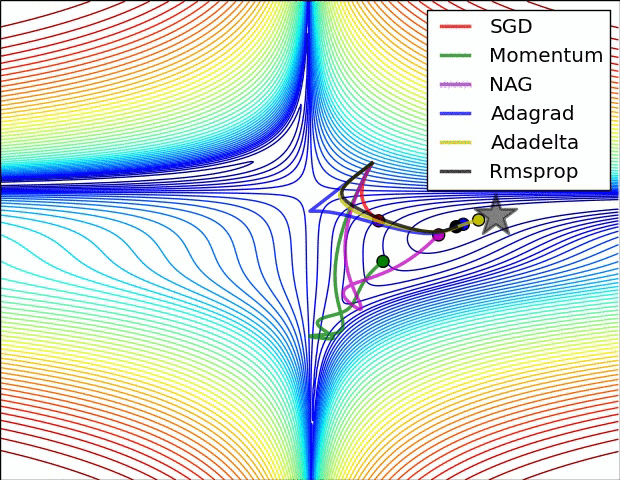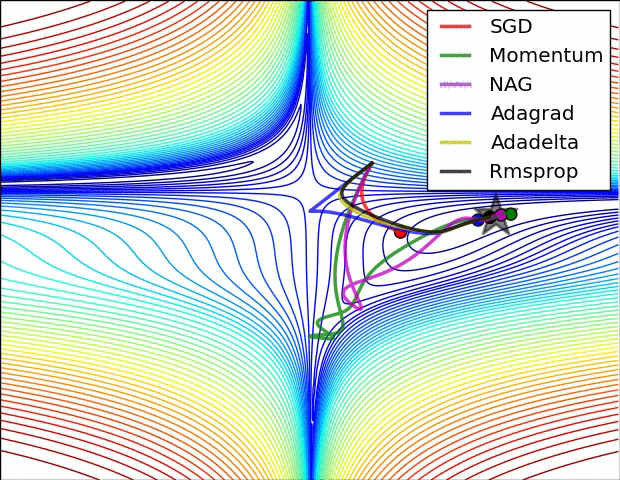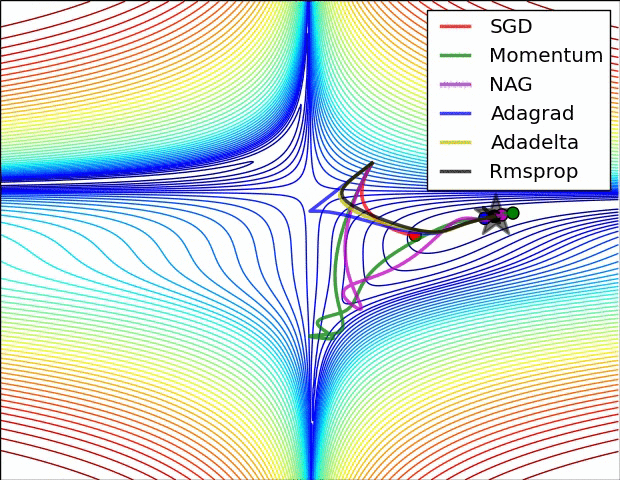 图 各个优化算法在等高线表现
从图 6 和图 7 都可以看出,、、 几乎很快就找到了正确的方向并前进,收敛速度也相当快,而其它方法要么很慢,要么走了很多弯路才找到。
关于优化器如何选择的问题上,小编也综合网上的办法给出以下建议:
1、首先,各大算法孰优孰劣并无定论。如果是刚入门,优先考虑 + 或者 。
2、 等自适应学习率算法对于稀疏数据具有优势,且收敛速度很快;但精调参数的 往往能够取得更好的最终结果。
3、根据你的需求来选择——在模型设计实验过程中,要快速验证新模型的效果,可以先用 进行快速实验优化;在模型上线或者结果发布前,可以用精调的 系列优化算法进行模型的极致优化。
4、考虑不同算法的组合。先用 进行快速下降,而后再换到 系列优化算法进行充分的调优。
引用
- https://www.jianshu.com/p/a63858bcf455
- https://www.cnblogs.com/guoyaohua/p/8542554.html
- https://blog.csdn.net/u013385018/article/details/92377371
- https://blog.csdn.net/qq_42109740/article/details/105401197
- https://blog.csdn.net/tsyccnh/article/details/76673073



