编译 | VK
来源 | Towards Data Science
创建一个PyTorch数据集并使用Dataloader对其进行管理,并有助于简化机器学习流程。Dataset存储所有数据,而Dataloader可用于迭代数据、管理批处理、转换数据等等。
import pandas as pd
import torch
from torch.utils.data import Dataset, DataLoader
Pandas对于创建数据集对象不是必需的。不过,它是管理数据的强大工具,所以我将使用它。
torch.utils.data导入创建和使用Dataset和DataLoader所需的函数。
class CustomTextDataset(Dataset):
    def __init__(self, txt, labels):
        self.labels = labels
        self.text = text

def __len__(self):
        return len(self.labels)

def __getitem__(self, idx):
        label = self.labels[idx]
        text = self.text[idx]
        sample = {"Text": text, "Class": label}
        return sample
class CustomTextDataset(Dataset):创建一个名为“CustomTextDataset”的类,可以任意调用。传入类的是我们前面导入的数据集模块。
def init(self, text, labels):初始化类时需要导入两个变量。在这种情况下,变量被称为“Text”和“Class”,以匹配将要添加的数据。
self.labels = labels & self.text = text:导入的变量现在可以使用self.text或self.labels在类内的函数中使用。
def len(self):这个函数在调用时只返回标签的长度。例如,如果你有一个带有5个标签的数据集,那么将返回整数5。
def getitem(self, idx):这个函数被Pytorch的Dataset模块用来获取样本并构建数据集。初始化时,它将通过此函数循环,从数据集中的每个实例创建一个样本。
传递给函数的“idx”是一个数字,这个数字是数据集将遍历的数据实例。我们使用self.labels和self.text提到的文本变量与“idx”变量一起传入,以获得当前的数据实例。这些当前实例被保存在变量' label '和' data '中。
接下来,声明一个名为‘sample’的变量,其中包含一个存储数据的字典。在用数据初始化这个类之后,它将包含许多标记为“Text”和“Class”的数据实例。你可以命名“Text”和“Class”任何东西。
# 定义数据和类标签
text = ['Happy', 'Amazing', 'Sad', 'Unhapy', 'Glum']
labels = ['Positive', 'Positive', 'Negative', 'Negative', 'Negative']

# 创建数据帧
text_labels_df = pd.DataFrame({'Text': text, 'Labels': labels})

# 定义数据集对象
TD = CustomTextDataset(text_labels_df['Text'],                               text_labels_df['Labels'])
首先,我们创建两个名为“text”和“labels”的列作为示例。
text_labels_df = pd.DataFrame({‘Text’: text, ‘Labels’: labels}):不是必需的,但是Pandas是数据管理和预处理的有用工具,可能会在PyTorch管道中使用。在本节中,包含数据的列表“Text”和“Labels”保存在数据框中。
TD = CustomTextDataset(text_labels_df[‘Text’], text_labels_df[‘Labels’]):这将初始化我们前面创建的类,并传入'text'和'labels'数据。此数据将在类中变为“self.text”和“self.labels”。数据集保存在名为TD的变量下。
数据集现在已经初始化,可以使用了!
这将向你展示数据是如何存储在数据集中的。
# 显示文本和标签。
print('\nFirst iteration of data set: ', next(iter(TD)), '\n')
# 打印数据集中的项目数
print(
'Length of data set: ', len(TD), '\n')
# 打印整个数据集
print('Entire data set: ', list(DataLoader(TD)), '\n')
输出:
数据集的第一次迭代:{'Text':'Happy','Class':'Positive'}
数据集长度:5
整个数据集:[{‘Text’: [‘Happy’], ‘Class’: [‘Positive’]}, {‘Text’: [‘Amazing’], ‘Class’: [‘Positive’]}, {‘Text’: [‘Sad’], ‘Class’: [‘Negative’]}, {‘Text’: [‘Unhapy’], ‘Class’: [‘Negative’]}, {‘Text’: [‘Glum’], ‘Class’: [‘Negative’]}]
使用“collate_fn”预处理数据
在机器学习或深度学习中,在训练之前需要对文本进行清理并将其转化为向量。DataLoader有一个方便的参数collate_fn。此参数允许你创建单独的数据处理函数,并在输出数据之前将该函数中的处理应用于数据。
def collate_batch(batch):

    word_tensor = torch.tensor([[1.], [0.], [45.]])
    label_tensor = torch.tensor([[1.]])

    text_list, classes = [], []

    for (_text, _class) in batch:
        text_list.append(word_tensor)
        classes.append(label_tensor)

     text = torch.cat(text_list)
     classes = torch.tensor(classes)

     return text, classes

DL_DS = DataLoader(TD, batch_size=2, collate_fn=collate_batch)
例如,创建了两个表示单词和类的张量。实际上,这些可以是通过另一个函数传入的单词向量。然后将批处理解包,然后将单词和标签张量添加到列表中。
然后将单词张量串联起来,并将类张量列表(在本例中为1)组合成单个张量。该函数现在将返回已处理的文本数据,以便进行训练。
要激活此函数,只需在初始化DataLoader对象时添加参数collate_fn=Your_Function_name。
我们将在不使用collate_fn的情况下遍历数据集,因为它更容易看到DataLoader如何输出单词和类。如果上述函数与collate_fn一起使用,则输出将是张量。
DL_DS = DataLoader(TD, batch_size=2, shuffle=True)

for (idx, batch) in enumerate(DL_DS):

    # 打印batch中的“text”数据
    print(idx, 'Text data: ', batch['Text'])

    # 打印batch中的"Class”数据
    print(idx, 'Class data: ', batch['Class'], '\n')
DL_DS = DataLoader(TD, batch_size=2, shuffle=True) :这用我们刚刚创建的Dataset对象“TD”初始化DataLoader。
在本例中,批大小设置为2。这意味着当你遍历数据集时,DataLoader将输出2个数据实例,而不是一个。有关批处理的更多信息,请参阅本文:https://machinelearningmastery.com/difference-between-a-batch-and-an-epoch/。Shuffle将在每个epoch对数据进行随机化,这将阻止模型学习训练数据的顺序。
for (idx, batch) in enumerate(DL_DS): 遍历我们刚刚创建的DataLoader对象中的数据。enumerate(DL_DS)返回批的索引号和由两个数据实例。
输出:
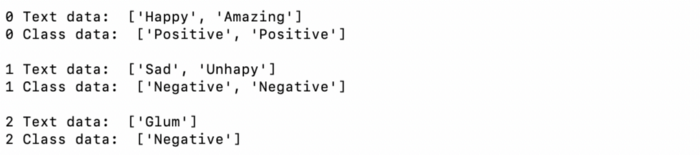
如你所见,我们创建的5个数据实例是以2个为一个batch的方式输出的。由于我们有奇数个训练示例,最后一个batch大小是1。
完整代码
# 导入库
import pandas as pd
import torch
from torch.utils.data import Dataset, DataLoader
# 创建自定义数据集类
class CustomTextDataset(Dataset):
def __init__(self, text, labels):
self.labels = labels
self.text = text
def __len__(self):
return len(self.labels)
def __getitem__(self, idx):
label = self.labels[idx]
data = self.text[idx]
sample = {"Text": data, "Class": label}
return sample
# 定义数据和类标签
text = ['Happy', 'Amazing', 'Sad', 'Unhapy', 'Glum']
labels = ['Positive', 'Positive', 'Negative', 'Negative', 'Negative']
# 创建Pandas DataFrame
text_labels_df = pd.DataFrame({'Text': text, 'Labels': labels})
# 定义数据集对象
TD = CustomTextDataset(text_labels_df['Text'], text_labels_df['Labels'])
# 显示图像和标签
print('\nFirst iteration of data set: ', next(iter(TD)), '\n')
# 打印数据集中有多少项
print('Length of data set: ', len(TD), '\n')
# 打印整个数据集
print('Entire data set: ', list(DataLoader(TD)), '\n')
# collate_fn
def collate_batch(batch):
word_tensor = torch.tensor([[1.], [0.], [45.]])
label_tensor = torch.tensor([[1.]])
text_list, classes = [], []
for (_text, _class) in batch:
text_list.append(word_tensor)
classes.append(label_tensor)
text = torch.cat(text_list)
classes = torch.tensor(classes)
return text, classes
# 创建数据集对象的DataLoader对象
bat_size = 2
DL_DS = DataLoader(TD, batch_size=bat_size, shuffle=True)
# 循环遍历DataLoader对象中的每个batch
for (idx, batch) in enumerate(DL_DS):
# 打印“text”数据
print(idx, 'Text data: ', batch, '\n')
# 打印“Class”数据
print(idx, 'Class data: ', batch, '\n')



