今天我们将使用 Pytorch 来实现 LeNet-5 模型,并用它来解决 MNIST数据集的识别。
正文开始!
一、使用 LeNet-5 网络结构创建 MNIST 手写数字识别分类器
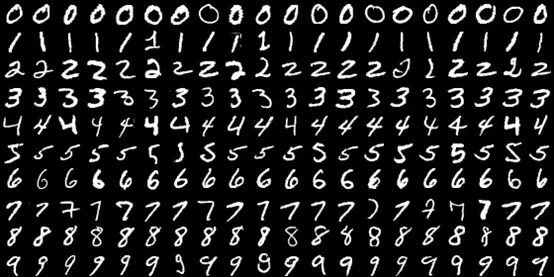
MNIST是一个非常有名的手写体数字识别数据集,训练样本:共60000个,其中55000个用于训练,另外5000个用于验证;测试样本:共10000个。MNIST数据集每张图片是单通道的,大小为28x28。
1.1 下载并加载数据,并做出一定的预先处理
由于 MNIST 数据集图片尺寸是 28x28 单通道的,而 LeNet-5 网络输入 Input 图片尺寸是 32x32,因此使用 transforms.Resize 将输入图片尺寸调整为 32x32。
首先导入 PyToch 的相关算法库:
import torchimport torch.nn as nnimport torch.nn.functional as Fimport torch.optim as optimfrom torchvision import datasets, transformsimport timefrom matplotlib import pyplot as plt
pipline_train = transforms.Compose([ #随机旋转图片 transforms.RandomHorizontalFlip(), #将图片尺寸resize到32x32 transforms.Resize((32,32)), #将图片转化为Tensor格式 transforms.ToTensor(), #正则化(当模型出现过拟合的情况时,用来降低模型的复杂度) transforms.Normalize((0.1307,),(0.3081,)) ])pipline_test = transforms.Compose([ #将图片尺寸resize到32x32 transforms.Resize((32,32)), transforms.ToTensor(), transforms.Normalize((0.1307,),(0.3081,))])#下载数据集train_set = datasets.MNIST(root="./data", train=True, download=True, transform=pipline_train)test_set = datasets.MNIST(root="./data", train=False, download=True, transform=pipline_test)#加载数据集trainloader = torch.utils.data.DataLoader(train_set, batch_size=64, shuffle=True)testloader = torch.utils.data.DataLoader(test_set, batch_size=32, shuffle=False)
这里要解释一下 Pytorch MNIST 数据集标准化为什么是 transforms.Normalize((0.1307,), (0.3081,))?
标准化(Normalization)是神经网络对数据的一种经常性操作。标准化处理指的是:样本减去它的均值,再除以它的标准差,最终样本将呈现均值为 0 方差为 1 的数据分布。
神经网络模型偏爱标准化数据,原因是均值为0方差为1的数据在 sigmoid、tanh 经过激活函数后求导得到的导数很大,反之原始数据不仅分布不均(噪声大)而且数值通常都很大(本例中数值范围是 0~255),激活函数后求导得到的导数则接近与 0,这也被称为梯度消失。所以说,数据的标准化有利于加快神经网络的训练。
除此之外,还需要保持 train_set、val_set 和 test_set 标准化系数的一致性。标准化系数就是计算要用到的均值和标准差,在本例中是((0.1307,), (0.3081,)),均值是 0.1307,标准差是 0.3081,这些系数都是数据集提供方计算好的数据。不同数据集就有不同的标准化系数,例如([0.485, 0.456, 0.406], [0.229, 0.224, 0.225])就是 ImageNet dataset 的标准化系数(RGB三个通道对应三组系数),当需要将 Imagenet 预训练的参数迁移到另一神经网络时,被迁移的神经网络就需要使用 Imagenet的系数,否则预训练不仅无法起到应有的作用甚至还会帮倒忙。
1.2 搭建 LeNet-5 神经网络结构,并定义前向传播的过程
class LeNet(nn.Module):    def __init__(self):        super(LeNet, self).__init__()        self.conv1 = nn.Conv2d(1, 6, 5)         self.relu = nn.ReLU()        self.maxpool1 = nn.MaxPool2d(2, 2)        self.conv2 = nn.Conv2d(6, 16, 5)        self.maxpool2 = nn.MaxPool2d(2, 2)        self.fc1 = nn.Linear(16*5*5, 120)        self.fc2 = nn.Linear(120, 84)        self.fc3 = nn.Linear(84, 10)
    def forward(self, x):        x = self.conv1(x)        x = self.relu(x)        x = self.maxpool1(x)        x = self.conv2(x)        x = self.maxpool2(x)        x = x.view(-1, 16*5*5)        x = F.relu(self.fc1(x))        x = F.relu(self.fc2(x))        x = self.fc3(x)        output = F.log_softmax(x, dim=1)        return output
1.3 将定义好的网络结构搭载到 GPU/CPU,并定义优化器
#创建模型,部署gpudevice = torch.device("cuda" if torch.cuda.is_available() else "cpu")model = LeNet().to(device)#定义优化器optimizer = optim.Adam(model.parameters(), lr=0.001)
1.4 定义训练过程
def train_runner(model, device, trainloader, optimizer, epoch): #训练模型, 启用 BatchNormalization 和 Dropout, 将BatchNormalization和Dropout置为True model.train() total = 0
correct =0.0
#enumerate迭代已加载的数据集,同时获取数据和数据下标 for i, data in enumerate(trainloader, 0): inputs, labels = data #把模型部署到device上 inputs, labels = inputs.to(device), labels.to(device) #初始化梯度 optimizer.zero_grad() #保存训练结果 outputs = model(inputs) #计算损失和 #多分类情况通常使用cross_entropy(交叉熵损失函数), 而对于二分类问题, 通常使用sigmod loss = F.cross_entropy(outputs, labels) #获取最大概率的预测结果 #dim=1表示返回每一行的最大值对应的列下标 predict = outputs.argmax(dim=1) total += labels.size(0) correct += (predict == labels).sum().item() #反向传播 loss.backward() #更新参数 optimizer.step() if i % 1000 == 0: #loss.item()表示当前loss的数值 print("Train Epoch{} \t Loss: {:.6f}, accuracy: {:.6f}%".format(epoch, loss.item(), 100*(correct/total))) Loss.append(loss.item()) Accuracy.append(correct/total) return loss.item(), correct/total
1.5 定义测试过程
def test_runner(model, device, testloader): #模型验证, 必须要写, 否则只要有输入数据, 即使不训练, 它也会改变权值 #因为调用eval()将不启用 BatchNormalization 和 Dropout, BatchNormalization和Dropout置为False model.eval() #统计模型正确率, 设置初始值 correct = 0.0 test_loss = 0.0 total = 0 #torch.no_grad将不会计算梯度, 也不会进行反向传播 with torch.no_grad(): for data, label in testloader: data, label = data.to(device), label.to(device) output = model(data) test_loss += F.cross_entropy(output, label).item() predict = output.argmax(dim=1) #计算正确数量 total += label.size(0) correct += (predict == label).sum().item() #计算损失值 print("test_avarage_loss: {:.6f}, accuracy: {:.6f}%".format(test_loss/total, 100*(correct/total)))
1.6 运行
LeNet-5 网络模型定义好,训练函数、验证函数也定义好了,就可以直接使用 MNIST 数据集进行训练了。
# 调用epoch = 5Loss = []Accuracy = []for epoch in range(1, epoch+1):    print("start_time",time.strftime('%Y-%m-%d %H:%M:%S',time.localtime(time.time())))    loss, acc = train_runner(model, device, trainloader, optimizer, epoch)    Loss.append(loss)    Accuracy.append(acc)    test_runner(model, device, testloader)    print("end_time: ",time.strftime('%Y-%m-%d %H:%M:%S',time.localtime(time.time())),'\n')
print('Finished Training')plt.subplot(2,1,1)plt.plot(Loss)plt.title('Loss')plt.show()plt.subplot(2,1,2)plt.plot(Accuracy)plt.title('Accuracy')plt.show()
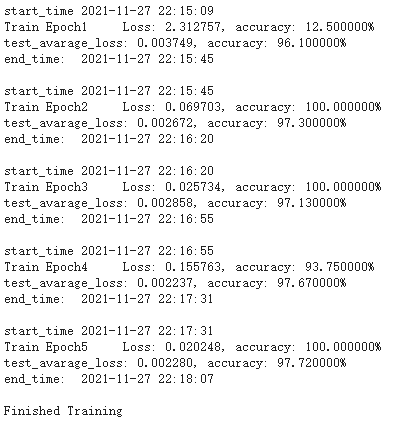
经历 5 次 epoch 的 loss 和 accuracy 曲线如下:
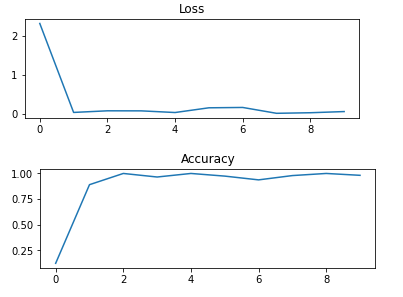
最终在 10000 张测试样本上,average_loss降到了 0.00228,accuracy 达到了 97.72%。可以说 LeNet-5 的效果非常好!
1.7 保存模型
print(model)torch.save(model, './models/model-mnist.pth') #保存模型
LeNet-5 的模型会 print 出来,并将模型模型命令为 model-mnist.pth 保存在固定目录下。
LeNet(
  (conv1): Conv2d(1, 6, kernel_size=(5, 5), stride=(1, 1))
  (relu): ReLU()
  (maxpool1): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  (conv2): Conv2d(6, 16, kernel_size=(5, 5), stride=(1, 1))
  (maxpool2): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  (fc1): Linear(in_features=400, out_features=120, bias=True)
  (fc2): Linear(in_features=120, out_features=84, bias=True)
  (fc3): Linear(in_features=84, out_features=10, bias=True)
)
1.8 手写图片的测试
下面,我们将利用刚刚训练的 LeNet-5 模型进行手写数字图片的测试。
import cv2
if __name__ == '__main__':    device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')    model = torch.load('./models/model-mnist.pth') #加载模型    model = model.to(device)    model.eval()    #把模型转为test模式
    #读取要预测的图片    img = cv2.imread("./images/test_mnist.jpg")    img=cv2.resize(img,dsize=(32,32),interpolation=cv2.INTER_NEAREST)    plt.imshow(img,cmap="gray") # 显示图片    plt.axis('off') # 不显示坐标轴    plt.show()
    # 导入图片,图片扩展后为[1,1,32,32]    trans = transforms.Compose(        [            transforms.ToTensor(),            transforms.Normalize((0.1307,), (0.3081,))        ])    img = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)#图片转为灰度图,因为mnist数据集都是灰度图    img = trans(img)    img = img.to(device)    img = img.unsqueeze(0)  #图片扩展多一维,因为输入到保存的模型中是4维的[batch_size,通道,长,宽],而普通图片只有三维,[通道,长,宽]        # 预测     output = model(img)    prob = F.softmax(output,dim=1) #prob是10个分类的概率    print("概率:",prob)    value, predicted = torch.max(output.data, 1)    predict = output.argmax(dim=1)    print("预测类别:",predict.item())
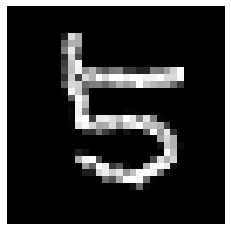
输出:
概率:tensor([[2.0888e-07, 1.1599e-07, 6.1852e-05, 1.5797e-04, 1.4975e-09, 9.9977e-01,
1.9271e-06, 3.1589e-06, 1.2186e-07, 4.3405e-07]],
grad_fn=)
预测类别:5
模型预测结果正确!
以上就是 PyTorch 构建 LeNet-5 卷积神经网络并用它来识别 MNIST 数据集的例子。全文的代码都是可以顺利运行的,建议大家自己跑一边。
所有完整的代码我都放在 GitHub 上,GitHub地址为:
https://github.com/RedstoneWill/ObjectDetectionLearner/tree/main/LeNet-5
也可以点击阅读原文进入~