什么是 ML.NET?
ML.NET 是 Microsoft 开源的针对 .NET 应用程序的 跨平台机器学习库,允许您使用 C#、F# 或任何其他 .NET 语言执行机器学习任务。此外,ML.NET 支持在其他机器学习框架中构建的模型,如TensorFlow,ONNX,PyTorch 等,它也具有极高的性能,可用于各种机器学习任务。
对于那些还没有深厚的数据科学技能和各种机器学习算法知识的人来说,ML.NET 还提供AutoML,Auto ML 是 ML.NET 的子集,它抽象出选择机器学习算法、为这些算法调整超参数以及相互比较算法以确定最佳性能的过程。这有助于刚接触数据科学的人找到一个表现良好的模型,而不需要更大的数据科学技能。
所有这些因素结合在一起,使 ML.NET 成为一种非常有效的方式,可以使用您已经拥有的应用程序和您已经知道的技能来处理机器学习任务。
安装 ML.NET
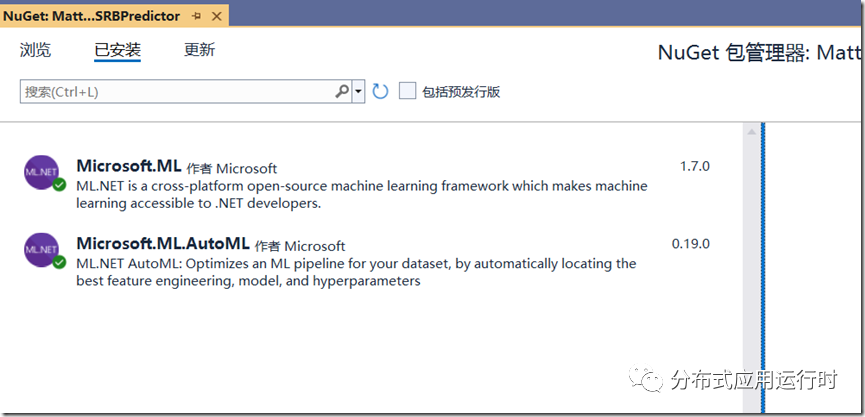
对于支持 .NET Standard 的任何项目,都可以通过 Visual Studio 中的 NuGet Package Manager 安装 ML.NET(几乎所有 .NET 项目都可以执行此操作)。如果要向项目添加 ML.NET,请转到 NuGet 包管理器并安装最新版本的 。我还建议您安装Microsoft.ML和Microsoft.ML.AutoML,因为AutoML是开始使用 ML.NET 的好方法。有关使用 NuGet 包管理器的更多详细信息,请参阅 Microsoft 的 NuGet 包管理器文档
支持自动ML的任务
首先,我将重点介绍使用 AutoML 支持的 ML.NET 五个机器学习任务。由于它们支持AutoML,因此这些任务更容易入门,因此我将为每种类型的任务提供一些代码。我建议最好查看Microsoft关于 ML.NET 的文档以获取更多详细信息,或者在GitHub上查看他们的 ML.NET 示例。
二元分类
二元分类任务涉及预测一个分类标签,该标签应分配给给定一组相关特征的某些内容。例如,给定贷款申请人的一些特征,二元分类模型将预测该贷款是否应被批准或拒绝。
二元分类任务仅限于预测具有两个可能值的单个列。如果有两个以上的可能值,则这是一个多类别分类任务,我们将在下面讨论。
使用 AutoML 运行二元分类试验的代码可能如下所示:
public ITransformer PerformBinaryClassification(IDataView trainingData, IDataView validationData)
{
// Set up the experiment
MLContext context = new MLContext();
uint maxSeconds = 10;
BinaryClassificationExperiment experiment = context.Auto().CreateBinaryClassificationExperiment(maxSeconds);
// Run the experiment and wait synchronously for it to complete
ExperimentResult result =
experiment.Execute(trainingData, validationData, labelColumnName: "ShouldApproveLoan");
// result.BestRun.ValidationMetrics has properties helpful for evaluating model performance
double accuracy = result.BestRun.ValidationMetrics.Accuracy;
double f1Score = result.BestRun.ValidationMetrics.F1Score;
string confusionTable = result.BestRun.ValidationMetrics.ConfusionMatrix.GetFormattedConfusionTable();
// Return the best performing trained model
ITransformer bestModel = result.BestRun.Model;
return bestModel;
}
然后,您可以使用该训练的模型通过以下代码进行预测:
public LoanPrediction PredictBinaryClassification(ITransformer bestModel, IDataView trainingData, LoanData loan)
{
MLContext context = new MLContext();
// Create an engine capable of evaluating one or more loans in the future
PredictionEngine engine =
context.Model.CreatePredictionEngine(bestModel, trainingData.Schema);
// Actually make the prediction and return the findings
LoanPrediction prediction = engine.Predict(loan);
return prediction;
}
此处 LoanData 和LoanPrediction 分别表示数据集中的行和算法的最终预测的类。
多类别分类
多类分类任务与二元分类任务非常相似,因为您尝试在给定一组特征的情况下预测单个标记列的分类值。二元分类问题和多类分类问题之间的主要区别在于,对于二元分类问题,只有两个可能的值,而在多类分类问题中,有三个或更多可能的类别可能属于某些东西。
用于使用 AutoML 训练多类分类实验的代码可能如下所示:
public ITransformer PerformMultiClassification(IDataView trainingData, IDataView validationData)
{
// Set up the experiment
MLContext context = new MLContext();
uint maxSeconds = 10;
MulticlassClassificationExperiment experiment = context.Auto().CreateMulticlassClassificationExperiment(maxSeconds);
// Run the experiment and wait synchronously for it to complete
ExperimentResult result =
experiment.Execute(trainingData, validationData, labelColumnName: "RiskCategory");
// result.BestRun.ValidationMetrics has properties helpful for evaluating model performance
string confusionTable = result.BestRun.ValidationMetrics.ConfusionMatrix.GetFormattedConfusionTable();
// Return the best performing trained model
ITransformer bestModel = result.BestRun.Model;
return bestModel;
}
除此之外,使用经过训练的多分类模型的代码与使用二元分类模型的代码非常相似。与二元分类模型一样,可以在不使用 AutoML 的情况下使用多类别分类模型。
回归
回归任务涉及在给定一组特征的情况下预测数值。例如,您可以使用回归模型在给定一组已知其他因素的情况下预测汽油价格,或者使用回归来预测在给定夜间天气因素的情况下,您可能需要在早上为汽车除霜的时间长度。任何时候你需要计算一个数值,你都可能正在处理一个回归问题。
用于对回归实验执行模型训练的代码类似于分类实验的代码:
public ITransformer PerformRegression(IDataView trainingData, IDataView validationData)
{
// Set up the experiment
MLContext context = new MLContext();
uint maxSeconds = 10;
RegressionExperiment experiment = context.Auto().CreateRegressionExperiment(maxSeconds);
// Run the experiment and wait synchronously for it to complete
ExperimentResult result =
experiment.Execute(trainingData, validationData, labelColumnName: "Temperature");
// result.BestRun.ValidationMetrics has properties helpful for evaluating model performance
double error = result.BestRun.ValidationMetrics.MeanAbsoluteError;
// Return the best performing trained model
ITransformer bestModel = result.BestRun.Model;
return bestModel;
}
请注意,回归实验的验证指标与分类实验的验证指标完全不同。分类实验处理给定正确类别的概率,而回归实验处理已知历史数据的预测数值与实际数值之间的距离。
与这两种分类模型类型一样,在训练回归模型时也可以不需要使用 AutoML,但如果对各个算法的了解有限,则可能会很有帮助。
推荐
推荐算法是回归算法的变体。使用推荐算法,您可以输入有关不同类型的用户以及他们过去给予商品的不同评级的数据。给定这样的数据集,推荐模型可以根据用户与其他已知用户的品味的相似性来预测用户对他们以前从未与之交互过的东西的评分。推荐模型在电影、音乐和产品推荐系统中很受欢迎,在这些系统中,重复用户很常见,每个人都可以从用户找到他们最喜欢的内容中受益。
AutoML 支持推荐,推荐代码与回归代码非常相似:
public ITransformer PerformRecommendation(IDataView trainingData, IDataView validationData)
{
// Set up the experiment
MLContext context = new MLContext();
uint maxSeconds = 10;
RecommendationExperiment experiment = context.Auto().CreateRecommendationExperiment(maxSeconds);
// Run the experiment and wait synchronously for it to complete
ExperimentResult result =
experiment.Execute(trainingData, validationData, labelColumnName: "Rating");
// result.BestRun.ValidationMetrics has properties helpful for evaluating model performance
double error = result.BestRun.ValidationMetrics.MeanAbsoluteError;
// Return the best performing trained model
ITransformer bestModel = result.BestRun.Model;
return bestModel;
}
推荐算法使用矩阵分解,这是一个更复杂的主题。有关不使用 AutoML 的推荐系统的更多详细信息,请参阅 Microsoft 的矩阵分解教程。还有一篇来自Rubik's Code的精彩文章,进一步深入探讨了这个话题。
排名
排名类似于推荐算法,但用于将项目放入适合显示搜索结果的强制顺序排名中。排名系统适用于显示特定用户或用户组的有序建议列表。
代码类似于我们之前看到的代码,尽管验证指标有很大不同:
public ITransformer PerformRanking(IDataView trainingData, IDataView validationData)
{
// Set up the experiment
MLContext context = new MLContext();
uint maxSeconds = 10;
RankingExperiment experiment = context.Auto().CreateRankingExperiment(maxSeconds);
// Run the experiment and wait synchronously for it to complete
ExperimentResult result =
experiment.Execute(trainingData, validationData, labelColumnName: "Temperature");
// result.BestRun.ValidationMetrics has properties helpful for evaluating model performance
IEnumerable gains = result.BestRun.ValidationMetrics.DiscountedCumulativeGains;
IEnumerable normalizedGains = result.BestRun.ValidationMetrics.NormalizedDiscountedCumulativeGains;
// Return the best performing trained model
ITransformer bestModel = result.BestRun.Model;
RankingEvaluatorOptions options = new RankingEvaluatorOptions();
RankingMetrics metrics = context.Ranking.Evaluate(trainingData, labelColumnName: "Label", rowGroupColumnName: "Group", scoreColumnName: "Score");
return bestModel;
}
其他解决方案类型
接下来让我们简要介绍一下 AutoML 当前不支持的五个机器学习任务。
预测时间序列数据
预测涉及根据历史数据预测一批未来回归值。当您进行预测时,您正在预测来自某个窗口的未来值,其中预测的每个值都具有一定程度的置信水平。
这与天气预报的工作方式类似。天气预报在预测近期值时最准确,具有大量相关的历史数据。它们可用于预测未来某个时间的值,但随着时间范围的延长,这些预测的准确性会显著下降。
聚类
聚类用于根据与附近数据点的相似性将各种数据点组合在一起。这可用于确定哪些客户在市场营销、建议分组或其他目的方面彼此相似。在处理地理数据时,这也是确定办公室位置或手机信号塔最佳位置的好方法。
聚类分析通常通过选择任意数量的聚类并允许机器学习遵循 K-Means 聚类算法来优化每个聚类的中心位置,以最小化从每个数据点到其聚类中心的总距离。聚类算法还倾向于在可能的情况下尝试将聚类彼此隔开。
异常检测
异常检测可用于将单个事务标记为异常,以便进行其他调查。异常检测通常用于病毒检测、信用卡欺诈检测和识别异常网络活动。您可以将异常检测视为一种自动形式的二元分类,其中某些内容要么是正常的,要么是异常的。
图像分类
图像分类类似于二元或多类分类,但不是处理数字特征,而是处理图像以确定给定图像中的特征。与分类问题一样,您必须为 ML.NET 提供各种不同大小、照明和排列方式的标记图像,这些图像具有您尝试检测的事物,以便对图像进行可靠的分类。
物体检测
对象检测类似于图像分类,但不是告诉您图像属于特定类,而是在图像中为您提供一个实际的边界框,告诉您该特定对象的位置。此外,对象检测能够在单个图像中定位多个对象,这超出了图像分类的限制。
对象检测是 Azure 认知服务的一部分,当前它只能通过模型生成器在 ML.NET 中使用。
结论
简而言之,ML.NET 的 Auto ML 功能是一种令人惊叹的完全免费的方式,可帮助日常程序员利用您通常需要数据科学家才能获得的功能。ML .NET 允许你和你的团队使用你已经熟悉的语言将机器学习功能集成到你的应用程序中,而无需深入了解各种机器学习算法。






