本文介绍一篇来自浙江大学侯廷军教授课题组、中南大学曹东升教授课题组、和腾讯量子实验室联合发表的一篇文章。该文章提出了一种用于机器学习打分函数(machine-learning scoring functions, MLSFs)训练和测试的无隐藏偏差(hidden bias)数据集构建新方法。该方法引入四种技巧来消除隐藏偏差,针对特定靶标的活性分子,基于条件分子生成和分子对接,可以基于已知的活性分子高效地生成相应的诱饵分子(假定的负样本,decoys),为MLSFs的训练和测评提供了相对无偏的数据集。
苗头化合物的发现是药物设计与发现的一个重要研究领域,基于生物实验的传统高通量筛选方法成本高、周期长、效率低,因此通过计算的方法发现能与靶标结合的苗头化合物是非常必要的。在药物虚拟筛选中,打分函数(scoring function,SF)被用于快速评价靶标与化合物的结合强度,但传统的打分函数预测精度较低。随着人工智能技术的兴起,引入机器学习算法来提升打分函数的精度成为了一种可行的方案。高质量数据集对于机器学习打分函数的构建起了至关重要的作用,主要包含了靶标蛋白、活性分子、非活性分子及标签。目前大部分公开数据集是针对传统打分函数而开发的,按照收集方式的不同大致可分为两类:(1)基于公开数据库收集,数据集中的正负样本为经过实验验证且有活性数据的分子,如PDBbind;(2)数据集中的正样本经过实验验证且有活性数据,负样本是基于人为的假设而收集的(这种假定的负样本被称为decoys),如DUD和DUD-E收集了与活性分子拓扑结构不相似的分子作为decoys,DEKOIS收集了与活性分子药效团不相似的分子作为decoys。第二种方式构建的数据集如DUD-E起初被用于传统打分函数的筛选能力的测试,后来也被用于MLSFs的训练和测试。然而,有学者指出,这些数据集直接被用于MLSFs的训练和测试会带来隐藏偏差、数据量有限的问题。
传统数据集用于MLSFs的构建/测试中的隐藏偏差主要有人工富集(活性/非活性分子物理化学性质差异过大,模型只需根据物理化学性质的差异即可分辨活性/非活性)、相似偏差(数据集中的化合物结构过于相似,模型的测试表现过于乐观/泛化能力有限)、域偏差(数据集中的化合物结构多样性太低,模型只适用于预测训练集中出现的特定骨架的化合物)以及非因果偏差(模型在测试集上的表现好是因为模型学习了数据集中的构造分布,如在DUD-E上训练的模型可以很轻易的根据活性分子与非活性分子的结构不相似性进行分类从而取得很好的表现)。为了解决传统数据集中存在的隐藏偏差,研究者们提出了不同解决方案。
本研究提出的TocoDecoy整合了四种技巧来解决隐藏偏差的问题:作者在100万数量级的数据集上训练了条件分子生成模型,确保模型能够生成结构多样的分子(去除域偏差);通过条件分子生成模型来控制生成的分子与活性分子物理化学性质相似(去除人工富集);通过T-SNE算法把化合物映射到二维化学空间并进行格点过滤(去除相似偏差);引入两种诱饵构建策略:假设与活性分子结构相似度较低的分子为负样本、假设活性分子与靶标的错误结合构象为负样本(去除非因果偏差);通过整合上述四种技巧,TocoDecoy较为有效去除了数据集中的隐藏偏差;此外,基于分子生成模型和分子对接技术使得数据集的可扩展性大大提升。
TocoDecoy的工作流程如图1所示,其中包含以下主要步骤:(1)将“种子”配体(活性配体)的六个物理化学性质(MW,分子量;logP,油水分配系数;RB,可旋转键数量;HBA,氢键受体数量;HBD,氢键供体数量;HAL,卤键数量)输入到条件循环神经网络(conditional recurrent neural network,cRNN)模型中,以生成属性匹配的decoys。cRNN为每个活性配体共生成了200个有效且不重复的decoys。(2)尽管生成的decoys可能具有相似的物理化学性质,并且其拓扑结构大概率与其种子(活性)配体不同,但总有一些例外。因此,decoys在与活性配体的理化性质相比,Dice相似性(DS)不符合以下要求将被过滤掉:(i)MW±40 Da,(ii)logP±1.5,(iii)RB±1,(iv)HBA±1,(v)HBD±1,(vi)HAL±1,(vii)DS<0.4。(3)对每个分子依次计算ECFP和T-SNE向量,然后进行格点过滤,以消除由相似结构引起的相似偏差;保留的decoys形成拓扑诱饵集(Topology Decoys,TD),这些decoys的对接构象是通过对经过结构预处理的蛋白质和配体的分子对接获得的。(4)按照表S1中列出的相应对接分数阈值来过滤活性配体的对接构象,对接分数低于阈值的构象被作为decoys构象保留,从而产生构成构象诱饵集(Conformation Decoys,CD)。(5)最后,将TD和CD集整合为最终的TocoDecoy数据集。
本研究中使用的数据集包含第25版ChEMBL数据集的子集(数据集A)、LIT-PCBA的子集(数据集B)、基于数据集B的活性配体生成的TocoDecoy数据集(数据集C)和从数据集C中提取的类DUD-E数据集(数据集D)。数据集A用于cRNN建模。鉴于LIT-PCBA中的分子的活性经过实验验证,并且对于MLSF的构建和基准测试相对无偏,作者用LIT-PCBA中的活性分子和靶标生成TocoDecoy数据集。数据集C,即TocoDecoy数据集,是基于数据集B中的活性分子生成的。对于数据集D,由于数据集B中选择的靶标没有相应的DUD-E数据集,而TD集(数据集C的一个子集)与DUD-E的诱饵生成策略相似,因此作者选择TD集作为DUD-E数据集的替代方案。
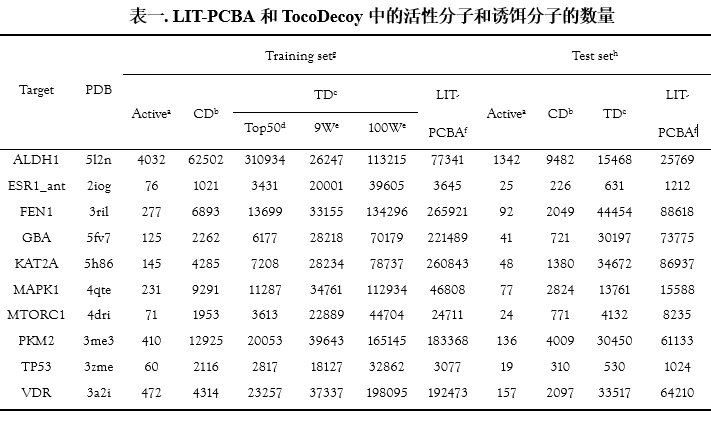
作者首先根据LIT-PCBA中的活性分子生成TocoDecoy数据集,然后系统地研究LIT-PCBA和TocoDecoy中的隐藏偏差,包括人工富集、相似偏差、域偏差和非因果偏差。最后,作者调查了在TocoDecoy上训练的MLSFs在模拟虚拟筛选中的表现。本研究中使用的训练和测试集中的活性分子和decoys的数量列于表1。
人工富集:为了防止模型只根据活性分子和非活性分子的物理化学性质的不同来进行分类,在构建数据集时需要尽可能使得活性分子与非活性分子的物理化学性质相似。在这里,作者用DOE score来进行衡量,其数值越小,表示活性/非活性分子物理化学性质越相似。如图2所示,在所选的10个靶点中,TocoDecoy的DOE score均低于LIT-PCBA,说明TocoDecoy数据集的人工富集低于LIT-PCBA。
域偏差:为了防止模型应用域过窄,用于训练的数据集需要满足分子结构多样性足够大的前提。这里,作者采用了internal diversity来衡量数据集中分子的化学结构多样性,其值越大,表示数据集的分子结构越丰富。如图3所示,在所选的10个靶点中,9个靶点的TocoDecoy数据集的分子多样性优于对应的LIT-PCBA,说明TocoDecoy数据集的域偏差低于LIT-PCBA。
相似偏差:相似偏差是指数据集中存在部分分子结构过于相似,导致模型的测试表现偏高/训练得到的模型泛化能力不强。这里,作者采用了格点过滤,并对比了格点过滤前后在TocoDecoy数据集上训练得到的MLSF在外部测试集上的性能。这里用到的MLSF为InteractionGraphNet(IGN),用到的外部测试集统一为LIT-PCBA的测试集。如图4所示,在8个靶点上,在格点过滤后的TocoDecoy数据集上训练得到的IGN预测性能优于在格点过滤前的TocoDecoy数据集上训练的IGN的预测性能,说明格点过滤可以有效的减少数据集的相似偏差,从而提升相应模型的泛化能力。
非因果偏差:MLSF很容易通过学习训练集中正负样本的构造策略来取得虚高的表现,造成了非因果偏差。一个经典的案例是在DUD-E上进行训练得到的MLSF,很容易学习到活性/非活性分子间的拓扑结构差异来进行分类。为了防止非因果偏差,作者引入了两种互相“冲突”的诱饵生成策略(负样本构造策略)。第一种策略是与活性分子拓扑结构相似度低于0.4的分子为decoys(与活性分子结构不相似,对接分数接近);第二种是把活性分子与靶标蛋白的错误构象(Glide SP对接分数较高)作为decoys(与活性分子结构一样,对接分数相差大)。这里,作者验证了单一诱饵生成策略容易造成非因果偏差。如图5,TD集中的decoys是按照第一种策略构造的,作者可以看到在TD训练集上训练的MLSF(ECFP-XGBoost)仅能在TD测试集上取得较好的表现,在其他诱饵生成策略不同的数据集上表现迅速下降,说明MLSF是根据活性/非活性分子的拓扑结构进行分类的,并没有学习根据蛋白配体间的相互作用进行分类。与之形成对比的是在引入了两种不同诱饵生成策略的TocoDecoy数据集上训练得到的模型在各个训练集上都不能取得很好的表现,说明模型并没有仅依靠分子的拓扑结构信息进行分类。
图2. TocoDecoy数据集和LIT-PCBA的DOE score。分数越低,表示人工富集越小。
图3. TocoDecoy数据集和LIT-PCBA的Internal diversities。数值越高,表示数据集的化学多样性越大。
图4. 格点过滤前后在TocoDecoy数据集上训练的模型的性能。模型的表现是不同模型在LIT-PCBA的测试集上测试得到的。TocoDecoy(Top50)是根据与相应活性配体的拓扑相似性排名前50个分子而不是格点过滤器过滤得到的数据集,而TocoDecoy_9W是TocoDecoy数据集经过90 000个网格的格点过滤后得到的数据集。类似的,TocoDecoy_100W是TocoDecoy数据集经过网格数为1 000 000的格点过滤后得到的数据集。
图5. 在TD集和TocoDecoy的ECFP上训练的XGBoost模型的性能。TD、CD、TC和LI分别代表TD集、CD集、TocoDecoy集和LIT-PCBA。@之前代表训练集,@之后代表测试集。例如,TC@LI列中的F1分数代表了在TocoDecoy上训练并在LIT-PCBA测试集上测试的模型的性能。CD集和TD集是从TocoDecoy_9W集中提取的。
在不同数据集上训练得到的模型在模拟虚拟筛选中的表现
考虑到LIT-PCBA中的活性/非活性分子是经过实验测试的,模型在LIT-PCBA测试集上的表现可以在一定程度上模拟模型在虚拟筛选中的表现。因此,作者在各种数据集上训练了IGN模型,并在LIT-PCBA的测试集上测试了这些模型。为了更好地了解在TocoDecoy上训练的模型的泛化能力,除了TocoDecoy之外,作者还在DUD-E和LIT-PCBA上训练了IGN模型作为对照。如图6A所示,IGN模型在F1分数和BED_ROC方面优于Glide SP,这表明在虚拟筛选中,MLSF优于传统SF。在IGN模型中,LIT-PCBA上训练的模型在F1分数(图6A)、BED_ROC和Precision方面优于TocoDecoy和DUD-E训练的模型,因为LIT-PCBA训练集的数据分布比TocoDecoy和DUD-E的测试集更类似于LIT-PCBA的测试集。显然,在DUD-E上训练的模型偏向于通过分子拓扑结构差异区分活性分子和非活性分子,不能泛化到LIT-PCBA的测试集。同样,在TocoDecoy上训练的模型也并不能在虚拟筛选中很好的泛化。然而,TocoDecoy训练的模型在F1分数、BED_ROC和Precision方面优于DUD-E训练的模型,这表明TocoDecoy训练的模型具有相对更好的泛化能力。如图6B所示,在十个靶标中的九个(除了ESR1_ant)靶标数据集上,在TocoDecoy上训练的模型比在DUD-E上训练的模型取得了更高的F1分数,在十个靶标中的五个靶标数据集上,在LIT-PCBA上训练的模型预
测性能弱于TocoDecoy数据集上训练的模型。
图6. 在TocoDecoy、DUD-E和LIT-PCBA上训练的Glide SP和IGN模型的预测性能,并在LIT-PCBA的测试集上进行了测试。A:模型性能。B:模型在十个靶标数据集上的归一化F1 score。按照靶标归一化F1 score是为了方便可视化。
TocoDecoy对比了传统的数据集DUD-E和适用于MLSFs评价的无隐藏偏差数据集LIT-PCBA。在四种隐藏偏差的验证中,TocoDecoy表现较另外两个数据集相当/更少的隐藏偏差。在模拟虚拟筛选实验中,在不同数据集上训练的模型的预测精度排名为:LIT-PCBA≈TocoDecoy>DUD-E。尽管TocoDecoy与LIT-PCBA上训练的模型性能相当,但TocoDecoy数据集的可扩展性也是不可忽略的优点。这些结果表明TocoDecoy是一种更为合理的数据集构建方法,有望帮助相关领域的研究人员更好地对MLSFs进行测评和训练。
Tocodecoy: A New Approach to Design Unbiased Datasets for Training and Benchmarking Machine-Learning Scoring Functions. J. Med. Chem. 2022. DOI: 10.1021/acs.jmedchem.2c00460.



