背景
这篇文章是《一次vba脚本到python脚本的性能优化之旅》的姊妹篇,在这篇文章的末尾,我曾提到程序性能的优化永无止境,我们可以尝试用Python的并发编程来进行进一步优化,于是就有了这篇文章。通过这次实践,正好验证一下我们对于并发编程理论的一些认知,也进一步帮我们加深对Python并发编程实现的理解。
并发 vs 并行
说到并发编程,我们先来澄清一下并发 (Concurrency) 和 并行 ( Parallelism)这两个概念,因为这个两个概念的含义是不同的。
并行(Parallelism)指的就是在同一时刻,有两个或两个以上的任务的代码在处理器上执行。从这个概念我们也可以知道,多个处理器或多核处理器是并行执行的必要条件。
在单个CPU核上,线程或进程通过时间片或者让出控制权来实现任务切换,达到 "同时"运行多个任务的目的,这就是所谓的并发(Concurrency)。但实际上任何时刻都只有一个任务被执行,其他任务通过某种算法来排队。
多核CPU可以让同一进程内的"多个线程"或多个进程做到真正意义上的同时运行,这才是并行。
因此,我们可以有这样一个认知结论:并发不是并行,并发关乎结构,而并行关乎执行。在不满足并行必要条件的情况下(也就是仅有一个单核CPU的情况下),即便是采用并发设计的程序,依旧不可以并行执行。而在满足并行必要条件的情况下,采用并发设计的程序是可以并行执行的。而那些没有采用并发设计的应用程序,除非是启动多个程序实例,否则是无法并行执行的。
threading vs multiProcessing vs asyncio
接下来我们来聊一下线程、进程和协程以及Python中的对应实现。
学习过计算机基础或其他编程语言的,应该清楚这几者之间的区别:
- 进程:进程是系统进行资源分配的基本单位,有独立的内存空间;
- 线程:线程是CPU调度和分派的基本单位,线程依附于进程存在,每个线程会共享父进程的资源,线程栈是线程独占的内存资源,比如JAVA线程栈内存默认1024KB;
- 协程:协程是一种用户态的轻量级线程,协程的调度完全由用户控制,协程间切换只需要保存任务的上下文,没有内核的开销,协程的栈内存资源占用很小,协程初始化创建的时候为其分配的栈内存只有2KB;
从进程到线程到协程,从内存资源占用和上下文开销来说,都是越来越小的,也即越来越轻量级,这也意味着在同样的服务器资源的情况下,相比进程我们可以创建更多数量的线程,而相比线程我们可以创建更多数量的协程。所以,这也是为什么随着C10K甚至C100K问题的出现,我们需要逐渐从PPC(Process Per Connection )和TPC(Thread Per Connection)方案转为IO多路复用方案,进而再转为协程的方案,才能用一台服务器支撑更高的并发。
说完通用的进程、线程和协程,我们再来看Python的对应实现,即threading、multiProcessing和asyncio。
了解Python的应该知道,因为GIL(全局解释器锁)的存在,使用threading库进行多线程编程时,同一时间只会有一个获得了 GIL 的线程在跑,其它的线程都处于等待状态等着 GIL 的释放,这就导致我们即使使用了threading,我们也不能利用多CPU或CPU多核的性能来加速计算。
为了解决这个问题,Python在2.6里引入了multiprocessing这个多进程标准库,让多进程的 python 程序编写简化到类似多线程的程度,进而解决GIL带来的并发编程不能利用多核CPU的问题。
但多进程的方案太重,还有个方案是把关键部分用 C/C++ 写成 Python 扩展,其它部分还是用 Python 来写,让 Python 的归 Python,C 的归 C。一般计算密集性的程序都会用 C 代码编写并通过扩展的方式集成到 Python 脚本里(如 NumPy 模块)。在扩展里就完全可以用 C 创建原生线程,而且不用锁 GIL,这样就能充分利用 CPU 的计算资源了,这样的方案更轻量级性能也更好,但不在这次我们这篇文章讨论的范围内,毕竟这涉及到C的编程实现了。
而Python的协程实现asyncio,则不同于多线程,Asyncio是单线程的,但其内部 event loop 的机制,可以让它并发地运行多个不同的任务,并且比多线程享有更大的自主控制权。
Asyncio 中的任务,在运行过程中不会被打断,因此不会出现 race condition 的情况。尤其是在 I/O 操作 heavy 的场景下,Asyncio 比多线程的运行效率更高。因为 Asyncio 内部任务切换的损耗,远比线程切换的损耗要小,因此 Asyncio 可以开启的任务数量,也比多线程中的线程数量多得多。
但需要注意的是,很多情况下,使用 Asyncio 需要特定第三方库的支持,比如如果我们要用asyncio实现异步并发爬虫,就不能继续使用requests库,而必须使用aiohttp库。同样,如果要用asyncio实现异步并发文件io,也不能继续沿用open(),而必须使用aiofiles.open()。
因此,如果 I/O 操作很快,并不 heavy,那么运用多线程,也能很有效地解决问题。
CPU Bound VS I/O Bound
好了,经过上面知识的铺垫,我们就能来讲解一下CPU Bound(计算密集型)和
I/O Bound(I/O密集型)的区别,以及不同场景下我们应该如何使用进程、线程和协程了。
CPU bound(CPU密集型):CPU密集型也叫计算密集型,是指I/O在很短的时间内就可以完成,但CPU需要大量的计算和处理,特点是CPU占用率相当高,比如压缩解压缩、加密解密、正则表达式搜索等;
I/O bound(I/O密集型):I/O密集型是指系统运行过程中大部分的时间是CPU在等IO(硬盘/内存)的读写操作,CPU占用率较低,比如文件处理、网络爬虫、读写数据库等;
基于以上我们的知识点介绍,我们直接说结论,多线程、多进程和asyncio分别的使用场景如下:
if io_bound:
    if io_slow:
        print('Use Asyncio')
    else:
        print('Use multi-threading')
else if cpu_bound:
    print('Use multi-processing')
换成白话就是:
- 如果是 I/O bound,并且 I/O 操作很慢,需要很多任务 / 线程协同实现,那么使用 Asyncio 更合适;
- 如果是 I/O bound,但是 I/O 操作很快,只需要有限数量的任务 / 线程,那么使用多线程就可以了;
- 如果是 CPU bound,则需要使用多进程来提高程序运行效率;
接下来,基于我们以上对Python多线程、多进程和协程的介绍,我们来看看对于我们的脚本应该如何选择来进行优化。
多线程IO
首先说明一下,在上一篇文章的优化手段之后,我又在代码层面做了进一步的优化,我们原先单线程的脚本的计算性能进一步得到极大的提升,如下图所示:
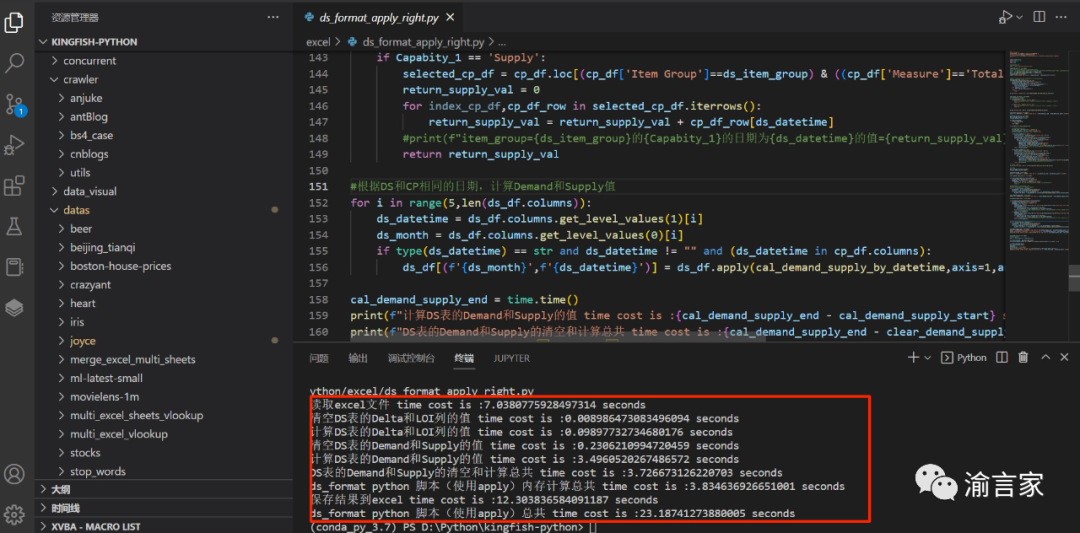
从上图我们可以看到,在整体的耗时中,excel保存的耗时是最多的(12.3s),其次是excel的读取(7.04s),最后才是内存计算(3.83s)。
根据我们之前说到性能优化的二八准则,也即通过数据分析发现瓶颈,即占用80%耗时的地方,然后有针对性地优化该瓶颈。我们可以看到我们这个脚本的性能瓶颈主要在文件IO上,也即这是一个IO密集型的场景。因此,我们的优化目标要聚集在两个IO环节上,即excel的读取和写入。
从性能数据上看,首先要优化的应该是excel的写入,但很遗憾的是,我们的excel是写入一个而不是多个文件,而且是写入文件的同一个sheet,所以没法通过并发的方式进行优化。
所以,我们的优化目标只能转而求其次聚焦在excel的读取上。因为我们读取的是excel的两个不同的sheet,所以,我们可以考虑采取并发读取的方式来进行优化。而根据我们之前对Python多线程、多进程和协程的介绍,我们要优化的场景属于IO密集型场景,所以我们考虑用多线程或协程的方案进行优化。我们先来看一下用多线程来优化,代码如下:
#要处理的文件路径
fpath = "datas/joyce/DS_format_bak.xlsm"

def t_read_cp_df():
    read_cp_df_start = time.time()
    global cp_df
    cp_df = pd.read_excel(fpath,sheet_name="CP",header=[0])
    read_cp_df_end = time.time()
    print(f"{threading.current_thread().getName()}读取excel文件cp sheet time cost is :{read_cp_df_end - read_cp_df_start} seconds")


def t_read_ds_df():
    t_read_ds_df_start = time.time()
    global ds_df
    ds_df = pd.read_excel(fpath,sheet_name="DS",header=[0,1])
    t_read_ds_df_end = time.time()
    print(f"{threading.current_thread().getName()}读取excel文件ds sheet time cost is :{t_read_ds_df_end - t_read_ds_df_start} seconds")

def read_excel():
    read_excel_start = time.time()
    #把CP和DS两个sheet的数据分别读入pandas的dataframe
    #启动两个线程并行读取excel的数据
    read_cp_df_thread = Thread(target=t_read_cp_df,args=())
    read_cp_df_thread.start()
    read_ds_df_thread = Thread(target=t_read_ds_df,args=())
    read_ds_df_thread.start()

    read_cp_df_thread.join()
    read_ds_df_thread.join()
    read_excel_end = time.time()
    print(f"读取excel文件 time cost is :{read_excel_end - read_excel_start} seconds")
运行优化后的代码,我们的执行效果如下图所示:
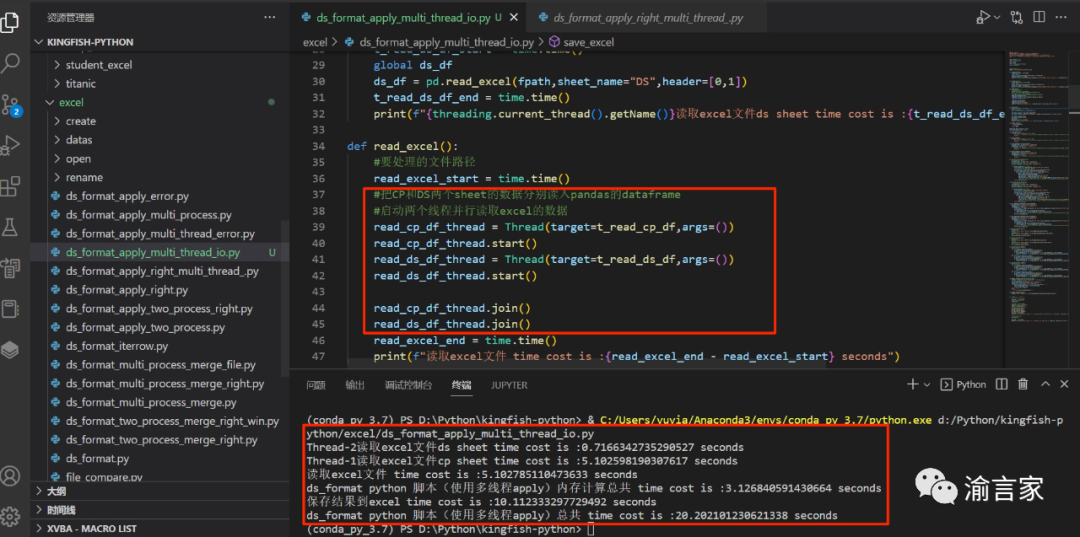
从上图可以看出,我们读取excel的耗时减少到了5.1s,而且我们分别细看一下两个线程的读取excel时间可以看到,整体的excel读取时间是小于两个线程分别读取excel的时间之和的,这说明两个线程对excel文件的读取性能是优于单线程串行读取的。
协程异步IO
我们在之前介绍IO密集型应用的时候,提到多线程或协程都可以用来优化IO密集型应用,那我们这个脚本的场景可以用协程来优化吗?可惜理想是美好的,但现实是残酷的。大家是否还记得,我们在介绍协程的时候,提到了使用Python协程的一个限制,即必须有支持的库才行,也即需要有相应场景下支持异步IO的库,比如aiohttp、aiofiles。但我们使用pandas的read_excel()没有异步库的支持,所以即使我们使用了asyncio,实际还是同步阻塞IO,我们可以来验证一下,见下面代码和执行效果:
async def read_cp_df():
    print('read_cp_df start')
    read_cp_df_start = time.time()
    global cp_df
    cp_df = pd.read_excel(fpath,sheet_name='CP',header=[0])
    read_cp_df_end = time.time()
    print(f"读取excel文件cp sheet time cost is {read_cp_df_end - read_cp_df_start}: seconds")


async def read_ds_df():
    print('read_ds_df start')
    read_ds_df_start = time.time()
    global ds_df
    ds_df = pd.read_excel(fpath,sheet_name='DS',header=[0,1])
    read_ds_df_end = time.time()
    print(f"读取excel文件ds sheet time cost is {read_ds_df_end - read_ds_df_start}: seconds")

async def read_excel():
    read_excel_start = time.time()
    #把CP和DS两个sheet的数据分别读入pandas的dataframe
    #启动两个协程读取excel的数据
    cp_df_task = asyncio.create_task(read_cp_df())
    ds_df_task = asyncio.create_task(read_ds_df())
    print('befoe await cp_df_task')
    await cp_df_task
    print('after await cp_df_task')
    await ds_df_task
    print('after await ds_df_task')
    read_excel_end = time.time()
    print(f"读取excel文件 time cost is :{read_excel_end - read_excel_start} seconds"
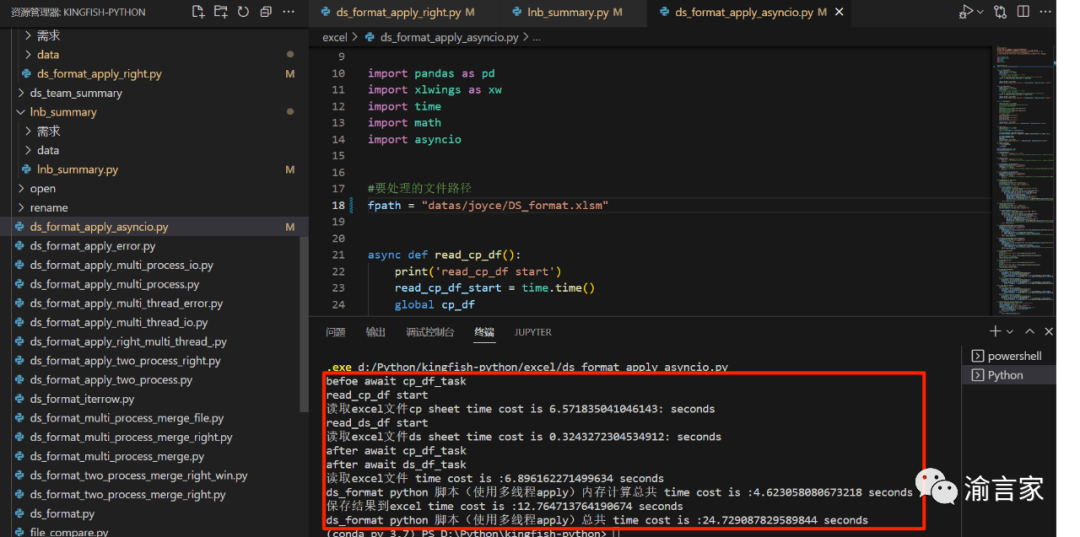
如上图所示,当我们新建两个asyncio任务分别读取excel文件的两个sheet,这两个asyncio任务的读取时间分别为6.57s和0.32s,最关键的是整体excel读取时间是这两个时间之和6.89s,也即等同于同步执行,并没有起到异步IO的效果。出现这个现象的原因,就是因为上面提到的pandas的read_excel方法是同步阻塞IO。
总结
从上面的并发编程实践我们可以看到,Python提供了线程、进程和协程的并发编程方式,但不同的并发实践需要应用到不同的场景才能起到效果,我们的系统有两种典型的场景:CPU密集型和IO密集型,其实我们的web应用系统基本上都是IO密集型,因此多线程和协程是可以起到不错的优化效果的,但是Python的协程会受到异步库支持的限制,因此不是所有IO密集型场景下都能发挥威力。
以上所有的代码可以从我的github获取,我的github地址:
https://github.com/xiaoyuge/kingfish-python
欢迎关注我的公众号,不仅聊代码,还会和大家聊一切跟技术有关的话题。






