JAX 是一个充满潜力的高性能数值计算库,它将可微分编程带入了 Python 生态系统。本文将介绍 JAX 的可微分编程技术,以及它如何为深度学习、机器学习和优化等领域带来革命性的变革,让更多人了解 JAX 的强大功能,并开始尝试使用这个令人兴奋的开源计算框架。
微积分中的微分学
在一元函数或者多元函数中,微分就是一个核心的概念。相比一元函数的微分和导数,多元函数的微分与偏导数则显得更加复杂。在微积分里面,多元函数是指具有多个自变量的函数,f(x, y) 就是一个具有两个自变量 x 和 y 的函数。在多元函数中,我们可能对每个自变量的变化如何影响函数值感兴趣。这就引入了多元函数的微分和偏导数的概念。
1. 偏导数(Partial Derivatives):
偏导数是表示多元函数相对于其中一个自变量的变化率。在计算偏导数时,我们将其他自变量视为常数。对于一个具有两个自变量的函数 f(x, y),其偏导数分为两类:
- 关于 x 的偏导数:表示为 f_x,计算时将 y 视为常数。
- 关于 y 的偏导数:表示为 f_y,计算时将 x 视为常数。
例如,对于函数 f(x, y) = x^2 + xy + y^2,关于 x 和 y 的偏导数分别为:f_x = 2x + y,f_y = x + 2y。
2. 梯度(Gradient):
梯度是一个向量,表示多元函数在某一点处沿着其自变量增加最快的方向。梯度由函数的所有偏导数组成。对于一个具有两个自变量的函数 f(x, y),其梯度表示为:grad f(x, y) = (f_x, f_y)。对于函数 f(x, y) = x^2 + xy + y^2,其梯度为:grad f(x, y) = (2x + y, x + 2y)。
3. 多元函数的微分:
多元函数的微分是一个线性映射,描述了函数在某一点处的局部线性近似。对于一个具有两个自变量的函数 f(x, y),其微分表示为:df = f_x dx + f_y dy。其中,dx 和 dy 分别表示 x 和 y 的变化量。多元函数的偏导数描述了函数相对于单个自变量的变化率,梯度表示了函数值增加最快的方向,而多元函数的微分提供了函数在某一点处的局部线性近似。这些概念在优化、机器学习和深度学习等领域具有重要意义。
神经网络与后向传播算法
神经网络技术在人工智能(AI)领域具有非常高的重要性,它是近年来 AI 领域取得突破性进展的关键技术之一。神经网络基于生物神经系统的工作原理,模拟了大脑神经元的连接和计算方式。
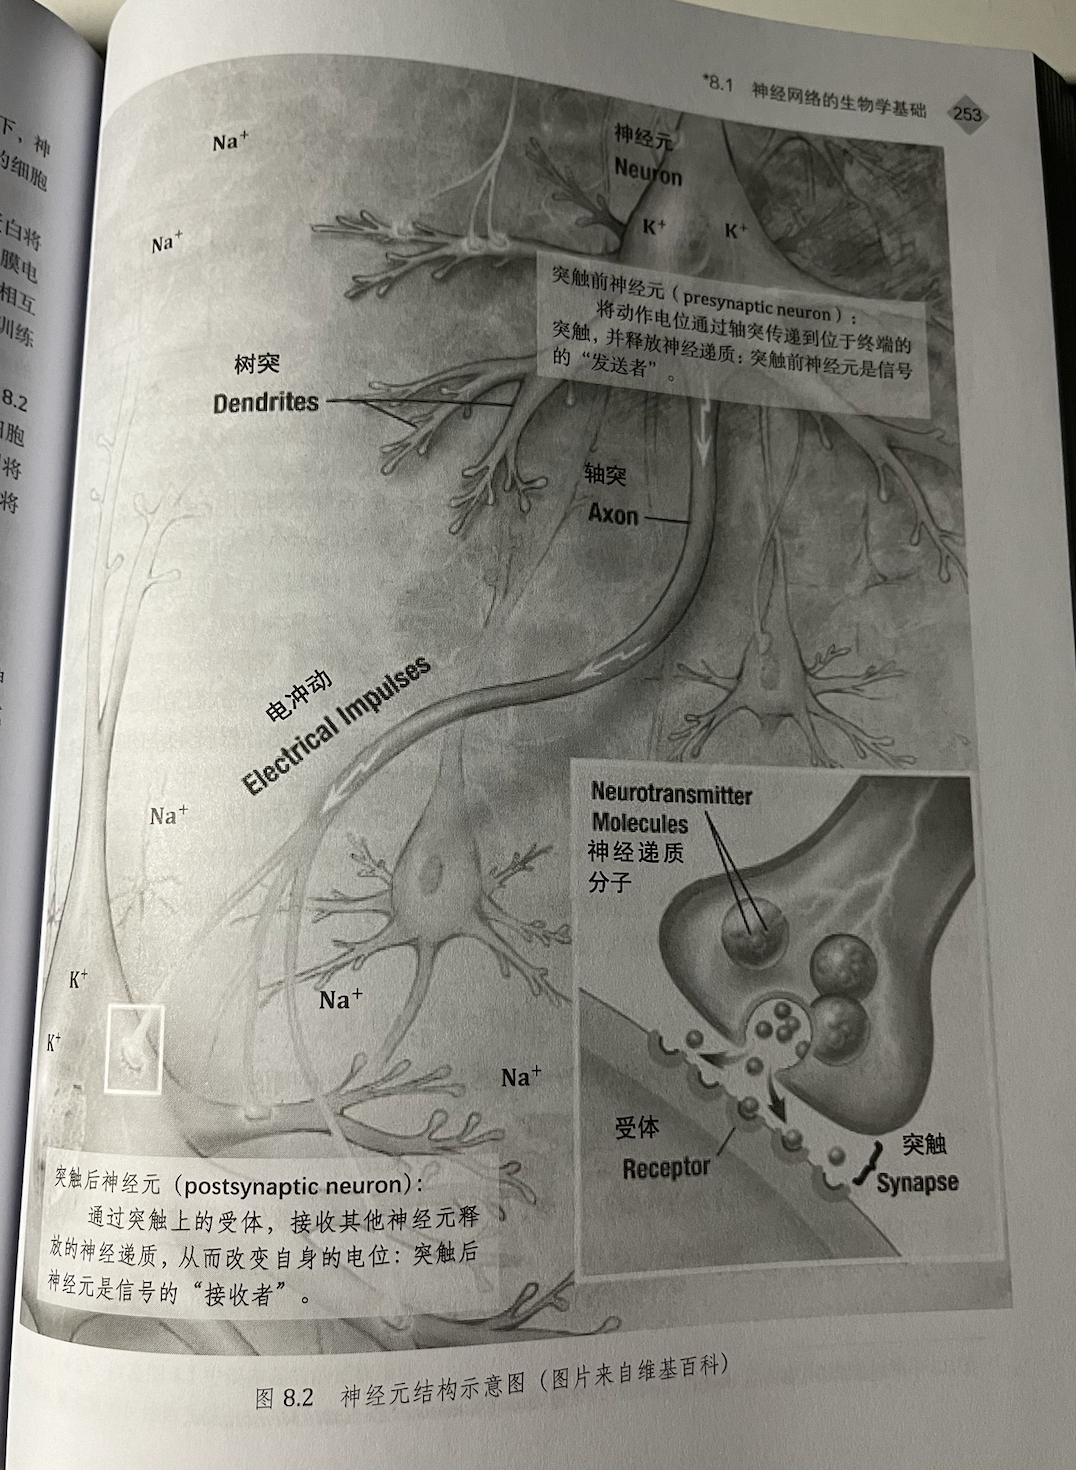
后向传播算法(Backpropagation)是一种用于训练神经网络的高效优化算法。它的基础是微积分中的链式法则,而链式法则用于计算复合函数的导数。在神经网络中,每一层的输出都是基于前一层的输出计算得到的,因此链式法则在计算梯度时起到关键作用。后向传播算法的核心思想是从输出层开始,将误差逐层向前传播,计算每一层的梯度。通过这种方式,我们可以有效地更新网络中的权重和偏置,以减小输出层的误差。梯度是损失函数关于参数的导数,表示损失函数在当前参数值下的变化方向。通过沿着梯度的负方向更新参数,我们可以逐步降低损失函数的值,从而优化神经网络。在计算出每一层的梯度后,我们需要根据梯度来更新网络中的权重和偏置。这通常通过学习率(Learning Rate)来控制更新的步长。较小的学习率可以使网络收敛得更稳定,但可能需要更多的迭代次数;较大的学习率可以加速收敛,但可能导致网络在最优解附近震荡。后向传播算法使得神经网络能够在大规模数据集上进行有效的训练和学习,从而神经网络就能够达到更佳的效果。
什么是可微分编程
可微分编程是一种编程范式,它允许我们将微分和优化技术直接融入计算机程序中。这种方法提供了高度的灵活性和可扩展性,使得它在深度学习、机器学习、优化等领域具有广泛的应用前景。在传统的编程方法中,我们需要手动计算函数的梯度,这既耗时又容易出错。而可微分编程通过自动微分技术,可以自动计算任何用 JAX 函数表示的程序的梯度,大大提高了编程效率和准确性。
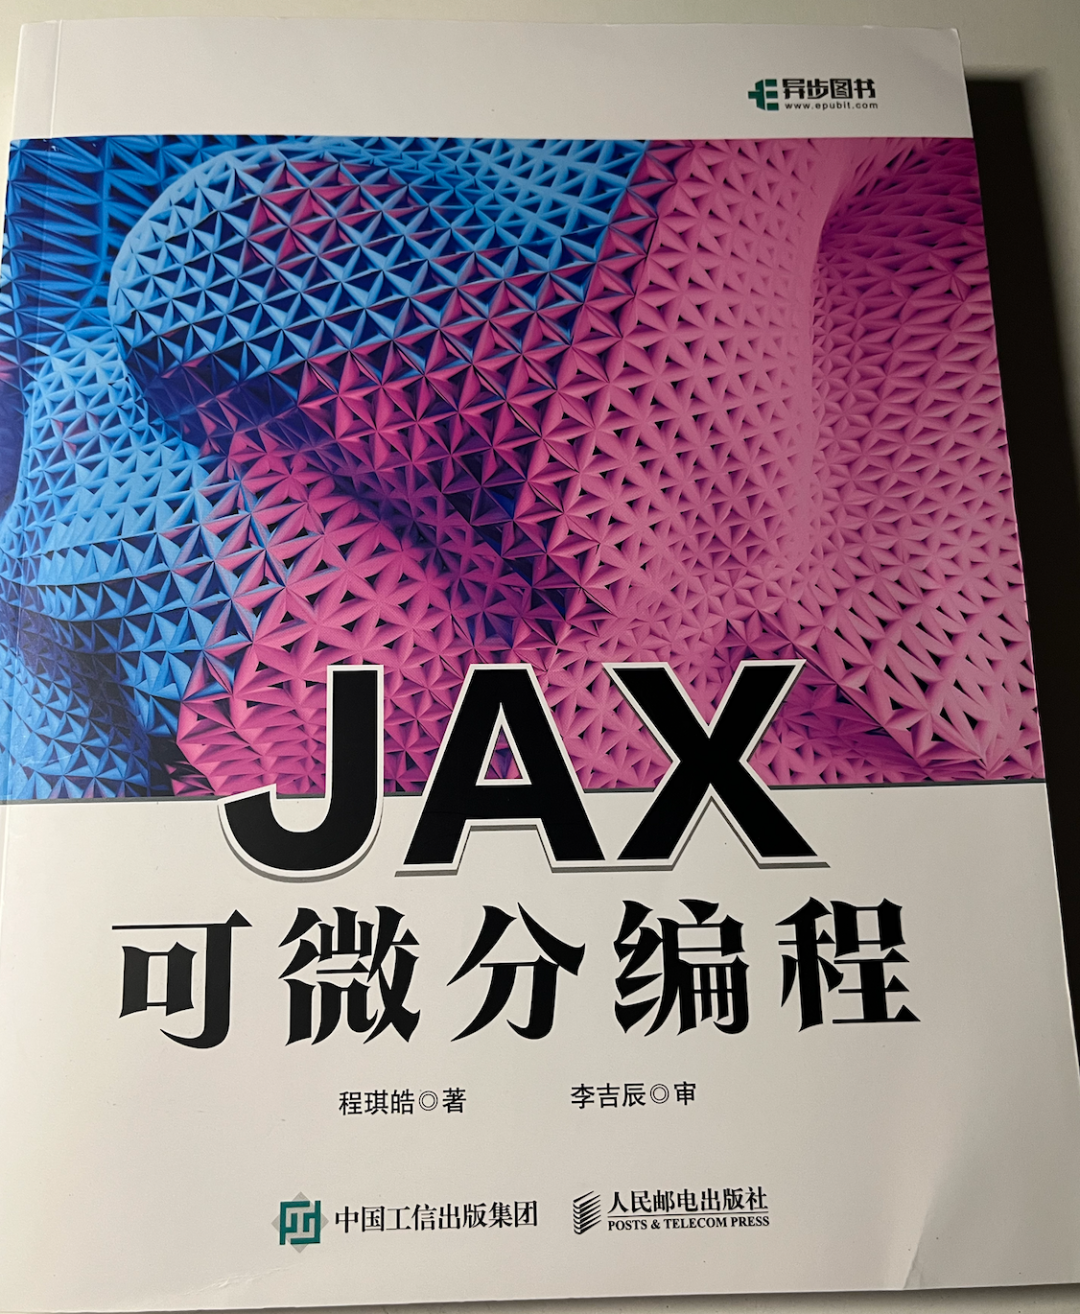
人民邮电出版社近期推出了书籍《JAX:可微分编程》,本书介绍了 Google 开发的开源计算框架 JAX,是针对机器学习研究的高性能自动微分框架,在深度学习、贝叶斯方法、控制系统等诸多领域得到了广泛应用。本书以 JAX 为基础,介绍了自动微分的基本原理以及它在实际场景下的应用。不仅介绍了神经网络,甚至还介绍了量子计算领域中的应用。
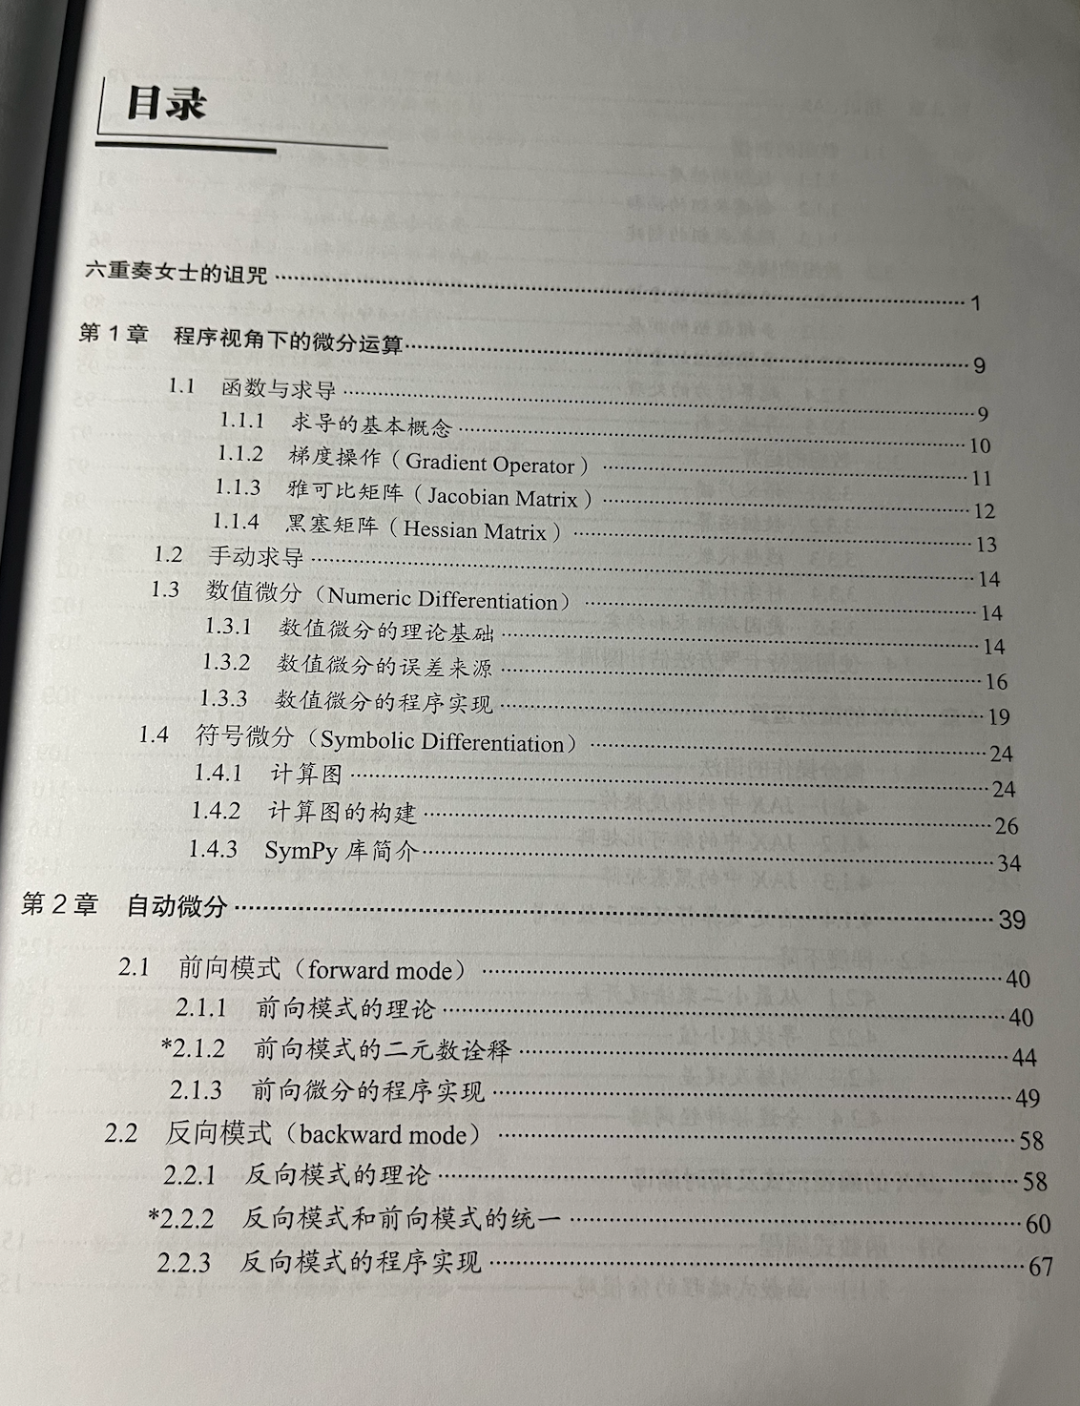
从目录可以看出,作者对 JAX 的讲解顺序做了精心的部署,从一开始的函数与求导开始,让读者开始学习和回顾微积分与线性代数的基础知识。然后开始讲解数值微分与符号微分,让读者对符号运算有一个清晰的了解。在符号运算中,计算图就是一个非常重要的概念,每一个数学公式的背后,都对应着一个计算图,而 Python 中有一个符号计算库 SymPy,恰好就能够为大家解决符号运算的问题。
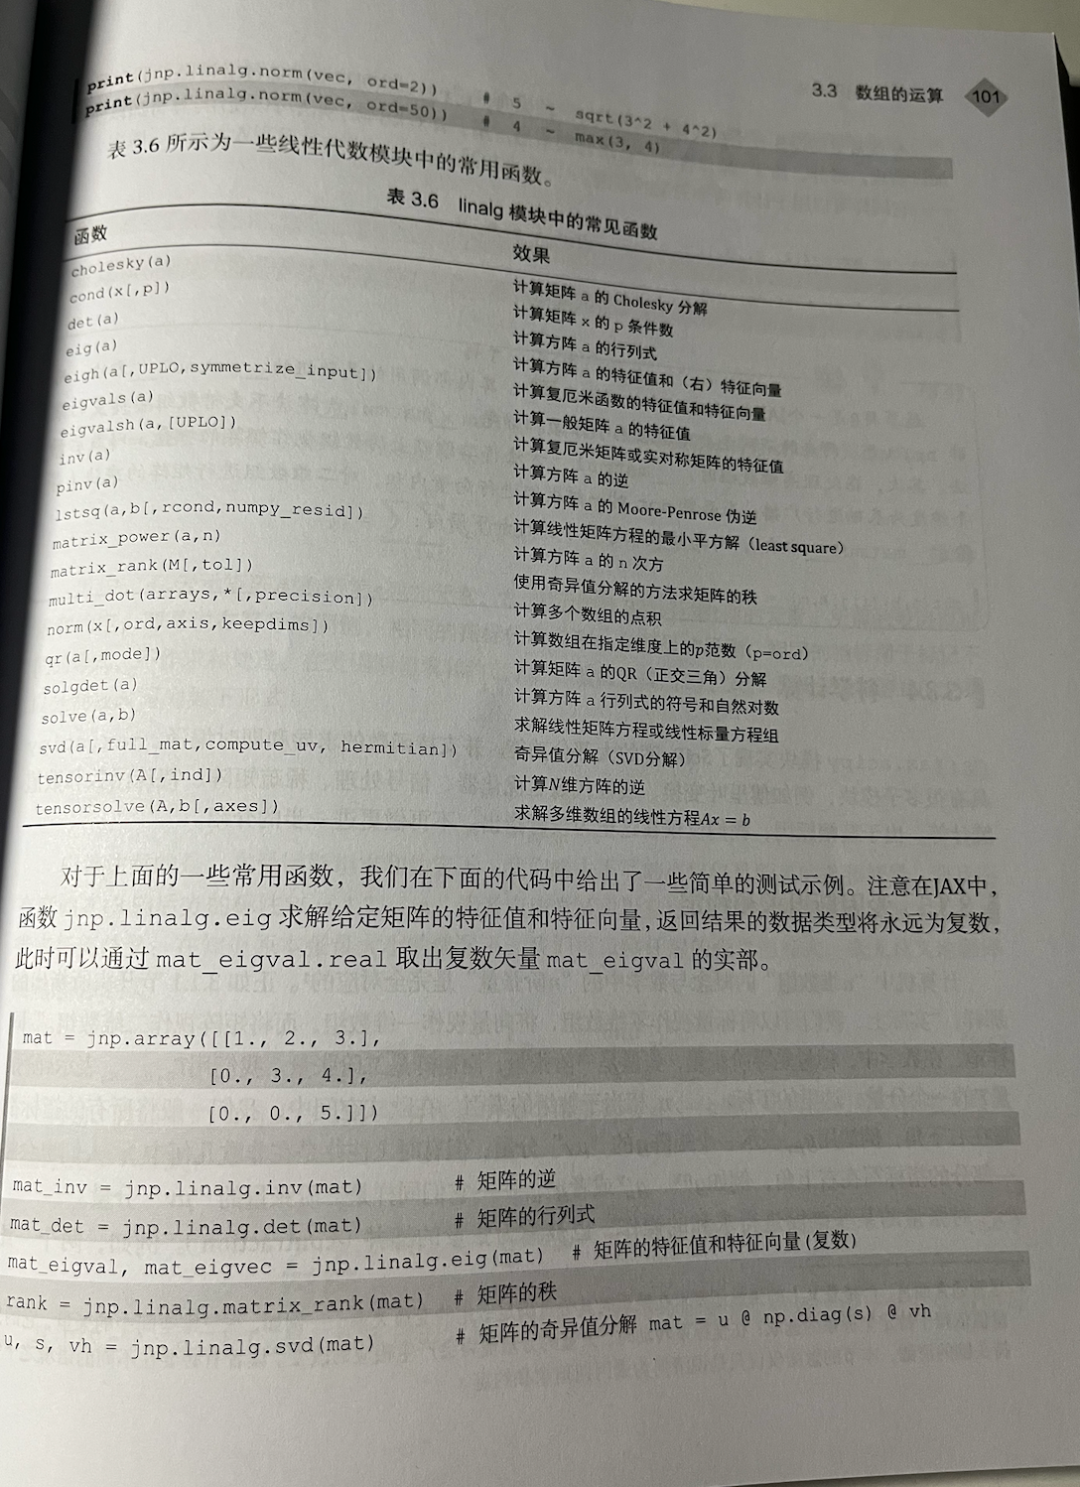
JAX 是一个用于高性能数值计算的 Python 库,它提供了一种简洁的方式来实现可微分编程。JAX 的核心功能是自动微分(Automatic Differentiation),它可以自动计算任何用 JAX 函数表示的程序的梯度。此外,JAX 还提供了一系列用于高性能数值计算的基本操作,例如矩阵乘法、卷积等。可以自动计算任意函数的导数,无论是标量函数还是向量函数。这使得它非常适合用于可微分编程,实现神经网络、优化算法等应用。它通过使用 Just-In-Time (JIT) 编译和硬件加速(如 GPU 和 TPU)来实现高性能数值计算。这使得 JAX 在大规模数据和模型上具有很好的性能表现。同时它提供了一种简洁的编程接口,可以轻松地编写复杂的数值计算程序。同时,JAX 与许多流行的 Python 数值计算库(如 NumPy、SciPy 等)兼容,使得用户可以无缝地在这些库之间进行切换。JAX 支持并行计算,可以在多个硬件设备(如 GPU 和 TPU)上进行计算,从而实现更快的运算速度。
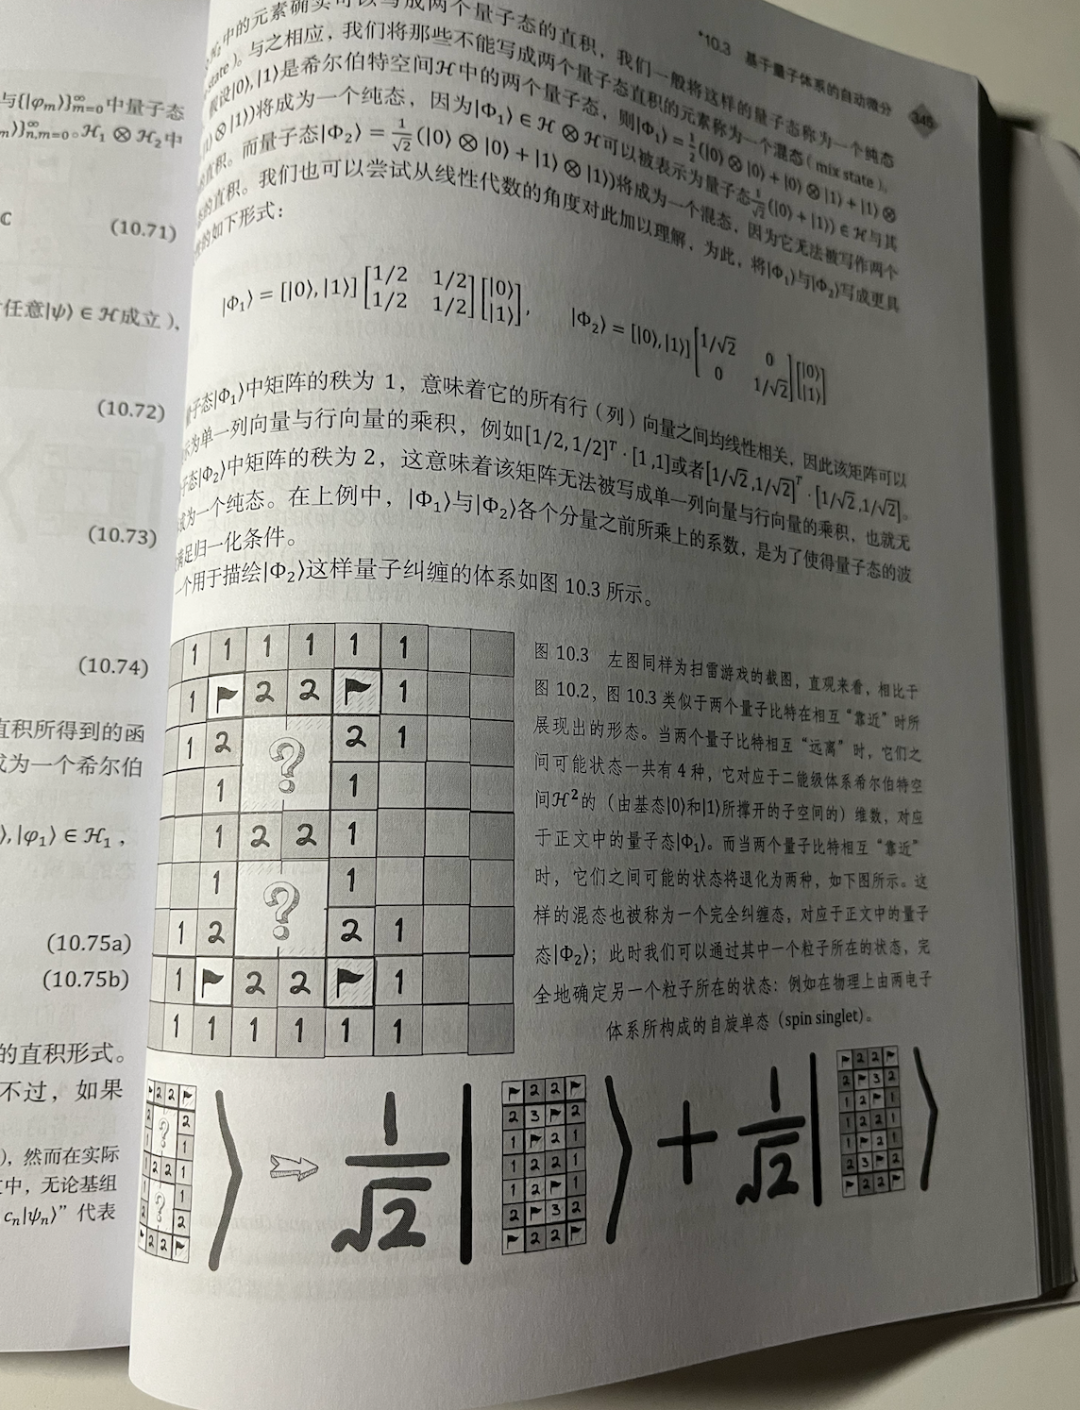
在本书的末尾,作者也对量子计算做了简单的介绍。量子计算是一种计算范式,它使用量子比特(qubits)来执行计算,而不是使用经典计算机使用的二进制位。量子计算的基础是量子力学,这是一种描述微观世界(例如原子和亚原子粒子)行为的物理理论。量子计算试图利用量子力学的一些特性来解决一些计算问题,这些问题对于经典计算机来说是困难或不可能解决的。
在经典计算中,信息被编码为二进制位,每个位是 0 或 1。在量子计算中,信息被编码为量子比特,或 qubits。一个量子比特可以处于 0 和 1 的状态,或者同时处于这两种状态。这就是所谓的叠加状态。叠加原则允许量子比特处于多个状态之间的叠加。这意味着一个量子系统可以存在于多个状态之间,直到进行测量,系统才会塌缩到一个特定状态。这种特性使得量子计算机能够并行处理大量信息。纠缠是量子系统中的一个特性,其中两个或更多的粒子可能会变得如此关联,以至于一个粒子的状态会立即影响另一个粒子的状态,无论两个粒子之间的距离多远。这个奇特的现象可以被用来在量子计算机中进行并行操作和复杂的算法。目前,量子计算仍处于研发阶段,但许多科学家和研究机构都在努力发展这个领域。如果能够实现,量子计算有可能对加密、材料科学、药物发现和机器学习等领域产生重大影响。在量子计算里面,它的自动微分与经典的自动微分有着明显的区别,作者对这一块也做了相应的解释。
总结
Jax 是一款强大的 Python 库,它将高效的数值计算,自动微分,以及加速硬件的支持结合在一起,为研究者和工程师提供了一个无与伦比的工具集,以探索和实现复杂的算法和模型。利用 Jax,我们可以用透明、灵活的方式进行可微分编程,并利用其自动微分功能来快速有效地计算函数的导数或梯度。更重要的是,Jax 提供了对 GPU 和 TPU 等高性能硬件的支持,这使得我们可以在这些设备上进行大规模的数值计算。总的来说,无论你是在进行深度学习研究,优化复杂系统,还是解决数值密集型问题,Jax 都能成为你的强大助手,为你的项目注入新的动力和创新可能。
欢迎大家关注公众账号数学人生
(长按图片,识别二维码即可添加关注)