©PaperWeekly 原创 · 作者 | 孔楚伊
基于真实用户与 ChatGPT 的互动,通过反转学习目标(从学习回复到学习提问),训练更贴近真实用户的模拟器,更好的提问质量可以激发 ChatGPT 的更大潜力。在流行的 Alpaca Eval benchmark 超过 GPT 3.5,在 MT-bench 上得分 6.33,强于 Vicuna 新版。在这两个 benchmark 都是是基于 LLaMA 2 7B 底座的 SOTA。
ChatGPT 的多轮对话能力和指令理解能力让公众更广泛地接受来这一产品,但是因其闭源,社区在努力做民主化 ChatGPT 的尝试。例如,Vicuna 通过利用真实用户和 ChatGPT 对话的 ShareGPT 数据集来快速开源大模型的对话能力,效果显著。然而,由于近期 ShareGPT 官方不再允许用户从其上爬取数据,最近的工作则(如 Baize 和 UltraLM 等)通过提示的方式让 ChatGPT 进行角色扮演,以模拟用户和助手模型,自动生成对话数据。
粗略地讲,影响训练助手模型性能的因素有两方面。一方面,用户问题的质量是可以影响模型的效果,例如 Wizard 中用户的复杂指令可以比 Alpace 指令可以更好地训练助手模型。ChatGPT 用户模拟器并不能保证可以足够激发 ChatGPT 助手模型的足够的潜力。
即使可以设计一些精细的 prompt 来让 ChatGPT 所扮演的用户模拟器提供某种类型的问题,其在提问过程中也是即兴的,难以保证 ChatGPT 所扮演的用户模拟器的提问能够达到满意的程度。并且,用户模拟器用来激发大模型能力的提问方式一定程度上是抽象,难以通过文本 prompt 来具象化。
另一方面,用于训练数据的分布是否贴近真实的使用场景同样影响训练后的助手模型能性。通过角色扮演,ChatGPT 作为用户模拟器可能不能贴切地模拟真实用户的信息需求,特别是在和 ChatGPT 这种助手模型提问时的思路。
这使得训练出的助手模型并不能和与真实用户交互时 ChatGPT 的表现一致。因此,需要构建一个用户模拟器通过建模用户的真实意图和提问思路,以此充分激发助手模型的回复能力。
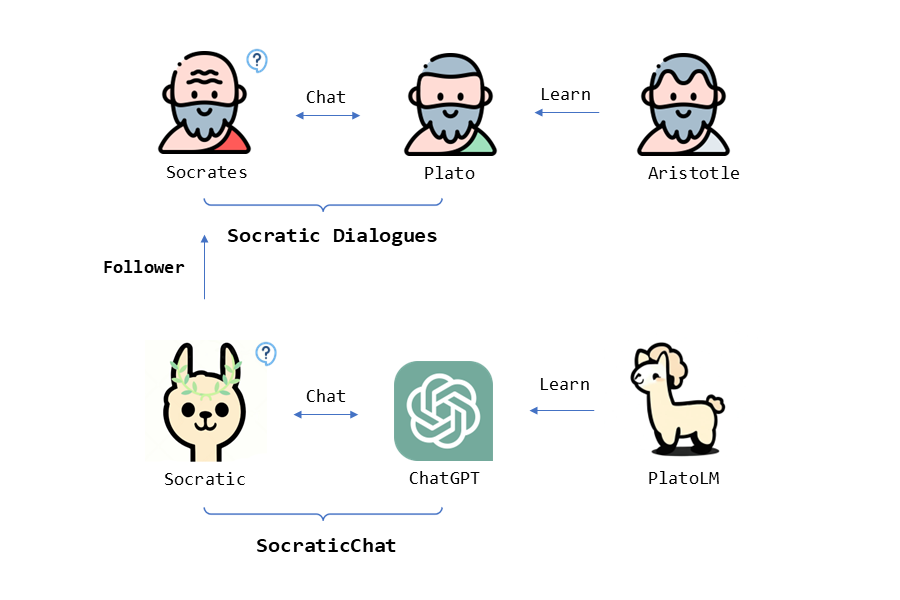
考虑到以上两个方面,我们联想到利用苏格拉底式提问来命名我们的方法,苏格拉底式提问是老师教学生的一个经典方法,通过连续提问来充分激发学生的能力,促进学生的思考。在大模型训练的场景是,学习一个用户模拟器专门去给 ChatGPT/GPT4 助手模型连续提问,通过学习助手模型的输出来高效蒸馏一个开源模型。在苏格拉底式提问中,苏格拉底的下一轮问题可以比上一轮更复杂,更具体或者联想到更高层次,以此充分帮助学生思考并做出更好的回复。
受此启发,我们尝试将此方法迁移到用户模拟器激发 ChatGPT 更好回复的场景中。同时,为了保证拟合真实的用户信息需求和相应的分布,我们通过构建 Vicuna 的对称模型 Anuciv 作为苏格拉底模拟器。Vicuna 是学习 ShareGPT 中的助手模型,而 Anuciv 则是学习 ShareGPT 中的用户模型。通过 Anuciv,我们就可以构建任意规模的贴近真实用户-ChatGPT 对话的数据集。
香港中文大学(深圳)和深圳市大数据研究院所在的王本友教授团队,通过在高质量的人机对话数据集 ShareGPT 上,仅计算人类提问的损失来反转学习目标,基于 LLaMA 基座,全微调训练出一个名为 “Socratic(苏格拉底的信徒)”的用户模拟器(也就是上文中的 Anuciv)。随后,通过迭代调用 Socratic 与 ChatGPT 获得了高度类人的人机对话数据集 SocraticChat,并在该数据集上训练出表现优越的助手模型 PlatoLM。
https://arxiv.org/abs/2308.11534v4代码地址:
https://github.com/FreedomIntelligence/PlatoLMhuggingface数据集地址:
https://huggingface.co/datasets/FreedomIntelligence/SocraticChathuggingface模型地址:
https://huggingface.co/FreedomIntelligence/PlatoLM-7B该论文提出的模拟器训练方法,可以使用户模拟器在基于上下文背景下持续追问,与在无上下文背景下自主提问之间灵活切换,这使其不仅具有良好的迁移领域的能力,将任何单轮对话扩展成多轮形式,还能够扩展 ShareGPT 数据集的规模和多样性。
此外,他们发现,Socratic 提出的问题的复杂性可以随着多轮对话的进行循序渐进地提高,并由此激发 ChatGPT 自动 ICL 的能力,这与苏格拉底式质疑——通过提问者由浅入深地提问来启发回答者思考的过程——不谋而合:
他们认为经过人类高超的 prompting 技术微调知识丰富的 llama backbone 后的高度类人的模拟器 Socratic 可以类比为苏格拉底,模拟器与 ChatGPT 之间的对话所形成的数据集 SocraticChat 可以类比为对话录(柏拉图所记载的苏格拉底启发人类思考的对话体文集),学习 ChatGPT 的回答的助手模型 PlatoLM 可以类比为柏拉图,整个 pipeline 可以类比为苏格拉底式教学。
教学方法论
基于苏格拉底式质疑的用户模拟器的教学方法论分为三步,如方法论对比图所示,他们的第一步与第三步是对称的。
1. 训练用户模拟器
与训练助手模型相反,他们遮蔽了用户的提问,计算其损失,修改学习目标为人类的提问,并基于 llama 基座,使用与训练助手模型对偶的提示模板,微调模型 Socratic。在切割 ShareGPT 数据集中超过 2048 最大上下文长度的多轮对话样本时,使切割后的 segments 以 gpt 开头。最终 human 和 gpt 开头的多轮对话样本的分布大致平衡,这使模拟器可以在基于上下文背景下持续追问,与在无上下文信息下自主提问之间灵活切换。
2. 合成对话SocraticChat
在推理时,他们引入了两种教学方法,分别为自由模式和种子模式的教学。对于前者,苏格拉底可以无需任何上下文作为引导,自由提出质疑;而种子模式则是指,以其他数据集的单轮对话作为种子,继续追问。
此外,他们指出,当迭代调用用户模拟器和 ChatGPT API 时,会不可避免地出现何时终止对话的问题。由于 ShareGPT 数据集的特殊性 —— 即无从判断一个对话的结束是否为一个话题的结束 —— 他们采用了硬控制的方法,换句话说,当上下文长度超过最大长度 2048 后,结束对话。
3. 训练助手模型PlatoLM
与大多数训练助手模型的方法一致,他们遮蔽了助手的回答,计算损失,并基于 llama 基座微调模型。
实验结果
为了评估该范式的优越性,他们分别根据模拟器的教学方式,对基线和消融的结果模型和各模拟器合成的数据集进行了评估。
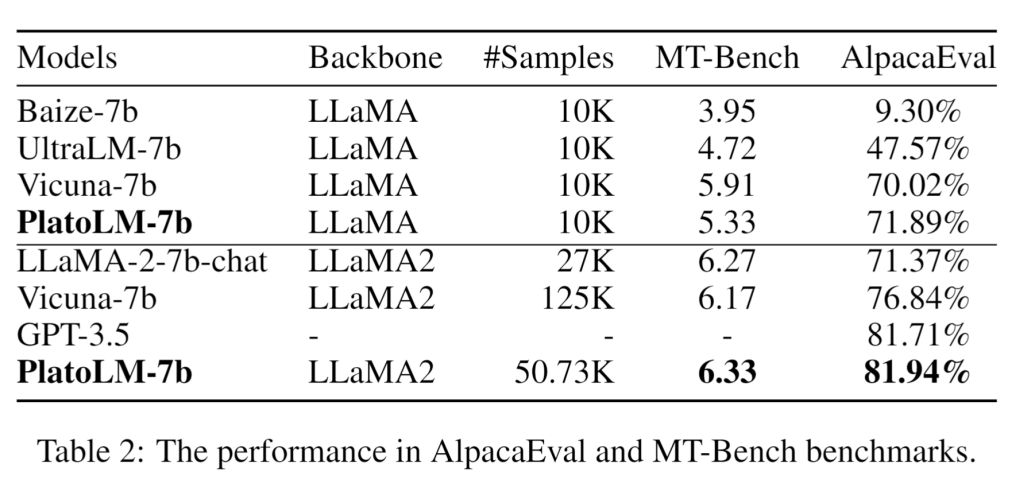
对于基线模型,首先保证使用同等数量的样本(10K)、同样的训练方式(SFT)、同样的基座模型(llama1)进行评估,结果证明:自由模式的PlatoLM在单轮 benchmark(Vicuna-Bench、Alpaca-Eval)上超越了基线模型(Vicuna、Baize、UltraLM),在多轮 benchmark——MT-Bench 的双评中超越了所有基线模型,在单评中仅次于 Vicuna(由于 MT-bench 对于分差较大的 domain 采用了惩罚机制)。人评与双评有较高的一致性。
之后,他们使用 ScoraticChat 的全部数据集,基于 llama2 进行训练,在 MT-bench 和 Alpaca-Eval benchmark 上,以更少的样本量(50K)、更短的上下文长度(2048)超越了同等规模的基线模型,最终在两个榜单的 7B 规模模型中排名第一(现在第二),在 Alpaca-Eval 榜单中,甚至打败了 GPT3.5 和一些 13B 模型(LLaMA2 Chat 13B 等)。
对于消融模型,他们以对话两端分别为人机、人人、机机的数据集的单轮对话 ShareGPT、Dolly、Evol-instruct 作为种子,引导模拟器,发现经过引导的模拟器的后续提问具有对应数据集域的特性,这证明了模拟器 Socratic 具有可迁移性。
此外,他们也发现,尽管 Evol-instruct 的种子问题为人类所提出,但经过 WizardLM 多轮的改写后,提问的类人性大大降低,因此以 Evol-instruct 引导的 PlatoLM 表现不如经过 Dolly 和 ShareGPT 引导的 PlatoLM。最后,他们指出,尽管种子模式的模拟器 Scoratic 容易受限于种子的规模,自由模式的模拟器不受该限制,但种子的规模问题可以通过 ensemble 来解决。
对于蒸馏出来的 ScoraticChat 数据集,他们以同等规模的样本对其进行了统计,发现:ScoraticChat 相较于 Baize、UltraChat、Vicuna 在语料库层面的统计量(词库大小、平均轮数、平均 session 长度、平均 utterance 长度)上表现最好,在提问层面的统计量上,提问的复杂性、相关性(使用 ChatGPT 评估)第一,提问的类人性(使用 ChatGPT 检测器评估)与话题多样性(使用降维后的余弦相似度评估)仅低于 ShareGPT。
样例参考
从例子中,用户第二个问题是第一个问题的进一步的问题,以及第三个问题也是基于前面问题的更深入的问题,类似于苏格拉底提问的风格。以第三个问题为例,它要求答题者不只是简单地列举服务,而是深入思考和评估这些服务的重要性。这样的问题鼓励答题者深入反思、评估和对比不同的服务,从而得出结论。这正是苏格拉底提问法追求的目标:通过提问促使人们深入思考和自我探索。
如何才能让更多的优质内容以更短路径到达读者群体,缩短读者寻找优质内容的成本呢?答案就是:你不认识的人。
总有一些你不认识的人,知道你想知道的东西。PaperWeekly 或许可以成为一座桥梁,促使不同背景、不同方向的学者和学术灵感相互碰撞,迸发出更多的可能性。
PaperWeekly 鼓励高校实验室或个人,在我们的平台上分享各类优质内容,可以是最新论文解读,也可以是学术热点剖析、科研心得或竞赛经验讲解等。我们的目的只有一个,让知识真正流动起来。
📝 稿件基本要求:
• 文章确系个人原创作品,未曾在公开渠道发表,如为其他平台已发表或待发表的文章,请明确标注
• 稿件建议以 markdown 格式撰写,文中配图以附件形式发送,要求图片清晰,无版权问题
• PaperWeekly 尊重原作者署名权,并将为每篇被采纳的原创首发稿件,提供业内具有竞争力稿酬,具体依据文章阅读量和文章质量阶梯制结算
📬 投稿通道:
• 投稿邮箱:hr@paperweekly.site
• 来稿请备注即时联系方式(微信),以便我们在稿件选用的第一时间联系作者
• 您也可以直接添加小编微信(pwbot02)快速投稿,备注:姓名-投稿
△长按添加PaperWeekly小编
🔍
现在,在「知乎」也能找到我们了
进入知乎首页搜索「PaperWeekly」
点击「关注」订阅我们的专栏吧