小伙伴们大家好,今天我给大家讲一下深度学习快速入门到发文的全流程。详细的讲讲新手小白三个月内每个时间段完成哪些任务,就可以发表一篇论文。
欲速则不达,不动也不达,这是我在科研过程中的一个感受。如果不能确定好短时间内要完成什么任务,那么长时间都会处于内耗和迷茫中。
现在将任务落实到每一周,或许会有不一样的结果。
基础学习
科研之路从来不是一帆风顺的。第一个月可能会遇到代码跑不通的挫折,第二个月可能会为找不到创新点而焦虑,第三个月可能会为实验结果不理想而沮丧——这些都是完全正常的科研过程。
1-2周 Python/pytorch环境搭建 + 深度学习理论基础学习
安装python/pytorch/Anaconda环境+开发工具:vscode或者pycharm (csdn搜一下安装即可)
(1)理论学习:学习深度学习的基本概念:tensor张量、前向传播、反向传播、激活函数、损失函数、优化器等。
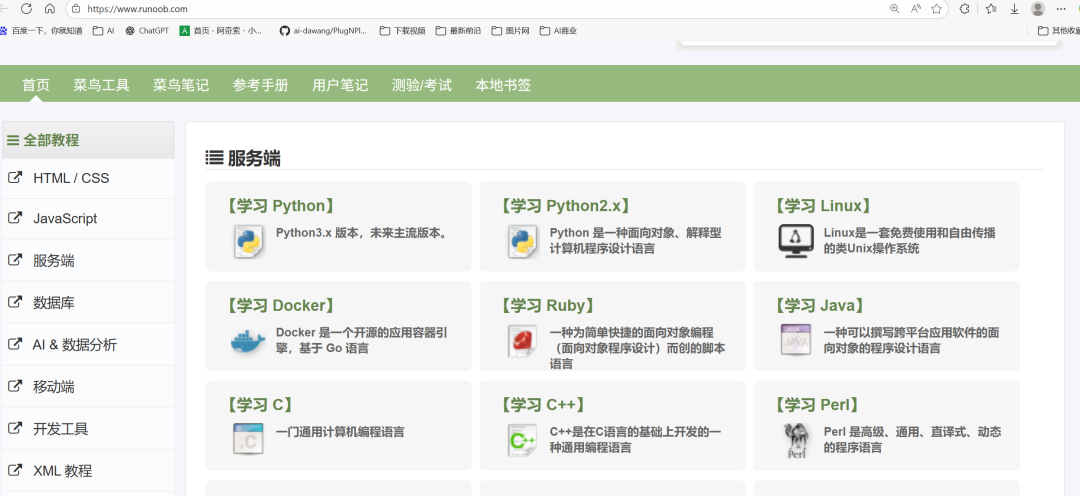
(2)Python学习:菜鸟教程网站(https://www.runoob.com/),随便看个两天就行
(3)Pytorch学习:直接看b站小土堆视频即可,也可以看一下菜鸟教程
这一阶段的目标只有一个:环境能跑通,代码能执行,你就已经成功了一大半。”
项目复现
第3周,我们就来做人生中的第一个项目复现!”
“具体怎么做?很简单呢
1️⃣ 找个项目:
上 GitHub,随便找一个入门级的开源项目。推荐 ResNet50 图像分类,经典又好跑。
2️⃣ 照着文档跑:
一般项目都会有 README,告诉你怎么装依赖、怎么准备数据、怎么训练测试。你就老老实实一步一步跟着做。
3️⃣ 能跑通就算成功:
别想着自己改动啥,能用自带的数据集跑通就行
记住一句话:跑通比看懂更重要。很多科研人都是先把代码跑起来,再慢慢去理解为什么这样写。
经典模型学习
第4周,我们来啃点硬货。”
“这一步的核心目标:把深度学习领域的两大里程碑模型搞明白。
1️⃣ ResNet(2015)
这篇论文奠定了后面一大堆卷积网络的基础。
2️⃣ Attention is All You Need(2017)
这就是 Transformer 的开山之作。
提出注意力机制,直接把自然语言处理推上了新高度。
后来火遍全世界的BERT、GPT,其实都是在它的基础上发展起来的。
这两篇论文,一个是卷积的巅峰,一个是注意力的开端,科研人必修课。”
“有人说,深度学习的世界分两种:
ResNet之前,大家都在堆卷积;
Transformer之后,大家都在堆注意力。
一周的时间,让你读懂两篇论文,不过分吧!!!
领域聚焦和文献调研
第5-6周,精读几篇综述论文,理解自己的研究方向并深入理解该领域的前沿进展:下载10篇自己方向的研究生毕业论文,了解和下载常用数据集,精读自己研究方向的经典和前沿论文。
1️⃣ 看综述论文
精读几篇本领域的综述,快速摸清楚大家都在研究啥、现在的热点在哪。
综述就像武林秘籍的目录,一下子告诉你全局。
2️⃣ 扒毕业论文
下10篇硕士、博士论文(最好是跟你方向相关的)。
为什么?因为学长学姐写的毕业论文,通常就是一条研究路线的浓缩版,带着数据集、实验套路、方法改进,信息量非常大。
3️⃣ 熟悉数据集
把你方向里常用的数据集下载下来,看看数据长啥样。科研的本质就是‘数据+方法’,数据集就是你的练武场。”
Baseline模型选择
第7周,从读的经典或者前沿论文(近2-3年)中,选择一个模型当作基础模型,复现。选择代码好复现的,后续我们只需修改网络代码就行了。
1️⃣ 时间线要新
最好是近2-3年的论文,别去复现十年前的冷门模型。越新的方法,社区讨论越多,代码越全,出bug的几率越小。旧模型不仅bug,还可能被审稿人质疑。
2️⃣ 能跑得通
有公开代码、数据集,最好带README。代码不开源,论文夸的再好你也没法复现。复现门槛低一点,别选那种连依赖都写不全的项目。
3️⃣ 后续好改动
记住,我们的科研套路就是在Baseline上‘缝缝补补’,加点模块、换点结构。
所以要选一个结构清晰、容易魔改的模型。
“选好Baseline之后,科研的灵魂来了——做实验。实验是验证创新点的唯一标准。只要能涨点,就能发文章!!!
实验
“做实验就像打游戏开装备,造梦西游很多人应该都玩过吧:
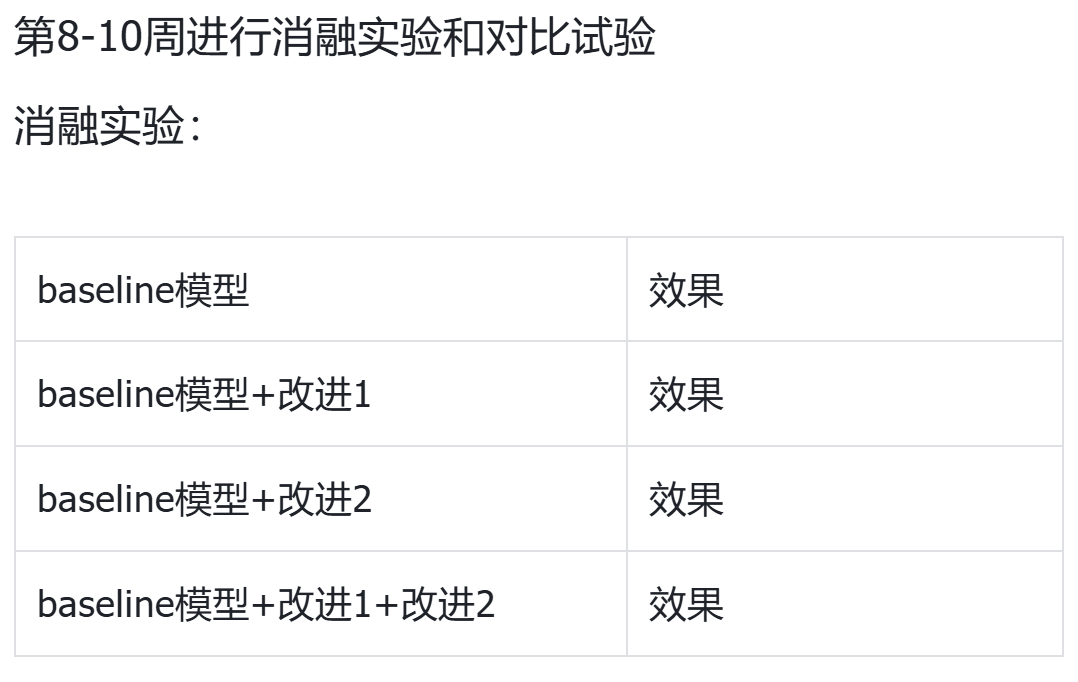
消融实验 = 一个一个给角色加装备,看战力涨没涨。加个武器涨多少,加个头盔涨多少
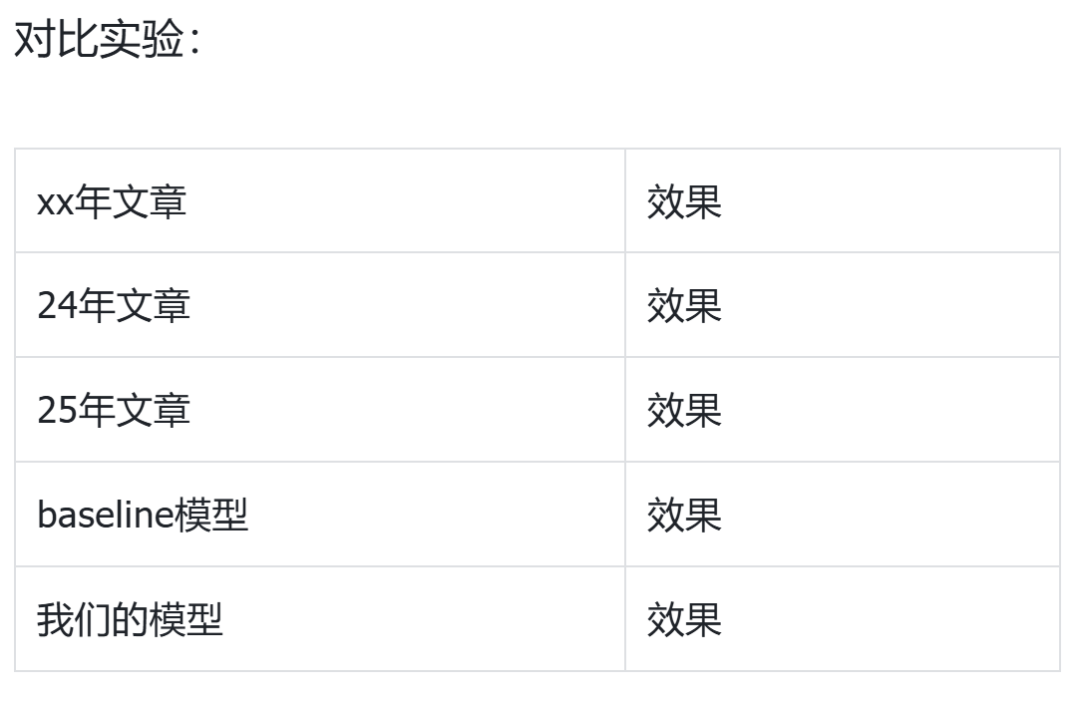
对比实验 = 跟别的玩家比战力,证明你这套装备更强。
“前面六步走完,你的科研积累已经很扎实了:有基础、有代码、有Baseline、有实验结果。那最后一步,就是把成果写成论文,然后冲击一下会议或期刊。第11到12周,我们就来搞:写论文 + 投稿。”
写论文+投稿
第11-12周:确定目标会议或期刊
制作高质量的图表和可视化结果,论文图用开源的PPT画图模板即可
戳写论文,用在线的overleaf网站(https://cn.overleaf.com)写即可,非常方便
INTRODUCTION
介绍该研究方向
The main contributions of the proposed method can be summarized as follows.
1) 我们提出了xx模型,在公共数据集xx和xx上取得了很好的效果,我们有更少的参数和flops。。。。。。
2)我们提出了xx模块,通过频域和空间域相结合,该模块融合了xx(频域)和xx(mamba)的优点,可以充分提取xx特征,进而xxx。
3)我们提出了xx融合方式,我们提出了xx FFN模块等。
RELATED WORK
介绍相关工作,文献综述
METHODS
介绍模型和模块
EXPERIMENT
实验条件设置
消融实验
对比实验
CONCLUSION
本文xxx
论文投稿
即使三个月最终没有按时投稿论文,这个过程中获得的知识、技能和经验也是无比宝贵的。
坚持每天进步一点点,保持好奇心和韧性,你会发现自己在这三个月中的成长远超预期。相信按照这个计划执行,你一定能够在深度学习领域打下坚实基础,为研究生生涯开个好头!
个人建议
对baseline模型进行改进。我们做的就是改网络结构,模块A +B +C ,串联 、并联 、交互多种缝合方式,CNN 、Attention、fft、mamba、特征融合都可以融合改进。A+B模块之后,改个名字就是自己的模块了,这就是创新点!
详细视频讲解可以看哔站的ai缝合大王
eg: FFT频域一个模块 + Mamba一个模块+CNN一个,命名为频域辅助的局部全局特征融合模块。
100+即插即用模块:(ai缝合大王)Github开源地址:https://github.com/ai-dawang/PlugNPlay-Modules
(不用考虑创新性,只要涨点就可以,只要涨点,故事随便讲。 流水线一样组装模块发论文)
除了读顶会论文,可读一些二区三区的文章,看看他们是怎么写论文的,怎么写创新点的。
对比的模型可以选择一些,近一两年发的,但性能较差或者参数非常多的模型做对比。发个二三区完全没必要同sota模型做对比,sota不是发论文的必要条件。
GPU资源少的话,可以租GPU或者做轻量化模型。实验进行慢的话,可以随机选取数据集的1/10,在这个小数据集上迭代实验。
最后的最后,为了方便大家交流,我建了 20多个细分方向的粉丝互助交流群,包括目标检测、nlp、图像超分、时序等等,大家可以一起讨论怎么在自己的细分赛道如何水论文、写论文、做实验等等。并且群里会不定期分享论文常用数据集、baseline模型,最新模型复现,即插即用模块等。需要的小伙伴可以扫描下方二维码进群。