强化学习(Reinforce Learning, RL)是机器学习谱系中独立于有监督/无监督学习外的第三类范式,核心框架由环境-智能体构成,并强调智能体通过与环境直接互动进行学习,而不需要可效仿的监督信号或对数据结构的利用。
具体而言,其使用马尔可夫决策过程(Markov Decision Process, MDP)作为数学模型,使用环境状态(State)以及智能体采取的动作(Actor)、从环境获得的奖励(Reward)定义交互过程。
本文主要介绍 RL 的框架与运作机制(环境-智能体)、核心概念(如探索-利用)、来源(三条河流)、在机器学习谱系中的位置(独立与有监督、无监督外的第三范式)、在人工智能谱系中的位置(与符号主义、连接主义并列的行为主义)、RL算法的基本类型等常识性内容。
1 RL框架
强化学习原则是个体时序维度上极简版的边沁功利主义,也是普通人发展的黄金法则。基本世界观和概念如下。
1.1 框架图
下图为 RL 的一般性框架示意图,主要分为智能体和环境两个单位,各自有两种内在功能(函数、概率分布)。智能体 Agent 内部的两个功能中,策略Policy代表即时决策的能力,价值Value代表长远规划的能力;环境Environment中的奖励函数代表环境对智能体的奖惩反馈机制,而状态转移则代表环境自身状态转换的机制。
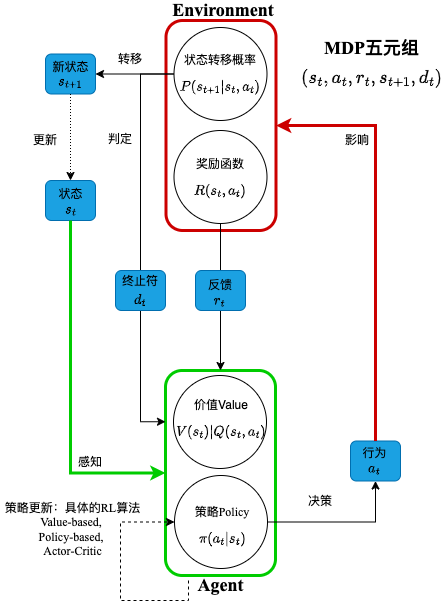
智能体在和环境的交互中,每轮产生一个MDP五元组(图1蓝色方块),即RL训练中在线一次采样得到的数据。设当前时间步为t,则:
- • (3)动作施加到环境,根据环境当前的状态 和智能体当前的动作 ,驱动环境内部的两个功能:奖励函数给出即时奖励 ,环境也根据显式或隐式的P更新到新的状态 。
- • (4)至此在当前策略下采样得到一轮完成的数据。在线(on-policy)的方法就马上用这组数据进行学习。
注意,在不同的教材中,对于奖励的下标是 还是 有不同,本系列采用前者。
1.2 贯序决策
世界运转的机制被简化为 决策-环境反馈-基于反馈再决策 的 个时间步的决策序列。在强化学习中,决策序列就是训练数据,往往需要通过采样得到。一个决策序列就是一个样本(sample),也被称为轨迹(trajectory)、幕(episode)。
1.3 二元结构
整个世界二分为智能体与环境,两者相互依赖与影响。环境代表强化学习场景中的世界规则系统,而智能体则是该世界规则下的学习者,学习的最终目标是最大化智能体通过一系列动作可以获得的奖励。
1.3.1 环境
环境是智能体所处的客观环境,是世界规则的具象,主要由状态转移和奖励两大机制构成。
- • 状态转移机制 :环境状态 是变化的,不同的环境状态构成状态空间,是智能体行动的前提条件。受智能体行动影响,状态之间以某种概率进行状态转移 )。不同的任务中,这一状态转移机制对智能体的透明度、可用性不一。根据智能体的学习是否依赖于状态转移,RL 范式可以分为基于环境模型的(model-based)和免环境模型的(model-free)强化学习两类。
- • 奖励机制 :环境根据当前状态 s 对智能体的单次行动 a 提供及时的奖励反馈 R(s,a)。强化学习环境的奖励量化定义是最困难、最核心的部分。
1.3.2 智能体
是环境中具有能动性的学习者,通过感知环境状态 并通过采取行动 a 获得环境的即时奖励 r 进行试错学习 (trial-and-error)。主要具备及时行动策略和长期价值评估两大能力:
- • 策略 :智能体根据外部环境状态 s ,基于自身策略(策略模型,学习的实体)进行行为决策 得到行为 ,执行后影响环境状态。
- • 价值:智能体基于环境和自身策略的长远评估,区分为状态价值 和动作价值 ,用于指导学习过程进而实现长期收益最大化目标,即从当前状态开始对将来累积总收益的期望。
2 核心概念
RL是一系列思想、方法的集合,聚焦于回答 学习怎么做才能使长期收益最大化。这类问题因为通常不能预先获取明确的正确动作示例(监督学习标签)而必须通过交互在经验中边干边学。强化学习系统的核心结构是环境的奖惩机制与智能体的试错学习机制。前者对智能体的单次行为给予量化奖惩值,后者则是智能体在奖惩机制下寻求序列决策收益最大化的行为范式。
一个具备学习能力的智能体必须能够感知环境、采取动作影响环境、拥有和环境相关的明确目标。这种特征可以用马尔可夫决策过程(Markov decision process,MDP)进行数学建模,其包含了三个核心特征:感知、动作、目标。RL的核心特征有两个:
- • 长期主义:RL在贯序决策中,追求长期收益最大化,而不应拘泥于一次行为获得单次奖励。有点类似快乐和幸福的关系。因此智能体每次决策必须考虑对未来的影响,例如棋手落子前必须考虑对手的反制以及后几步的可能。
- • 适时走出舒适区。一味探索可能会错失已拥有的幸福,小富即安裹足不前则难成大气,因此智能体必须能够在试错学习中权衡两者,即权衡 探索-利用。探索(explore)指的是智能体在单次决策中尝试一些目前非最优的动作,以拓展轨迹的组合形态从而发掘潜在的更优的动作;利用(exploit)则代表智能体在单次决策中采取当前已知的最优动作以获得目前最高的奖励。
3 现代强化学习三条河流
现代强化学习由三条河流汇聚而成:
- • Error Correction错误纠正:最早起源于1894 Law of Effect,1927 巴普洛夫的狗(动物可以学习到刺激和奖励的关系)等动物心理学研究。
- • Trial-and-error Learning试错学习:1898 Operant Conditioning(动物学习依靠trial and error,而不是insight)
- • 最优控制和动态规划:20世纪50年代始。迭代求解贝尔曼方程。已知系统是随机动态的,控制系统以优化某一目标。
- • 时序差分学习(Temporal-difference learning, TD learning):20世纪50年代始,1984年由Sutton正式提出。不同时间对同一值预测的差异驱动调整预测,根据未来对结果的估计更新当前的估计。TD error = 即时奖励 + 当前对未来奖励的估计 - 之前对未来奖励的估计
1989年,Chris Watkins提出 Q-learning,三条河流汇聚。
4 机器学习第三范式
强化学习 (Reinforcement Learning, RL) 不同于传统的预先收集数据以及标签的有、无监督学习,强调在与环境交互中获取反映真实目标达成度的反馈信号。强化学习更加侧重于以交互为导向进行学习,一般而言,研究者倾向于将强化学习定义为独立于有监督、无监督外的第三种机器学习范式:
- • 有监督学习:拟合 input-output 映射规律。模型从外部提供的带标注训练集中学习,例如分类与回归。显然,将输入视作环境,输出标签视作针对当前环境模型应当做出的正确动作,这种学习范式可以解决一部分简单的、明确的智能体根据环境采取动作的问题。
- • 无监督学习:寻找未标注数据中隐含结构。基于数据的特征表示,例如聚类,降维。
- • 强化学习:在动态交互和序列决策场景下最大化收益。从智能体自身与环境交互的经验中学习。
- • 不同于有监督:无法为智能体提供明确 环境-动作 对。
- • 不同于无监督,探索智能体经验基于特征的结构有一定意义,但不能解决最大化收益信号问题。
5 人工智能三大流派
此外,人工智能在长期发展中,关于 “什么最有可能产生真正的智能” 这一方法论问题的分歧形成了三种相对核心的流派:
- • 符号主义学派:以逻辑推断和贝叶斯学习为代表。20 世纪主流学派,尤其是专家系统和经典机器学习理论的大量成功应用。
- • 联结主义学派:以神经网络为代表。一波三折,直到 21 世纪初深度学习理论提出后,借助 GPU 与大数据才迅速产生巨大的产业技术红利。
- • 行为主义学派:以控制论、强化学习为代表。其中控制论在上世纪 40-50 年代就催生了工业自动控制,但并不被视作智能。
目前以联结主义的神经网络为代表的深度学习是主流,但在许多改良性研究中出现了融合的趋势:
- • 联结主义 + 符号主义:将神经网络的“黑箱学习”与先验知识、符号推理和经典机器学习相结合,实现可解释、可推理、可操控的“白箱学习”。例如目前非常热门的 LLMs + KGs。
- • 联结主义 + 行为主义:从数据与模型独立的“开环学习”到动态交互、在线试错、数据产生与模型优化紧密耦合的“闭环学习”,代表为强化学习。例如目前最热门的 Agent + RL。
6 RL方法分类
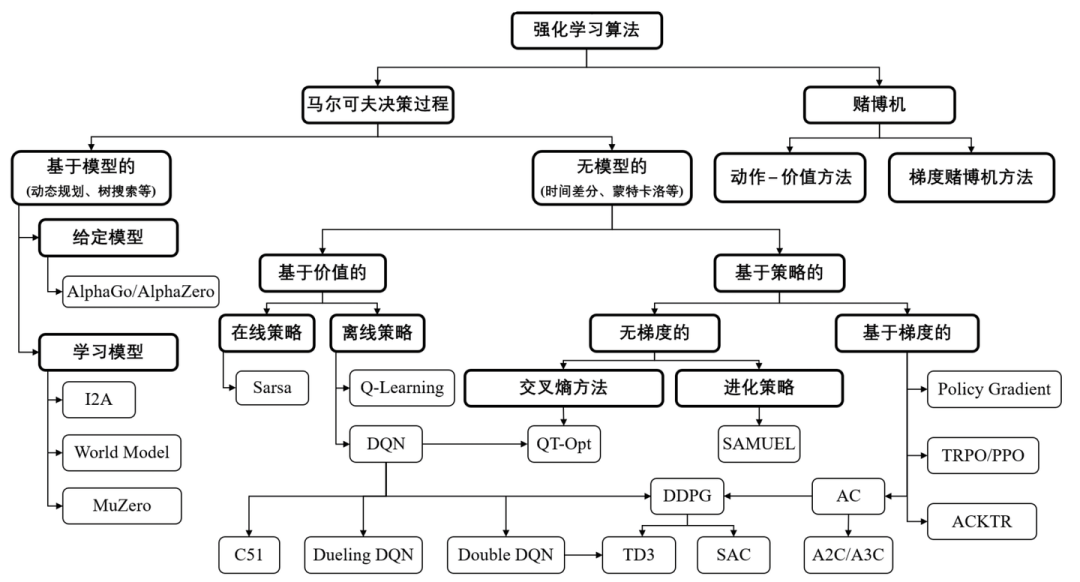 图源网络
6.1 环境无状态:MAB
图 1 为主流的强化学习框架图,符合马尔可夫决策过程MDP定义。如果环境没有状态,则退化为最简单的多臂老虎机(MAB)模型。
6.2 环境有状态:MDP
在MDP框架下,根据环境是否有显式的状态转移矩阵或函数P,分为两大类。
6.2.1 基于模型(model-based)
相对理想、简单的RL,有显式的P。环境模型已知,往往采用规划的方式如动态规划,在真正经历前考虑各种情形从而预先决定采用何种动作。
6.2.2 免模型(model-free)
目前主流的相对复杂的 RL,没有显式的P。环境模型未知,需要Agent采用试错(trial-and-error)的方式采样真实世界数据(经验)来学习,可以通过优化 Agent 内部的价值或者策略函数实现学习。
6.2.2.1 基于价值 value-based
采样交互数据,估计价值函数V学习动作选择,策略不存在显式目标,根据值函数导出策略,例如贪心选择价值最大化动作。数据采样根据是否来自当前实时策略分为:
- • 在线策略(on-policy):即时经验,高度依赖交互环境
- • 离线策略(off-policy):经验回放,利用已有的数据和经验,减少对环境的交互需求。
6.2.2.2 基于策略(policy-based)
通过估计给定状态下采取某个动作的概率分布,直接显式地学习目标策略。根据策略模型是否为基于梯度下降优化的神经网络,又可以分为两大类。
(1)无梯度方法
非深度学习,适用于小参数空间,直接搜索参数空间。根据通过参数变异选择还是采样分布,分为:
- • 进化策略:遗传算法,生成一组策略参数的候选解(种群),对候选解评估(通过环境交互或仿真),根据评估结果选择性能较好的候选解,并基于它们生成下一代种群。
- • 交叉熵方法:随机搜索。通过不断调整策略参数的分布,使其更集中于高性能区域。通常使用高斯分布更新策略参数的分布。
(2)基于梯度的方法
深度学习,参数空间大,梯度上升优化。如目前炙手可热的大模型强化学习。基于策略的RL中,通过损失函数设计直接对参数化策略进行梯度优化,价值函数则融入损失函数设计,如早期的策略梯度和后来的基于优势函数的方法(PPO)。策略梯度更新方法根据如何计算价值分为:
- • 蒙特卡洛(Monte Carlo, MC):直接累加奖励。如策略梯度reinforce算法,核心是随机采样n条完整轨迹计算累积回报,即价值,无偏但高方差。
- • 时序差分(Temporal Difference, TD):用价值函数作为baseline缓解蒙特卡洛高方差问题。如Actor-Critic架构的PPO,通过自举 bootstrapping 用当前价值函数估计回报,结合即时奖励和下一状态价值函数有偏但方差低。



