❝开头还是介绍一下群,如果感兴趣PolarDB ,MongoDB ,MySQL ,PostgreSQL ,Redis, OceanBase, Sql Server等有问题,有需求都可以加群群内有各大数据库行业大咖,可以解决你的问题。加群请联系 liuaustin3 ,(共3300人左右 1 + 2 + 3 + 4 +5 + 6 + 7 + 8 +9)(1 2 3 4 5 6 7群均已爆满,开8群近400 9群 200+,开10群PolarDB专业学习群100+)
昨天群里有人问,想试用一下PolarDB 但是希望能用更经济的价格来进行使用,这里我和阿里云申请了7.5折扣的卷,购买PolarDB 可以7.5折购买。复制下方链接,即可优惠试用https://www.aliyun.com/minisite/goods?userCode=qyua9rvi
https://www.aliyun.com/minisite/goods?userCode=qyua9rvi
上期内容
全网最专业PolarDB-MySQL 大SQL解决方案--之如何添加列式索引 (一)
PolarDB for MySQL IMCI 部分的内容,除了阿里云,我自认为这个系列目前我是最专业的,有哪些地方解释的不对,还请阿里云的研发老师指正。
最近开始在大量的应用PolarDB的IMCI的功能,多个业务线在并发,都在测试。不同的业务线测试的结果可能也不尽相同,使用的方法和方案也都有各自的特点。
我特别想把PolarDB的IMCI推广的更好,让更多的业务享受到PolarDB的插件化数据库的特性。这里我准备写几期帖子,把我研究的部分也都和大家一一展示,如果有同道中人,也可以反馈您的使用中的问题,我们一并和阿里云的老师进行沟通,相信他们会做出更好的功能并逐步完善他。
今天我们是IMCI的第一集,IMCI的原理,与问题的解决方案。MySQL在SQL的执行解决方案中,一直是令人诟病的,SQL执行语句优化器的设计的问题,让复杂的SQL运算无法在MySQL上运行。
基于MySQL的问题,直接在MySQL数据库引擎本身在进行动作是很难的,而PolarDB-MySQL,后续我们都简称为P-MYSQL,使用了一个路由+列式节点的方案+Shared storege的方式来解决这个问题。
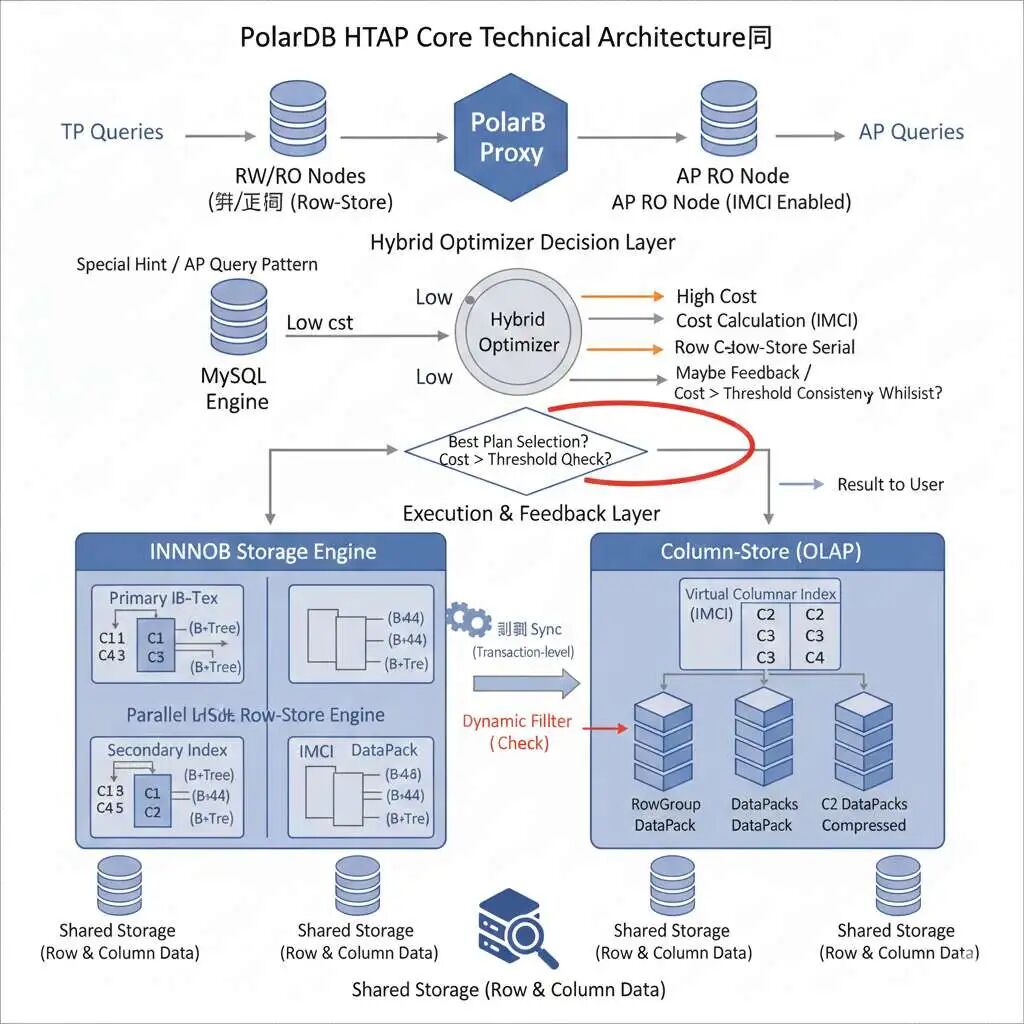
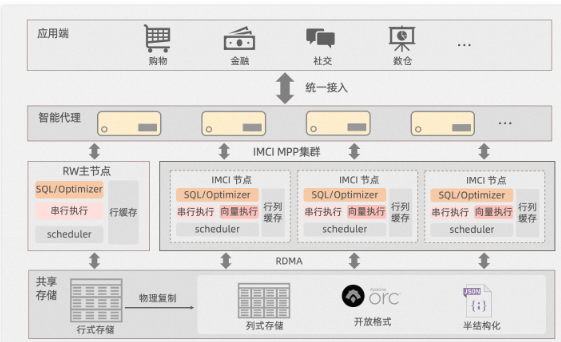 列式的架构图
这个方式有以下的一些特点
1 列式处理的表是经过客户进行挑选的,语句也是通过语句执行的成本来进行限制,只有达到COST的语句才可以流入到IMCI 列式的节点。
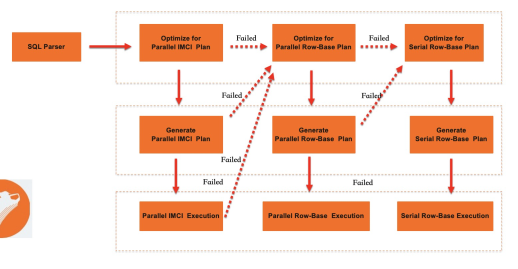 执行计划
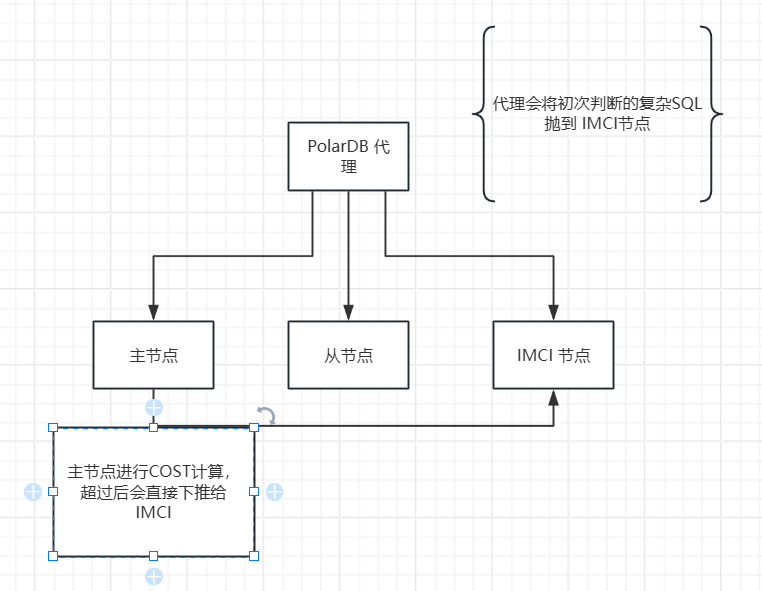 语句如何到了IMCI
首先,语句到IMCI 经历了几个过程,首先是POLARDB 数据库的代理,这里有几个部分会直接到IMCI
1 写的特殊的语法,直接将SQL语句强制到IMCI的节点的语法,代理直接就根据语句的要求,直接将语句发送给IMCI的节点
2 通过初步的判断语句的撰写的方式,复杂程度,比如大量的JOIN,大量的聚合等
在第一波代理将语句打入到IMCI后有的人会问,那么COST的阈值作为判断来进行语句的转发,这个还有作用吗?
这个当然有作用,POLARDB FOR MYSQL的语句执行方式分为 行存模式,行存并行执行计划,列存计划三个方式来进行语句的执行,性能优化器的会再次根据cost的计算IMCI > PQ > 行存串行 的方式来进行语句的从高COST到底COST的分门别类的语句执行。
除此之外,还有最后一种动态反馈的机制,如果列存与行存的数据有不一致的情况,那么访问会再次返回行存进行解决。
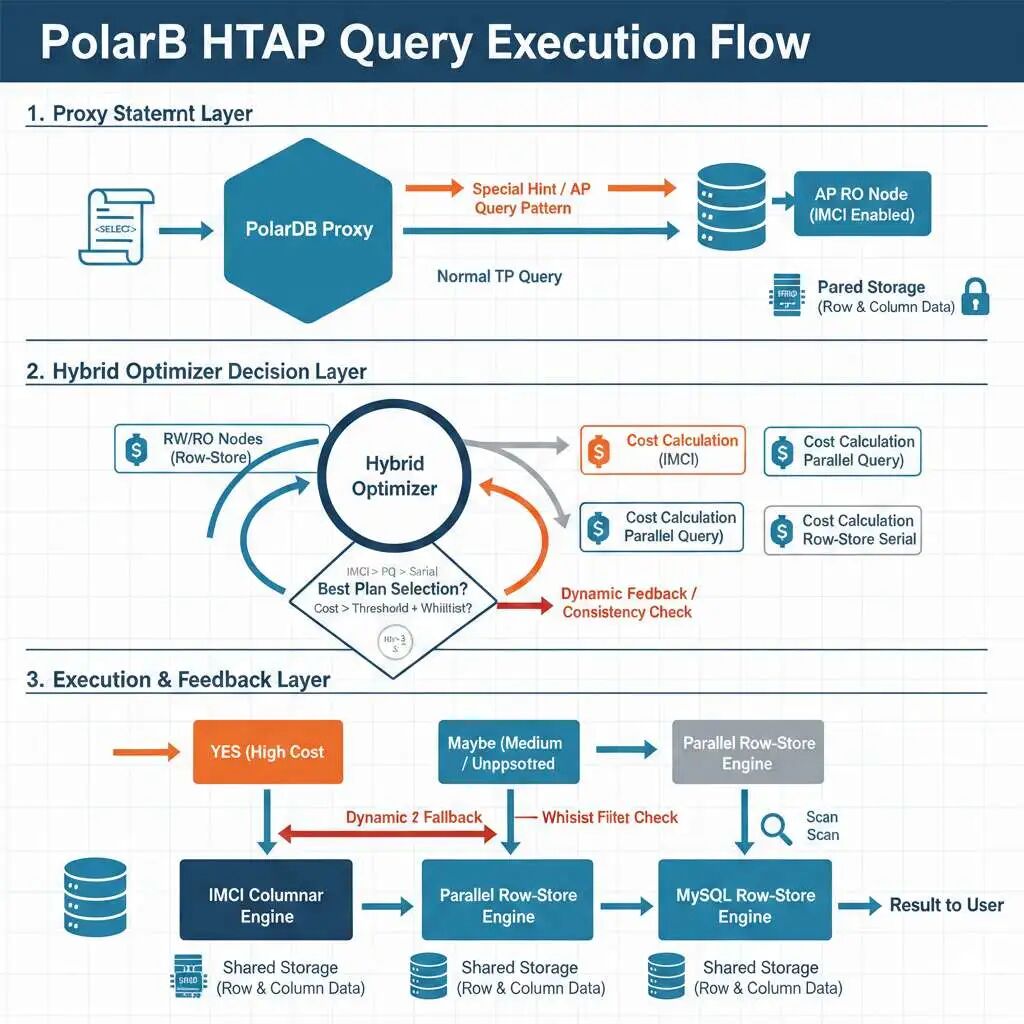
这里简述一下我理解的IMCI列式的数据处理和存储的原理
1 列存数据采用“无序追加” + 统计信息的方式,数据的组织单位是64K行为一组,每个组对不同的列进行打包,形成DATAPACK,数据的写入只有目前活跃的数据组接收数据,写满后,压缩并存储。
如果遇到数据的删除和更新的情况下,采用的是标记删除行,并追加新行的通用方式,那么在建立列存的时候,我们采用的是存量数据库和增量数据的方案。
1 存量数据库通过扫描主键,快速进行行转列的工作 2 增量数据分类普通事务 和 大事务,普通事务在修改操作写入列更新缓存,同步应用到列存 而大事务,会通过提前获得事务编号,对外不可见数据,但进行更新的方式来进行数据的列式数据的添加,降低了平衡延迟和性能之间的问题。
在数据查询是通过快照隔离,列存记录写入和删除,通过AP查询通过编号来获取全局一致性来解决。
 列存存储
这里有人好奇列式数据都打包了,怎么看和方便进行数据回述,元数据(Meta):每个 DataPack 都会自带一套粗糙索引(Rough Index),记录该包内数据的,最大值(Max)、最小值(Min),数值总和(Sum),空值个数(Null Count)记录总条数。
优化器在扫描时,会先检查 DataPack 的元数据。如果不符合查询条件(例如 WHERE age > 100,但 DataPack 的 Max 为 90),整个 DataPack 会被直接跳过(Skipping),不进行解压和读取。
整体的数据查询的过程可以简单总结为
1 RowGroup 过滤:优化器根据 dept = 'IT' 检查所有 RowGroup 的统计信息,剔除完全不含 'IT' 的组。
2 DataPack 定位:在保留的 RowGroup 中,仅读取 dept 列和 salary 列对应的 DataPack。
3 进一步过滤:利用 dept DataPack 的元数据再次跳过不相关的包。
4 解压与计算:将相关的 Compressed DataPack 读入内存解压,利用 SIMD 指令在内存中进行高速 Batch(批次)计算。
好了今天就先说到这里。
MongoDB “升级项目” 大型连续剧(3)-- 自动校对代码与注意事项
MongoDB “升级项目” 大型连续剧(2)-- 到底谁是"der"
MongoDB “升级项目” 大型连续剧(1)-- 可“生”可不升
MongoDB 大俗大雅,上来问分片真三俗 -- 4 分什么分
MongoDB 大俗大雅,高端知识讲“庸俗” --3 奇葩数据更新方法
MongoDB 学习建模与设计思路--统计数据更新案例
MongoDB 大俗大雅,高端的知识讲“通俗” -- 2 嵌套和引用
MongoDB 大俗大雅,高端的知识讲“低俗” -- 1 什么叫多模
MongoDB 合作考试报销活动 贴附属,MongoDB基础知识速通
MongoDB 年底活动,免费考试名额 7个公众号获得
MongoDB 使用网上妙招,直接DOWN机---清理表碎片导致的灾祸 (送书活动结束)
MongoDB 2023年度纽约 MongoDB 年度大会话题 -- MongoDB 数据模式与建模




