2013年,一家叫Docker的小公司发布了一个工具。十三年后的今天,Docker Hub上托管着超过1400万个应用镜像,每月交付超过110亿次镜像拉取,GitHub上有超过340万个公开仓库在根目录放了Dockerfile,Stack Overflow连续多年把Docker评为开发者”最想要”和”最常用”的工具。
但如果你问一个操作系统内核工程师,Docker到底是什么,他会给你一个非常尴尬的答案。
Docker不是一项新技术,它没有发明任何东西。
对,你没看错。Docker没有发明任何新技术。它做的所有事,用的都是几十年前就存在的老玩意儿。
chroot?Unix v7,1978年。
文件系统命名空间?Linux 2.5.2,2001年。
网络命名空间?Linux 2.6.24,2007年。
容器镜像的分层文件系统格式?本质上是tar包叠tar包。
在Mac和Windows上跑Linux容器?用了一个叫SLIRP的古老工具。这个工具最早在中世纪…不是,在1990年代中期,是给PalmPilot掌上电脑拨号上网用的。
跨CPU架构运行?用QEMU模拟器,配上Linux里的binfmt_misc这个偏门特性——又是一个你在任何一本”现代系统设计”教材里找不到的东西。
这就像一个篮球运动员告诉你,他成为MVP的秘诀跟刻苦训练无关,跟天赋异禀也无关,他靠的是每天吃二十年前生产的过期蛋白粉。你信吗?
但Docker确实赢了,它赢下了整个云计算的基础设施战争。今天,Kubernetes调度的是容器,AWS Fargate跑的是容器,你的CI/CD流水线里跑的是容器,甚至连国际空间站都在用容器部署软件。
那么,灵魂问题来了:
为什么一个技术上毫无原创、全靠拼凑老古董的工具,反而成了云计算时代的操作系统?
要回答这个问题,我们得先去坟场看看。
这里的”坟场”,指的是那些年所有被Docker干掉的、从技术角度看远比Docker更优秀更完美的方案。
首先是Plan 9。这个名字对普通程序员来说可能有点陌生,但在操作系统领域,它是传说级别的存在。贝尔实验室在同一年代创造了Unix和Plan 9,而Plan 9的设计哲学用一句话概括就是:Plan 9把”万物皆文件”从一句口号贯彻成了物理定律。
Plan 9从内核层面对命名空间进行了彻底的、从头设计。什么叫”从头设计”?Linux的命名空间是后来一块一块拼上去的:2001年加一个文件系统命名空间,2006年加一个进程间通信命名空间,2007年再加一个网络命名空间,像补丁摞补丁。而Plan 9呢?它在设计之初就把所有资源——文件、进程、网络、甚至硬件设备——全部统一为命名空间,干净得不能再干净,优雅得不能再优雅。
Linux用了十余年,七个补丁,拼出了一套命名空间。Plan 9在1992年就做完了,一个概念,全部搞定。
谁赢了?
Docker。Plan 9在教科书里。
然后是全虚拟化方案。虚拟机给你的是真正的隔离:独立的kernel,独立的userspace,独立的文件系统,什么都独立。从安全角度看,这比共享同一个内核的容器强了不止一个数量级。Docker容器本质上是多个进程共用同一个内核,任何一个容器的内核漏洞都可能导致宿主机被攻破。虚拟机绝不会出现这种问题。
从技术角度看,要跑多个应用,虚拟机显然才是正确方案。完美隔离,互不干扰。
谁赢了?Docker。VMware和KVM当然活得好好的,但开发者日常写代码、跑测试、部署微服务,没有人会先去装个虚拟机。
再然后是Nix和Guix。这两个是包管理器领域的”正确方案”。普通Linux发行版怎么装软件?apt install,rpm -ivh,一堆动态链接库扔到/usr/lib里,版本冲突了就抓瞎——这也是Docker要解决的核心问题之一。Nix的做法是什么呢?每个包安装在独立的、基于哈希的路径下,/nix/store/abc123-firefox-1.0/,不同版本天然隔离,依赖关系用符号链接精确管理。
这才是函数式、可复现、零冲突的包管理。干净,优雅,正确。
谁赢了?还是Docker。Nix是好东西,但全世界的软件包都要重新打包成Nix格式才能用。Docker的做法呢?你现有的任何程序,直接写几行Dockerfile就能跑。而Dockerfile本质上就是shell脚本,不需要重新打包任何东西。
现在我们能隐约看到规律了。
Plan 9输了,因为它要求全世界重写操作系统。 Nix输了,因为它要求全世界重写包管理。 虚拟机没输,但它在开发者工作流这个战场上输了,因为启动一个虚拟机要几十秒,而启动一个容器只要零点几秒。
Docker赢在了一个你很难在技术博客里看到的维度上——它不要求世界为它改变。
一个开发者想在服务器上跑一个Python网站。Docker要做的事情是什么?让这个开发者继续写Python,继续用pip install,继续保持他原有的开发习惯。唯一的变化,是把这些步骤写进一个Dockerfile。
FROM python:3COPY requirements.txt /app/requirements.txtWORKDIR /appRUN pip install -r requirements.txtCOPY . /appEXPOSE 80CMD ["python", "app.py"]
这就是一个shell脚本,加了几行声明式的语法糖。任何写过bash的人都看得懂。不需要学新的配置语言,不需要理解命名空间的底层原理,不需要知道overlayfs和btrfs有什么区别。
然后docker build,docker push,docker run。三句话。你的应用可以在任何装了Docker的机器上跑了。
这个体验好到什么程度?有一句话特别值得玩味:”Docker seems to be something developers enjoy using.” 开发者似乎喜欢用Docker。你什么时候听说过开发者”喜欢”用一个基础设施工具?大家喜欢vscode,喜欢TypeScript,喜欢Rust,但谁会说喜欢一个部署工具?
Docker做到了,因为它不教你做人。
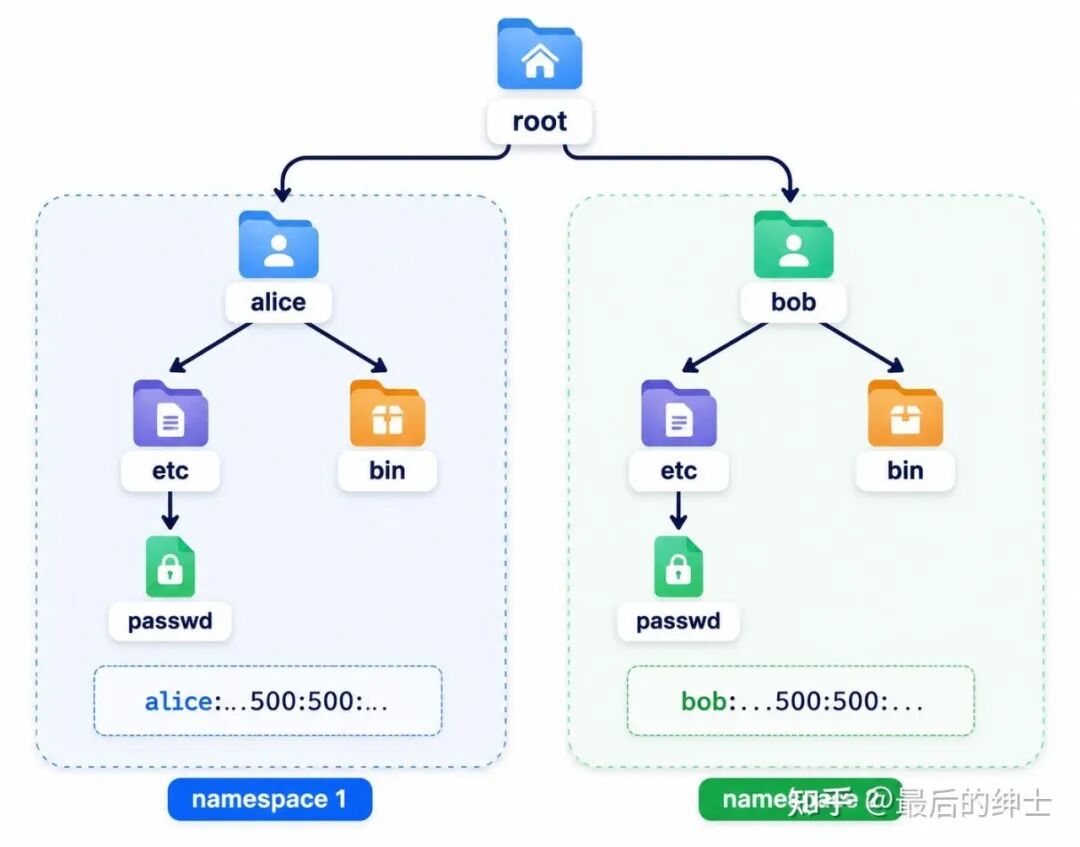
Linux挂载命名空间允许进程控制文件名的解析方式。用户看到的是统一的文件系统,Docker在底层完成了重映射。
最能体现Docker“务实到不要脸”精神的,是这个叫SLIRP的故事。
2015年,Docker团队面临一个问题:越来越多的开发者在使用Mac和Windows作为主力开发机,但Docker的容器镜像是基于Linux内核的,没法直接在macOS或Windows上跑。怎么办?
常规思路:让用户装个虚拟机软件,比如VMware Fusion,在虚拟机里跑Linux,然后在Linux里跑Docker。这个方案技术上完全可行。
Docker团队说:不行。这个体验太差了。用户必须先在本地看到localhost:8080,而不是什么192.168.x.x的中间IP。
他们的方案是什么?直接写了一个叫Docker for Mac的桌面应用。这个应用里面嵌了一个完整的Linux内核。对,你没看错,他们在macOS的用户态进程里塞了一个Linux内核进去。用的是硬件虚拟化扩展,把Hypervisor做成了一个库(HyperKit),嵌入到应用里。
技术上说,这是把一个操作系统当成第三方库链接进去了。就像你在C项目里链接libcurl一样,只不过他们链接的是整个Linux kernel。
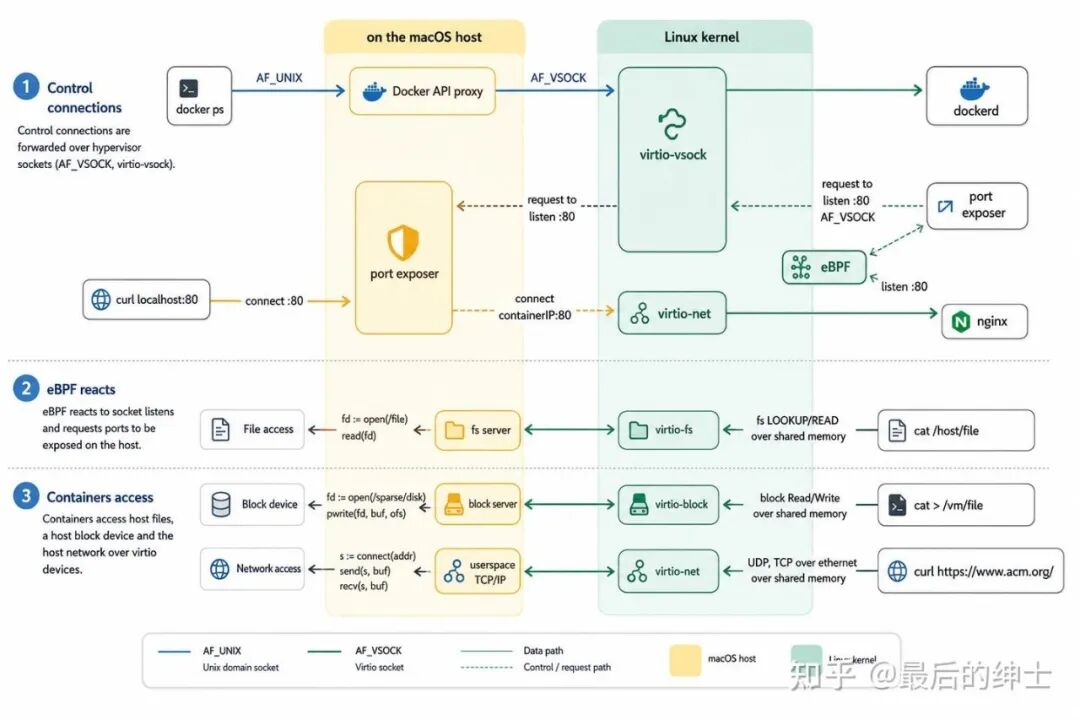
Docker for Mac 架构:桌面应用内嵌一个完整的 Linux 内核,再在 Linux 里跑 Docker 守护进程和容器。
然后,真正的魔幻操作来了。
这个嵌入的Linux内核和外面的macOS要用同一个网络栈。正常的做法是桥接(bridge):在Linux虚拟机和Mac之间架一个虚拟网桥,转发网络流量。
结果呢?企业防火墙和杀毒软件把这种流量误判为恶意攻击。Docker的beta用户蜂拥而至报了上千个bug。
正常人到这步会怎么办?跟企业IT部门解释这是合法的桥接流量,请求加白名单。对吧?
Docker团队不。他们翻出了一本上古秘笈。
SLIRP。这个工具最初是用来让PalmPilot掌上电脑通过拨号连接互联网的。1990年代中期的技术。它的工作原理是:在用户空间模拟一个TCP/IP栈,把所有网络请求转成普通的socket调用。
换句话说,当Docker容器发起一个TCP连接时,它绕开了直接桥接到Mac网络接口的做法,先转换成socket调用,再由Mac的应用层发出去。在外部的VPN策略和防火墙看来,这个流量就是从Docker桌面应用发出的,跟什么”陌生的虚拟机”毫无关系。
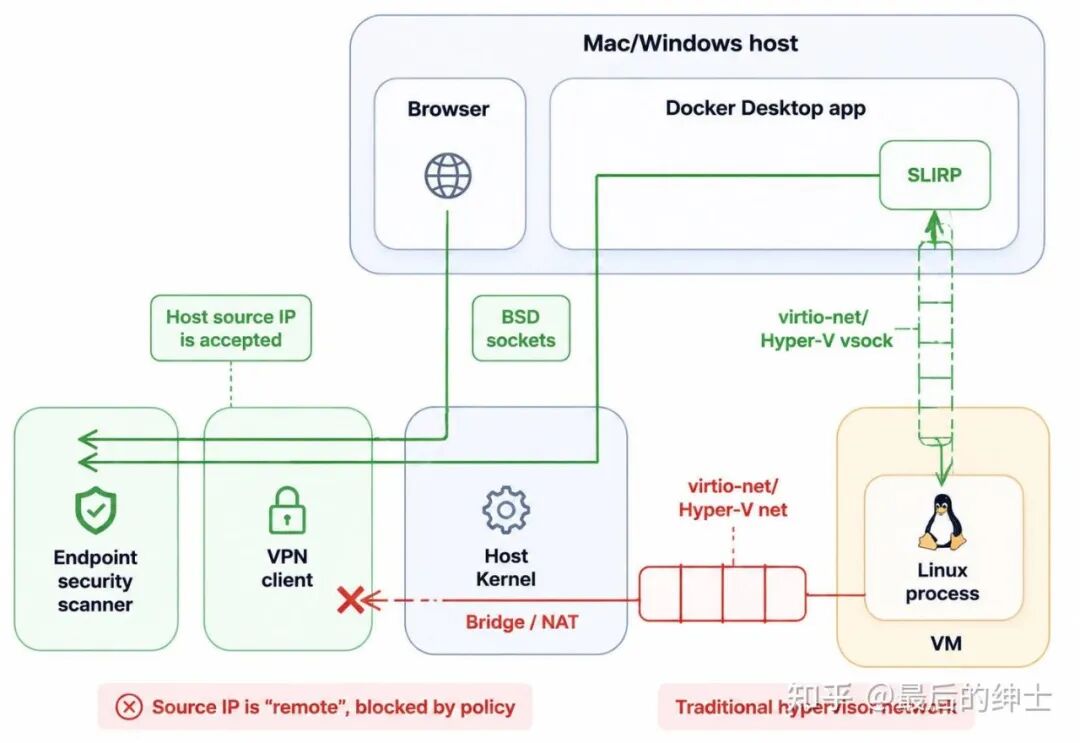
传统桥接流量被防火墙拦截(上),而通过SLIRP中转的流量被当作本地应用流量放行(下)。
神奇吗?部署这个来自拨号上网时代的老古董之后,来自企业用户的bug报告下降了超过99%。
你不觉得这个画面特别荒诞吗?2026年的云计算基础设施,核心网络方案是一个1995年的拨号上网工具。但这就是Docker赢的密码。
现在我可以提出一个概念了——务实的工程定律。
它的核心定律是:在真实世界中,技术的胜利不取决于一个方案有多”正确”,而取决于它对现有世界要求的改变有多小。
Plan 9要求全世界换操作系统。Nix要求全世界换包管理。完整的虚拟机方案要求开发者多等几十秒启动时间。
Docker什么都不要求。你写你的代码,它帮你打包。你用你的pip、npm、maven,它不干预。你跑在Intel还是ARM还是RISC-V上?它会用binfmt_misc偷偷帮你翻译指令集(又是一个偏门hack),你不需要关心。
Docker的整个技术栈,如果用正统系统设计的标准去衡量,简直就是一栋违章建筑。
地基是1978年的chroot。承重墙是2001年到2007年陆续打上去的Linux命名空间补丁。这些补丁当初各自独立添加,时间跨度长达六年,跟容器没有任何关系,被Docker强行缝合在一起。水电管网是1990年代的SLIRP拨号协议。楼层之间的楼梯是QEMU的CPU指令翻译。外墙粉刷是overlayfs的写时复制机制,这玩意儿最初是为了嵌入式设备的闪存寿命设计的。
但就是这栋违章建筑,住了全世界几千万开发者。而旁边那栋Plan 9设计的、从地基到屋顶每一块砖都严丝合缝的现代化大厦,空无一人。
讲到这里,我必须请出一个更有力的证据,来证明这不仅仅是Docker的个案。
2016年起,Docker做了一件非常违背”正统工程直觉”的事,把原本庞大的Docker守护进程逐步拆成独立组件:2016年底先剥离出containerd负责运行容器,2018年前后BuildKit接掌镜像构建,dockerd则留作调度协调。
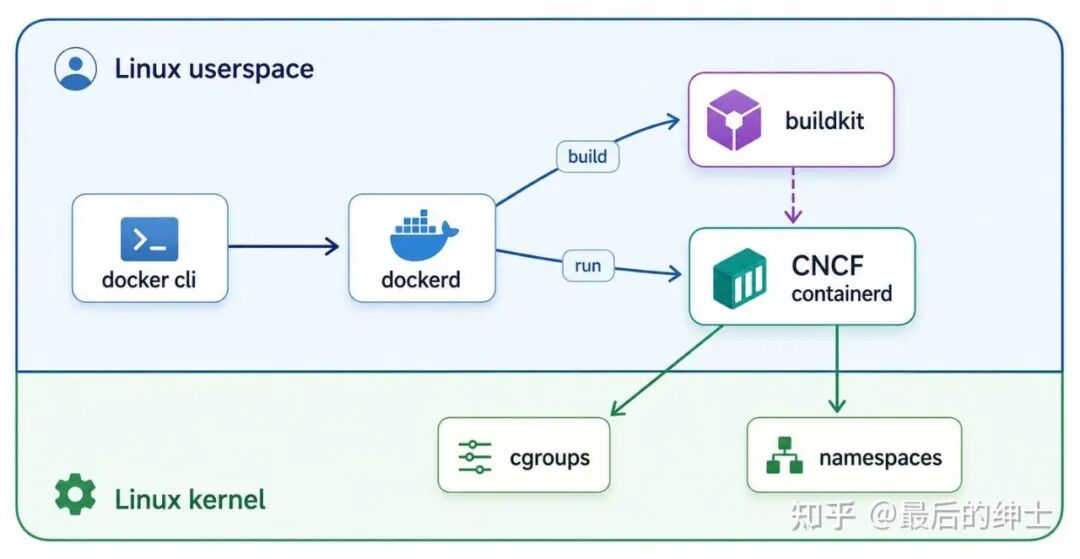
Docker 的组件架构:buildkit 构建镜像,containerd 运行容器,dockerd 调度协调。
为什么要拆?按照Docker团队的说法,这样做是为了让社区可以独立实现和替换每一个组件。
但问题是,有了这个开放架构,任何人都可以做一个”Docker替代品”出来。
有人做了吗?做了。Podman、Kaniko、nerdctl……全是Docker兼容的。没有一个能取代Docker。
为什么?因为Docker做对了一件事:它把粗糙的东西暴露给了用户,用户觉得它简单;它把复杂的东西藏在了标准里,竞争者觉得它难抄。
Dockerfile的格式简单到令人发指,本质上就是RUN、COPY、CMD几个指令。但Docker镜像的标准——OCI规范——继承了内核命名空间、分层文件系统、内容寻址存储、多架构清单等一大堆历史遗产。任何一个想替代Docker的工具,都得把这些全吃下去。而Docker花了十年和无数bug才把这些拼在一起的破烂勉强调通。
开源社区有个经典笑话:Docker的成功证明了,一个东西不需要做得特别好,只需要比所有人先达到”足够好”。
但我觉得这个笑话没说到点子上。
真正的道理是:把”足够好”当技术指标看,就完全看错了。它是一个社会指标。它衡量的是:在不逼迫用户改变行为习惯的前提下,你能解决的问题有多大。
很多人可能会说,Docker这套粗糙实用主义早晚会翻车。GPU时代来了,AI工作负载动不动就是异构计算,容器技术跟不上怎么办?
官方也承认:确实跟不上。GPU驱动和用户态库必须精确匹配,而容器共享宿主机内核。两个应用需要不同版本的CUDA怎么办?Docker想出的办法叫CDI(容器设备接口)——在容器启动时动态注入GPU设备文件和动态库,然后重新生成ld.so缓存。
翻译一下就是:又一个补丁。
Docker没有试图设计一个”一次编写,到处运行”的GPU抽象层。因为这本质上是CUDA和Metal之间的指令翻译问题,比Intel到ARM的翻译难一个数量级。它也没有试图重新发明Nix式的可复现GPU环境。它只是说,你指给我看GPU在哪,我把驱动文件塞进去,剩下的你自己搞定。
粗糙吗?粗糙。好用吗?至少现在能用。
我们生活在一个崇拜”创新”的时代。融资PPT上必须写”颠覆性技术”,论文摘要里必须提”novel approach”,技术博客必须用”革命性突破”。
但回顾Docker这十三年的历史,你会看到一个完全相反的真相:
它的每一次胜利,原因都是同一个:选对了”不需要发明新东西”的那条路。
chroot是1978年的。命名空间是2001年到2007年陆续添加的。SLIRP是1990年代的。QEMU和binfmt_misc也是十几年前的东西。Dockerfile就是shell脚本。全部是旧技术,全新组合。
Docker只是工程学本质的一个诚实样本。
理论物理学家可以花三十年推导一个完美的方程。工程师不行。工程师面对的是一个已经运行了几十年的世界——几十亿行代码躺在生产环境里,几百万开发者有自己的肌肉记忆,几百个企业IT部门有自己的防火墙规则。你不可能让所有人停下来等你建一座新大楼。
所以真正高明的工程,从来不去追问真空中”应该怎么运行”,只追问废墟中”还能怎么拼”。
这就是务实的工程定律。
进步,不代表一定能赢。不够先进的方案,往往才是最优解。
至于为什么——因为这个世界,本来就是一堆老古董拼成的。Docker只是第一个承认这件事的软件。
来源丨网址:https://zhuanlan.zhihu.com/p/2048091978382960295?share_code=1boWACTbkk2JD&utm_psn=2065821830313670071
dbaplus社群欢迎广大技术人员投稿,投稿邮箱:editor@dbaplus.cn


