研究简介
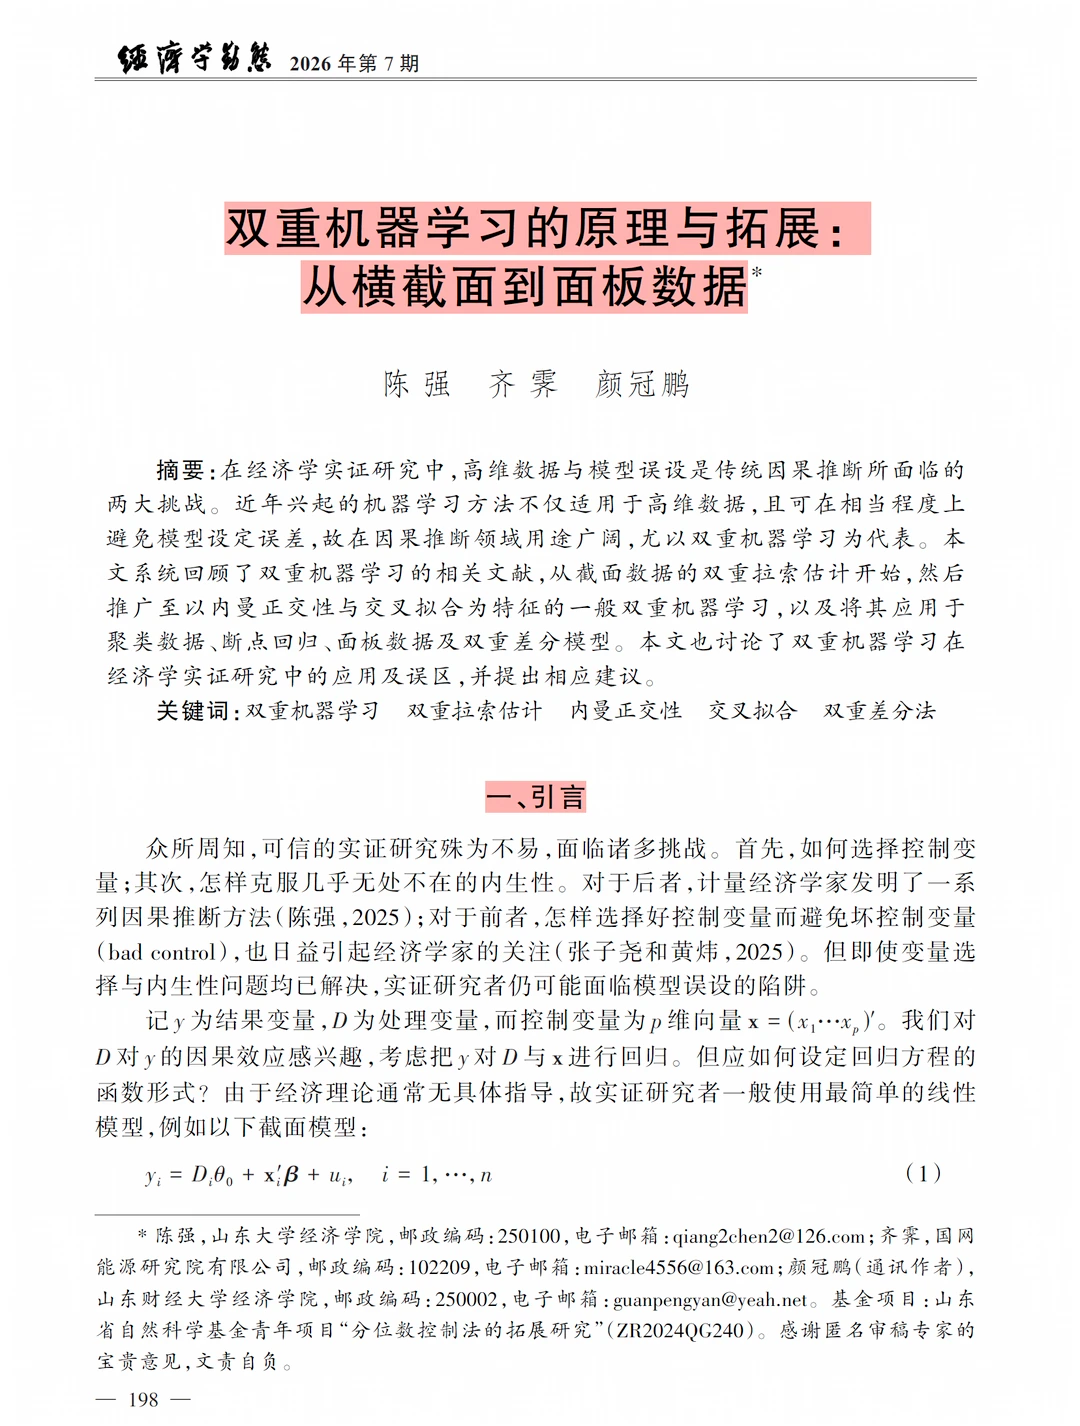
传统因果推断方法大量依赖线性回归模型,因此容易面临模型设定误差。经典非参数回归虽然能够在一定程度上避免模型误设,但当协变量维度较高时,又容易陷入“维度灾难”。近年来,机器学习凭借对高维数据的良好适应性以及对复杂函数关系的灵活刻画能力,为因果推断提供了新的思路,但与此同时也可能产生正则化偏差和过拟合偏差。如何利用机器学习处理复杂数据,同时保证因果效应估计的可靠性,成为新的研究挑战。
Chernozhukov et al.(2018)提出的双重机器学习(Double/Debiased Machine Learning,DML),正是针对这一问题形成的重要方法框架。通过Neyman正交性与交叉拟合,DML能够在一定程度上降低第一阶段机器学习估计误差对最终因果参数的影响。目前,DML在横截面数据中的应用已经相对成熟,并进一步向聚类数据、断点回归、面板数据和双重差分模型拓展。不过,随着DML应用范围不断扩大,一些方法理解和实证操作上的误区也逐渐出现。
需要特别强调的是,DML并不是一种新的因果识别策略,更不能被视为解决内生性问题的“万能钥匙”。它可以与工具变量、断点回归、双重差分等经典识别策略结合,但无法替代这些识别策略。研究者仍需首先解决因果关系如何被识别,再利用DML处理高维协变量和复杂函数关系。也正因如此,该研究不仅梳理了DML从横截面走向面板数据的拓展,更专门总结了实践中容易出现的六类认识误区,其中一些问题对于当前大量使用面板数据和DID开展实证研究的研究者尤其值得注意。
第一,误将DML视为因果识别策略。 DML主要解决的是高维数据处理和模型设定问题,本身并不能解决内生性,更不能替代IV、DID、RDD等识别策略。
第二,将DML的“去偏”理解为小样本无偏。 Neyman正交性能够使估计结果对第一阶段误差具有一定的“一阶不敏感性”,但并不意味着DML在有限样本下不存在偏差。
第三,误将DML视为控制变量自动选择器。 不同机器学习算法的机制并不相同,机器学习能够处理高维回归,并不等于一定会自动筛选控制变量。
第四,误将部分线性模型DML理解为工具变量法。 部分线性DML的核心是第一阶段机器学习估计与第二阶段残差回归,不能简单等同于传统IV估计。
第五,将截面DML直接照搬到面板数据。 面板数据需要进一步处理个体固定效应、时间固定效应及组内相关性,简单套用截面DML可能导致估计偏差。
第六,为了使用DML而在DID中加入内生时变协变量。 DML无法解决协变量自身的内生性问题,不能为了使用机器学习而盲目增加控制变量,否则反而可能破坏原有的因果识别。
归根结底,DML可以拓展因果效应的估计工具,但不能替代因果识别本身。尤其是在面板数据和DID研究中,研究者更需要首先判断识别假设是否成立,再考虑DML是否真正有必要。
拓展阅读
如果希望进一步了解DML的理论基础与具体应用,还可以关注另一篇相关研究——《双重机器学习的理论与应用——从“黑箱”到“工具箱”的实践指南》。与陈强教授等重点梳理DML“从横截面走向面板”的理论拓展不同,这篇研究更加侧重于DML在实际实证研究中的方法体系与应用规范。
研究从部分线性模型(PLM)、交互回归模型(IRM)出发,介绍了Neyman正交性、交叉拟合等DML核心机制,并进一步讨论DML如何与工具变量、双重差分、断点回归等经典识别策略结合。同时,研究通过数值模拟和精准扶贫政策案例,展示不同DML模型的适用条件,并提醒研究者关注样本重叠、模型选择和识别假设等问题。
两篇研究虽然侧重点有所不同,但共同指向了DML应用中最重要的一条原则——先识别,后估计。
DML真正的意义,并不是让机器学习取代传统计量方法,而是将机器学习的高维预测能力与现代因果推断框架结合起来,把原本用于预测的“黑箱”逐渐转化为服务于因果推断的“工具箱”。
参考文献:
陈强, 齐霁, 颜冠鹏. 双重机器学习的原理与拓展:从横截面到面板数据[J]. 经济学动态, 2026,(7):198-224.
胡诗云, 江弘毅, 解海天. 双重机器学习的理论与应用——从“黑箱”到“工具箱”的实践指南[J]. 数量经济技术经济研究, 2026,(3).
本文来源:社科学术汇,版权属于原作者,仅用于学术分享。



