单卡、低算力,实验室GPU不够用...还能做深度学习吗?当然能!其实深度学习里有不少路线,本身就在研究怎么少训练、少参数、少数据、少算力。
我最近把这类方向重新梳理了一遍,比较值得关注的有下面5个,各位资源受限的朋友可以参考参考。
PS:下文中提到的论文合集、深度学习数据集等资料,可帮你解决选什么方向、拿什么数据、怎么改baseline这几个最现实的问题。如有需要可扫码加小享让TA及时、无偿发你!
1,Training-Free
这是我觉得低算力最友好的路线之一。核心思路很简单:能不能不训练,直接从输入、特征或模型内部的信息入手?
比如CVPR 2026的一些工作已经开始探索training-free的Token Pruning、特征处理等路线,不需要重新训练整个模型,实验门槛会低很多。
2,PEFT/小样本学习
如果完全不训练不符合你的研究需求,那就考虑不训练全部参数,只训练很少一部分。
Adapter、LoRA、Prompt Tuning以及各种轻量化适配方法,本质上都是在解决这个问题。而且现在PEFT本身也还在持续发展,不是说LoRA做完就没东西了。
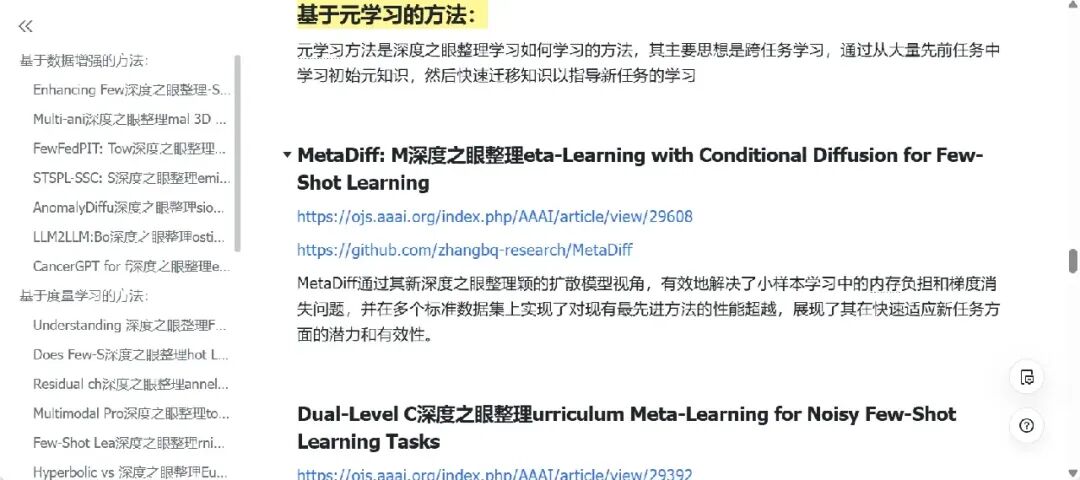
这块我自己也整理了27篇小样本学习相关论文,按数据增强、度量学习、元学习、添加其他辅助任务做了分类。如果你准备走这条路线,可以直接拿来做选题参考。
3,Token压缩/剪枝/Token Merge
这个方向和第一类有点像,但它不是造一个更大的模型,而是考虑:模型里这么多Token,有没有一部分其实根本没必要算?
所以可以从Token选择、Token剪枝、Token合并、动态计算等角度继续做。
这类方法最大的优势就是:很多时候不需要改掉整个模型结构。如果你本身就喜欢改一个模块、做一个轻量创新,这条路线就非常合适。
4,数据高效/小样本训练
还有一个经常被忽略的思路:算力不够,就反过来研究能不能用更少的数据,达到接近全量数据的效果?
这也是Data-efficient AI近年来一直在关注的问题,研究范围已经覆盖小样本、数据选择、数据凝练、自监督学习等多个方向。这条路线尤其适合数据和算力都有限的人。
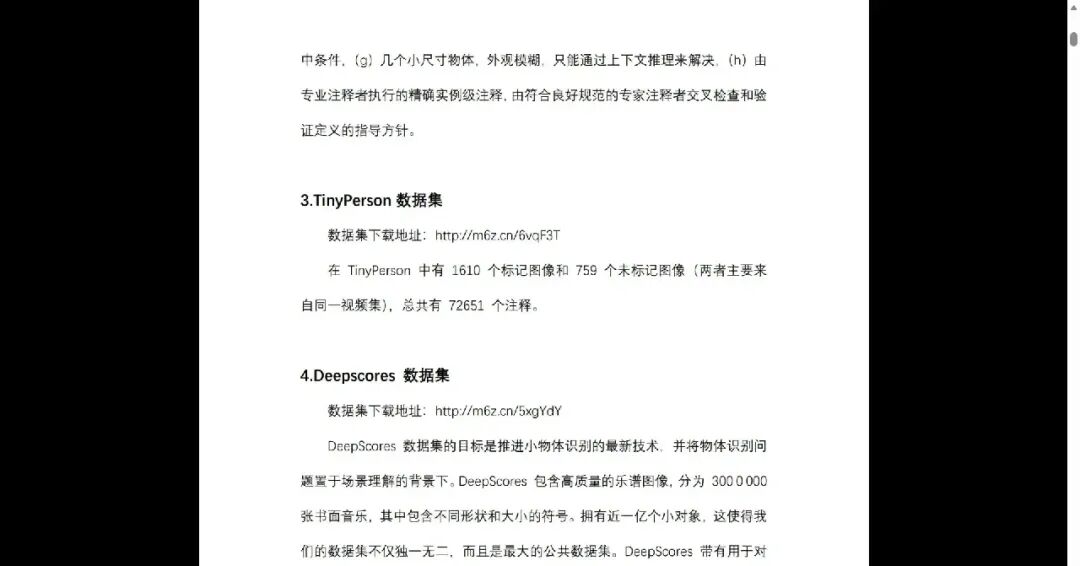
我这边正好整理了90多个深度学习数据集,如果你准备做小样本、数据高效训练或者找一个容易落地的实验场景,可以直接从里面挑。
5,轻量级网络/高效架构
最后就是比较传统,但一直没过时的一条:不去堆模型规模,而是想办法让模型本身更高效。比如降低Attention复杂度、轻量化卷积、全局/局部特征解耦、稀疏计算、动态网络……
这类方向的好处是:问题明确、实验指标好量化,而且很容易和具体任务结合。比如你可以围绕:精度→参数量→FLOPs→显存→推理速度去构建完整实验。



