随着 GPT-6 Sol 和 Luna 的正式发布,除了真的好用也真的贵的 Astra,广大科研人终于又有了更加具有性价比的新选。
那么相较GPT-5.6,GPT-6 在科研领域的提升到底如何呢?
这次,我们给 GPT-6 和 GPT-5.6 全系的六款模型,准备了一份 120 分科研综合卷:包含数据重建、论文写作、图表和PPT等全套科研场景。
除了看输出效果,这次我们还着重关注各个模型的tokens花费。
| 01 理论成绩
首先,让我们看看 OpenAI 官方公布的各个模型的 AutomationBench 通过率/单任务成本。为了更加直观的展示,我们把 GPT-5.6 和 GPT-6 全系的成绩都放在了一起。
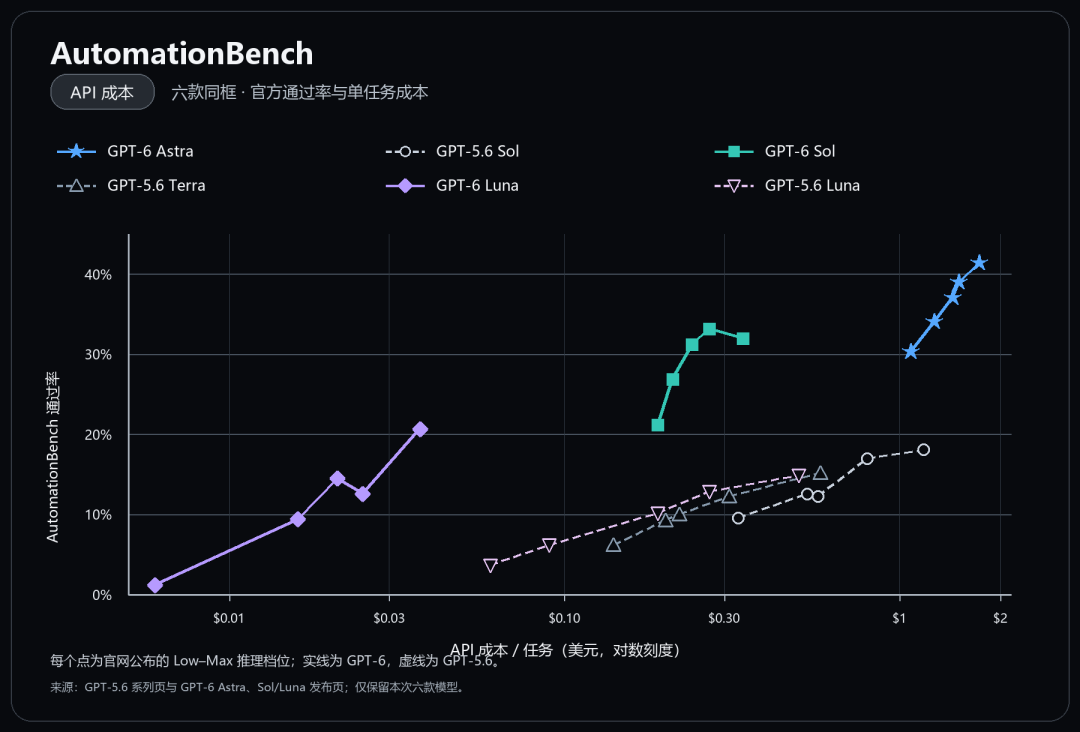
通过表格我们可以看到,总体上 GPT-6 全系的表现,都要遥遥领先于GPT-5。Astra low 以每项 1.08 美元达到30.3%,超过 GPT‑5.6 Sol 最贵档的 18.1%;GPT‑6 Sol low 花 0.19 美元达到 21.2%,也高于 GPT‑5.6 Terra max 的 15.2%。
两组对位中,新款用更低的单项成本就越过了旧款最高档的通过率。
Luna 的变化要到中档才看得出来。low 档仍是 GPT‑5.6 Luna 领先,3.7% 对 1.2%;到了 medium、high 和 max,GPT‑6 Luna 才以更低成本取得更高通过率。但结合价格来看,GPT‑6 Luna 的成本就要比 GPT‑5.6 Luna 低得多了。
| 02 测试说明
这次,我们准备的试卷共七题、120分:先做实验数据与SVG作图,再处理蛋白结构、微藻和金融风险材料,最后读论文并做一页组会PPT。六款模型统一 medium 档和工具条件,禁止联网。
01 实验数据还原(25分)
根据四组各392条买家—轮次记录,重建购买、评论计数并判唯一;算购买后评论比例及平台经济组相对控制组倍数;估买家数、讨论重复观测;比较评论与福利,说明p值边界;把118次评论分成两种28人分布。
评分:8计数/唯一性、5比例、2买家/重复观测、4变化、2 p值、4分布。
参考文献:
02 SVG图(15分)
交完整SVG,A画购买率和全轮次评论率,B画购买后评论比例,C画社会福利。标单位、分母、范围;C从零起,不造误差条;标p=0.164,并说明A、B口径差异
评分:按SVG有效性、口径与标注、p值说明及60字内口径解释核对。
参考文献:同上
03 结构证据(15分)
依据CASP14的87个结构域,算AlphaFold相对下一名在两项RMSD95上的绝对、相对降幅;写90–140字导语,并为论文所述两种薄弱条件设计分组。
评分:9两项降幅、4导语、2分组设计。
参考文献:
04 文章摘要(15分)
用青岛、香港92对塑料—海水18S样本写150–210字摘要,纳入群落差异、较高α多样性及373个潜在有害/产毒ASV(14个仅见塑料);分类三条证据说法并设计验证。
评分:
8摘要、4证据分类、3后续验证。
参考文献:
05 撰写备忘录(20分)
围绕银行同步受损写350–550字备忘录,串联D1机制综述、D2价格传染模拟、D3重要性/脆弱性测度;提出传染与共同冲击解释、比较设计、结果变量、区分检验及识别困难
评分:7串联证据、5竞争解释、8研究设计与识别。
参考文献(之一):
06 证据判断(10分)
把五条关于买家数、显著性、AlphaFold、产毒和系统风险的断言判为“支持/否定/不足”,各用不超过两句话说明。
评分:五条各2分,判断与依据均符合材料。
参考文献:以上全部
07 汇报PPT(20分)
读指定论文,说明中国平台进入对东道国既有平台的影响;提交恰好一页、
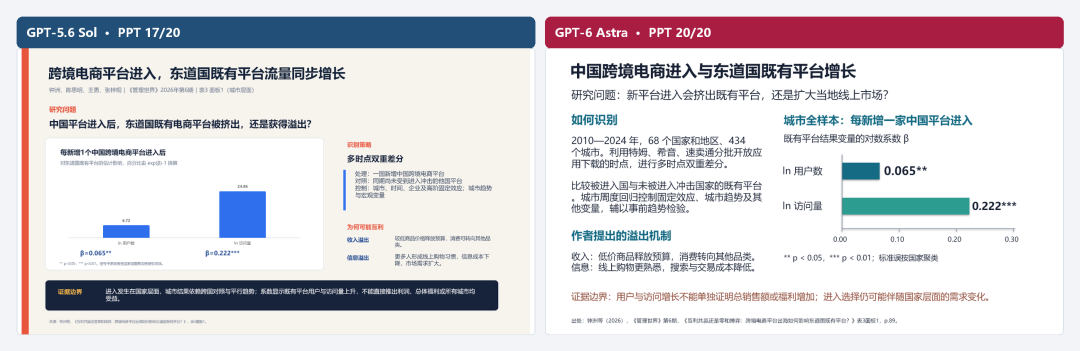
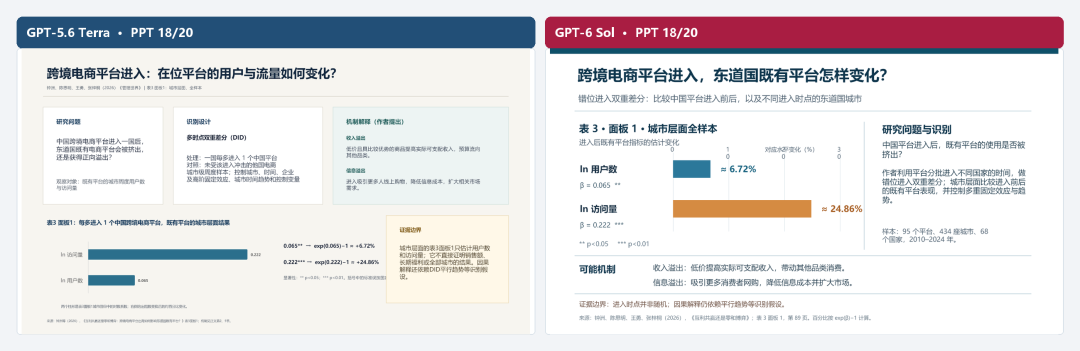
16:9可编辑PPTX供约3分钟讲解。呈现问题、识别、结果、证据边界及双重溢出机制;重绘表3面板1城市ln用户数、ln访问量系数与显著性,百分比用exp(β)−1。
评分:核对论文问题、识别、结果、边界、双重机制和表3两项数据。未提交可打开的PPTX时最高3分。
参考文献:
| 03 结果评价
1~6 题
六款模型的总分,落在 109–120 分之间,差距集中在少数边界要求:次数分配、SVG 源码、字数和单页 PPT 的可读性。
由于这次评测的模型并非同一挡位,为了保证公平,我们对答案的评价,将按照 OpenAI 的产品定位,来两两进行:GPT-6 Astra 对比 GPT-5.6 Sol,GPT-6 Sol 对GPT-5.6 Terra,两个 Luna 级则放在一起对比。
最后,本次评测仅供参考,纯属主观体验,非标准方法,无第三方核验,一切以大家实际体验为准。
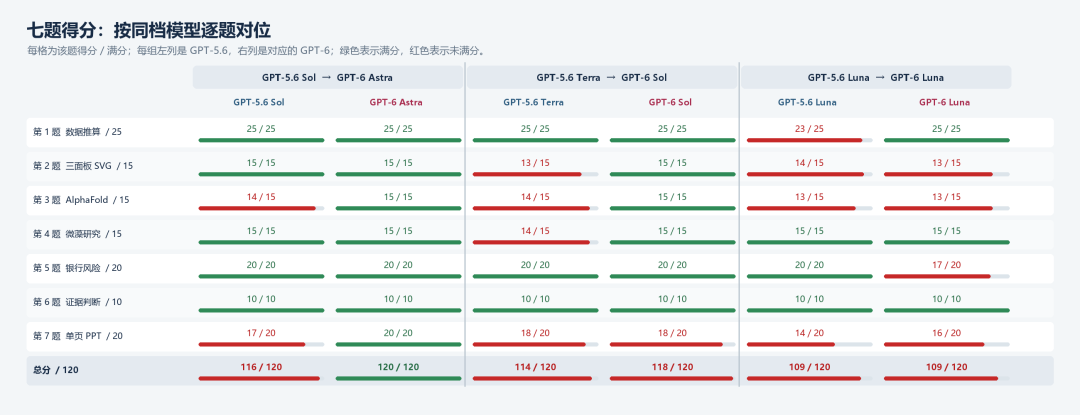
1 第一题五款满分,只有 GPT-5.6 Luna 的答案少 2 分。
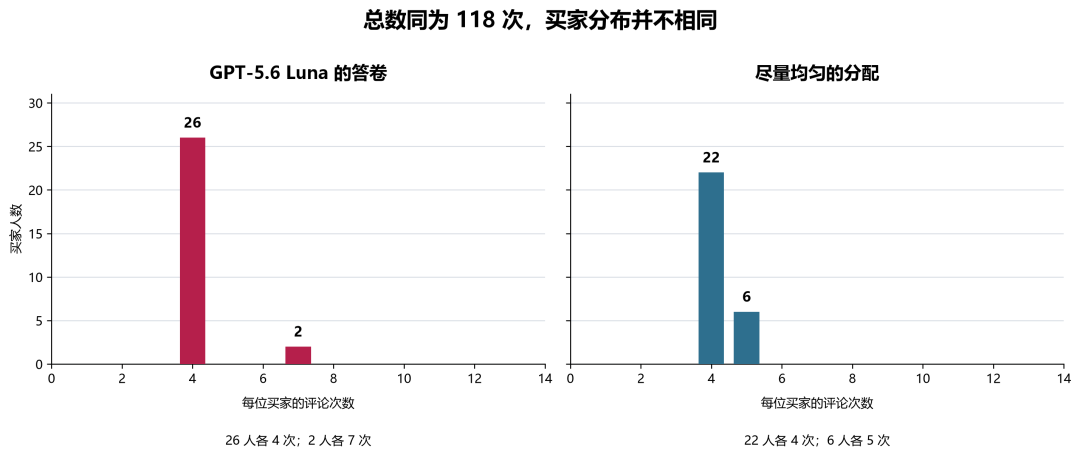
图里两种分配都达到 118 次评论;但GPT-5.6 Luna 将次数集中在少数买家,这跟我们在题目中要求“一套尽量分散,一套高度集中”相违背,因此扣分,反观GPT-6 Luna 和其他模型,均按题意分得更均匀。
2 第二题的分差落在作图口径和交付文件上。
GPT-5.6 Sol 与 GPT-6 Astra 都得满分:两张图区分了“全部轮次评论率”和“购买后的评论比例”,并将 p=0.164 标为不显著。
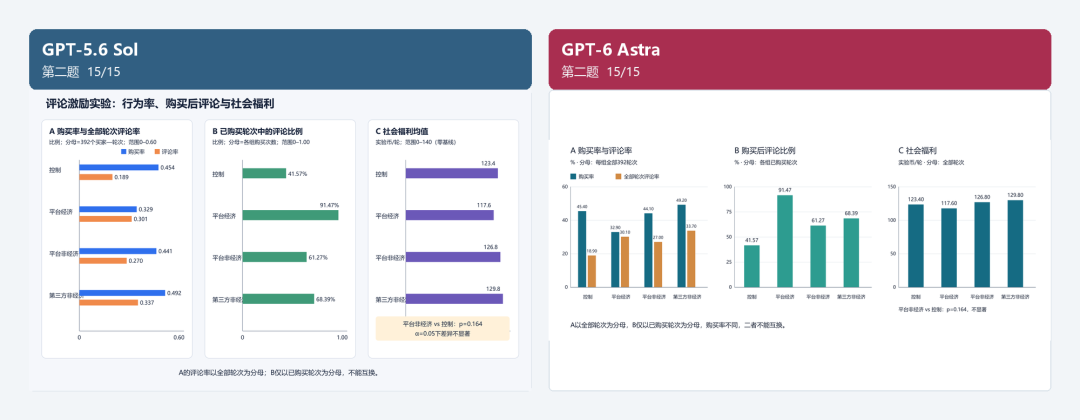
GPT-5.6 Sol 与 GPT-6 Astra 第二题三面板图对照
GPT-5.6 Terra 得 13 分,GPT-6 Sol 得 15 分。
GPT-5.6 Terra 的图可以解析,但答卷没有附完整 SVG 代码,后续我们可能无法直接修改和复用这张图。因此扣两分 ; GPT-6 Sol 的答案则没有问题。
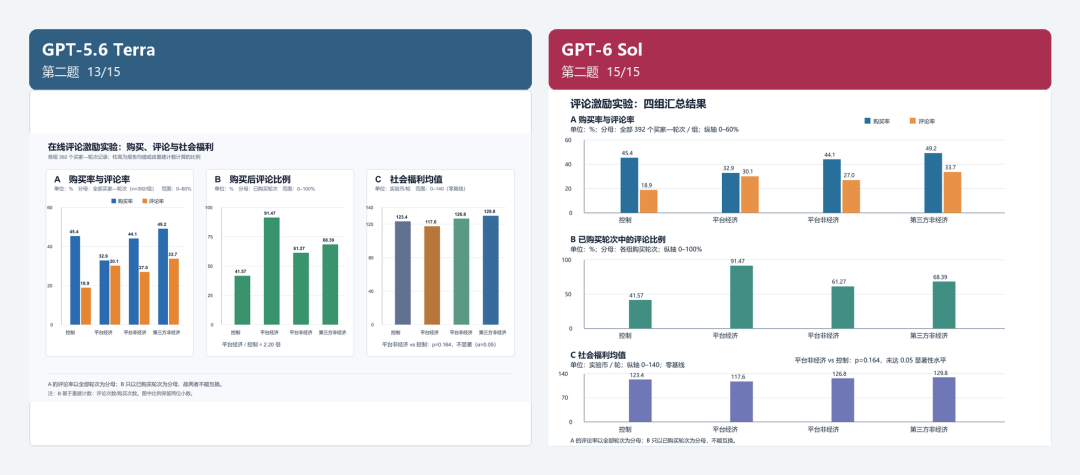
GPT-5.6 Terra 与 GPT-6 Sol 第二题三面板图对照
GPT-5.6 Luna 得 14 和 GPT-6 Luna 均没有拿到满分,前者 B 面板用了三位小数,后者没有附完整 SVG 代码;图像之外,精度和源文件也决定科研图件能否接着使用。
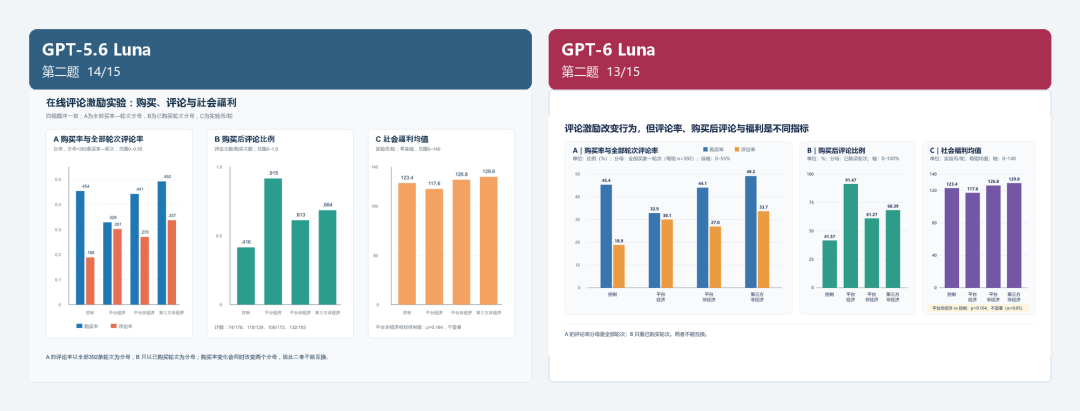
GPT-5.6 Luna 与 GPT-6 Luna 第二题三面板图对照
3 第三题的分差主要来自 140 字限制:GPT-5.6 Sol、Terra 和两款 Luna 都超字数,因此存在不同程度的扣分,GPT-6 Astra 与 GPT-6 Sol 的导语在范围内,所以均为满分。这里展示一下 GPT-6 Sol 的 15 分导语:
“在 CASP14 的 87 个蛋白质结构域盲测中,AlphaFold 的主链 Cα RMSD95 中位数为 0.96 Å,全原子指标为 1.50 Å,均明显低于下一名。模型还给出逐残基可信度估计,但同源序列稀少、结构主要受链间相互作用决定的对象仍较难预测,实验结构测定仍有作用。”
4 第四题除 GPT-5.6 Terra 少 1 分外,其余五款都得 15 分。这里展示一下 GPT-6 Astra 给出的后续方案,它成功把“潜在产毒”转成了可检测的实验问题:
“从塑料分离一个对应候选 ASV 的微藻培养物,以相同培养基但不接种微藻作空白对照,在相同条件下重复培养;额外以带标准品的化学分析测定细胞及上清中的特定毒素,检验‘该分离株在此条件下实际产生并释放该毒素’。”
5 第五题五款得 20 分,GPT-6 Luna 因超过 550 汉字上限得 17 分。
这里展示一下 GPT-6 Sol 的满分备忘录,它成功把银行持仓、抛售时序和滞后损失放进同一个检验:
“可取上市银行季度资产负债表、逐券持仓及债券价格和成交数据,以外生冲击前的持仓重合度及受冲击债券市场深度为主要解释变量,比较净值损失、后续抛售量,并分别估计系统重要性和脆弱性。检验先受损银行抛售后的价格变化是否预测其他银行的滞后损失,同时控制共同宏观敞口;若只有同步损失而无价格传递链,更符合共同冲击。”
6 第六题六款几个模型均为满分。GPT-6 Luna 的五条判定简短而完整:
1. 材料支持:392/14=28,且假定完整覆盖每名买家的 14 轮。
2. 材料不足:两个 p 值分别对照各自的控制组,没有检验两激励组之间的差异。
3. 材料否定:全原子相对降幅为 57.14%,小于主链的 65.71%。
4. 材料不足:373 个 ASV 是参考库标注的潜在有害或产毒序列,缺少毒素测定与释放证据。
5. 材料支持:大型商业银行可以重要性高、脆弱性低,两者是不同维度。
PPT制作
比起上面这些常规任务,把一整篇文章整合成PPT的任务,更能展示出不同模型在信息搜集,整理,审美等方面的综合水平,这部分我们单独赏析。
GPT-5.6 Sol 与 GPT-6 Astra 实际交付的单页 PPT 对照
GPT-5.6 Sol 得 17/20,GPT-6 Astra 得 20/20。
三分差距落在汇报能否被现场读者看清。Astra 的页面把研究问题、识别设计、结果和证据范围安排成清楚的阅读顺序;Sol 的注释字号最低只有 8.2 pt,数据对了,投影时却难读。
GPT-5.6 Terra 与 GPT-6 Sol 实际交付的单页 PPT 对照
Terra 和 GPT-6 Sol 都得 18/20。
Terra 把问题、机制和设计分区展开,GPT-6 Sol 将两项结果的百分比换算放大呈现;但两页仍留有较密的说明文字,因此无法给出满分。
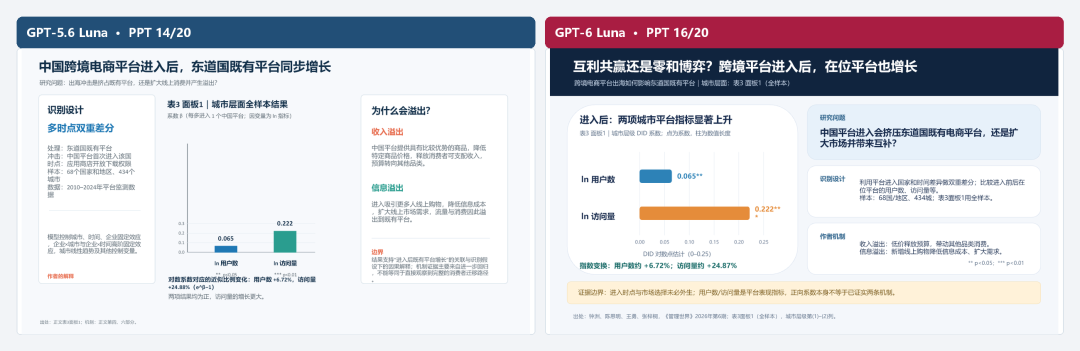
GPT-5.6 Luna 与 GPT-6 Luna 实际交付的单页 PPT 对照
GPT-5.6 Luna 得 14/20,GPT-6 Luna 得 16/20。
两页都把访问量效应算高了,正确值为 24.86%;GPT-5.6 Luna 另漏了完整出处。两分差别落在计算复核与引文收尾,单页设计再完整也要经得起这两项检查。
| 05 分数、时间和成本
1 成绩与时间
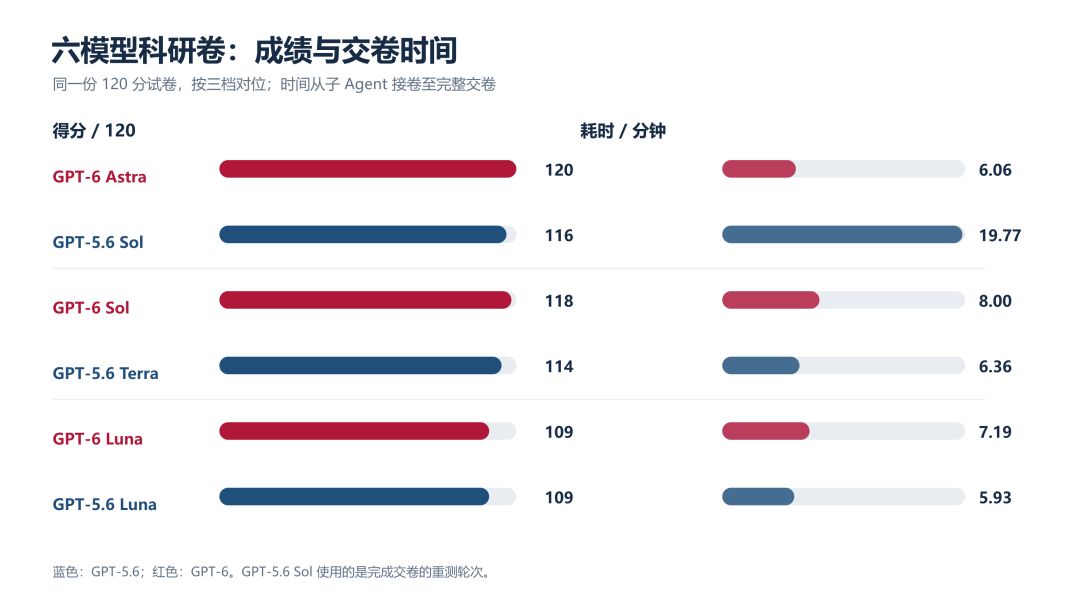
六款模型在同一份 120 分试卷上的成绩与完整交卷用时
Astra 以 120 分完成全卷,用时 6.06 分钟;GPT-5.6 Sol 重测得 116 分,用时 19.77 分钟。两款 Luna 同为 109 分,5.6 Luna 用时 5.93 分钟,GPT-6 Luna 用时 7.19 分钟。
值得注意的是,GPT-5.6 Sol的输出时间明显偏长,这是因为在测试时候,他花费了更多时间在内容核验上,重新测试后依然出现了类似的情况,大家使用时候也要注意一下,以免因为AI在后台的反复核验,而浪费宝贵的 Tokens。
2 分数与账单
接下来,我们把测试的中各模型消耗的Tokens,结合OpenAI官方API文档中的价格进行换算,得出本次任务的预估成本。
模型 | 得分 |
用时/总 token | 估算成本(美元) |
GPT-6 Astra | 120/120 | 6.06 分/145.08 万 | 2.784 |
GPT-5.6 Sol | 116/120 | 19.77 分/327.19 万 | 2.244 |
GPT-6 Sol | 118/120 | 8.00 分/211.77 万 | 0.740 |
GPT-5.6 Terra | 114/120 | 6.36 分/190.16 万 | 0.704 |
GPT-6 Luna | 109/120 | 7.19 分/165.63 万 |
0.035 |
GPT-5.6 Luna | 109/120 | 5.93 分/178.91 万 | 0.066 |
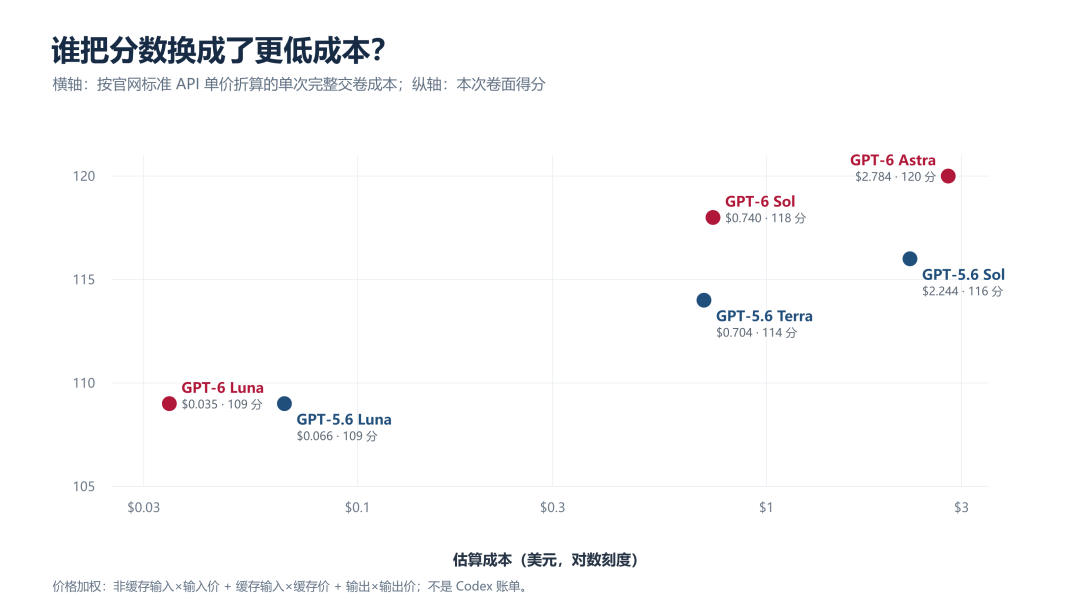
六款模型的卷面成绩与 API 等价成本
把成绩和账单合起来看,这次测试中 GPT‑6 三款的对位升级都有实际回报:Astra拿到全卷最高分,也比 GPT‑5.6 Sol 更快交卷;GPT‑6 Sol在账单几乎不变的情况下多拿分;GPT‑6 Luna则在分数持平时,把估算成本降到约一半。
所以,这次测试里,我们可以得出结论,Astra的优势是把成绩上限推高,GPT‑6 Luna的优势是用更低成本拿到同样的分数;GPT‑6 Sol则是在近似开销下取得更高成绩。



