机器学习到底是怎么“学会”的?用一条直线看懂训练全过程
很多人第一次接触机器学习时,会觉得它像一个黑箱:
但如果把复杂模型拆开来看,你会发现机器学习最核心的思想其实并不神秘:
先做一次预测 → 计算预测得有多错 → 根据错误调整参数 → 再预测一次。
不断重复这个过程,模型就会逐渐找到一组更合适的参数。
这篇文章不从复杂的神经网络开始,而是用最经典的 线性回归 + 梯度下降,带你看懂机器学习“学习”的全过程。
一、机器学习到底在学什么?
假设我们收集了一组数据:
我们希望找到一个规律:
最简单的方法,就是尝试用一条直线描述它:
其中:
所以机器学习在这个问题里真正“学习”的,并不是一条神秘规则,而是两个数字:
只要找到了合适的 和 ,模型就能根据新的 计算预测结果。
二、模型怎么知道自己预测得准不准?
有了模型,还需要一个“评分标准”。
比如真实值是:
模型预测:
那么预测误差就是:
但一个数据点不能代表整个模型,所以通常会计算所有样本的平均误差。
在线性回归中,最常见的是 均方误差 MSE:
其中 也叫 损失函数 Loss Function。
它的作用非常重要:
损失越大,说明预测越不准确;损失越小,说明模型越接近数据规律。
三、训练的本质:不断让损失下降
现在问题变成了:
这就要用到机器学习中最经典的优化算法之一:
梯度下降 Gradient Descent
可以把损失函数想象成一座山。
当前位置代表当前参数,山的高度代表损失。
我们希望从山上走到最低点。
最直接的方法就是:
数学上:
其中:
学习率决定每次更新走多大一步。
太小:
太大:
四、看动画:模型是怎样一点点贴近数据的?
下面这张 GIF 就是配套代码真实运行得到的结果:
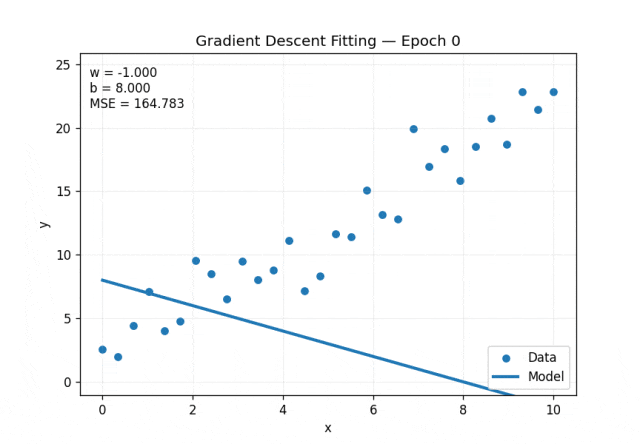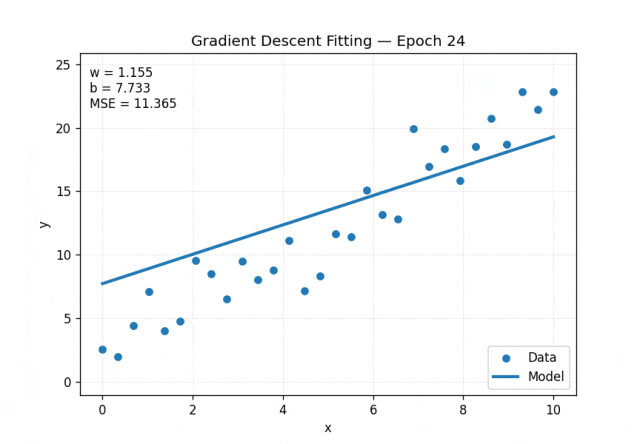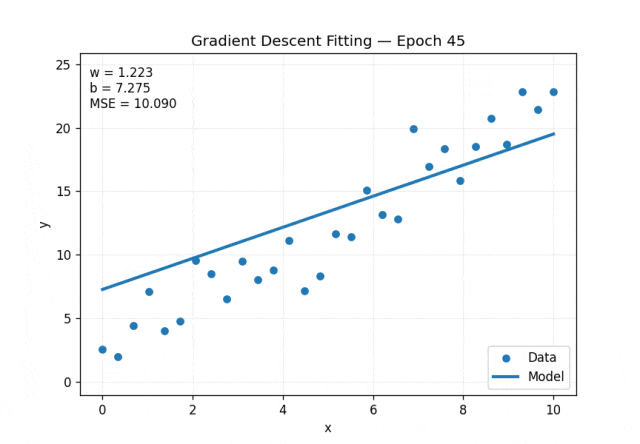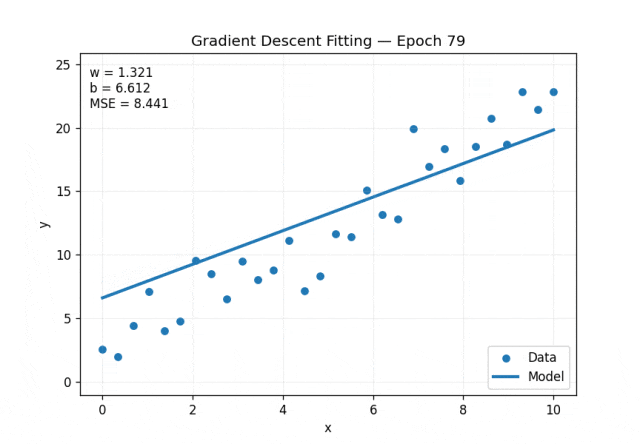
蓝色散点代表训练数据,直线代表当前模型:
一开始, 和 是随便初始化的,所以直线和数据明显不匹配。
随后每进行一次训练,模型都会:
于是直线就会逐渐贴近数据。
这就是“训练”。
五、为什么损失会越来越小?
训练过程中,我们还可以把每一轮的损失记录下来。
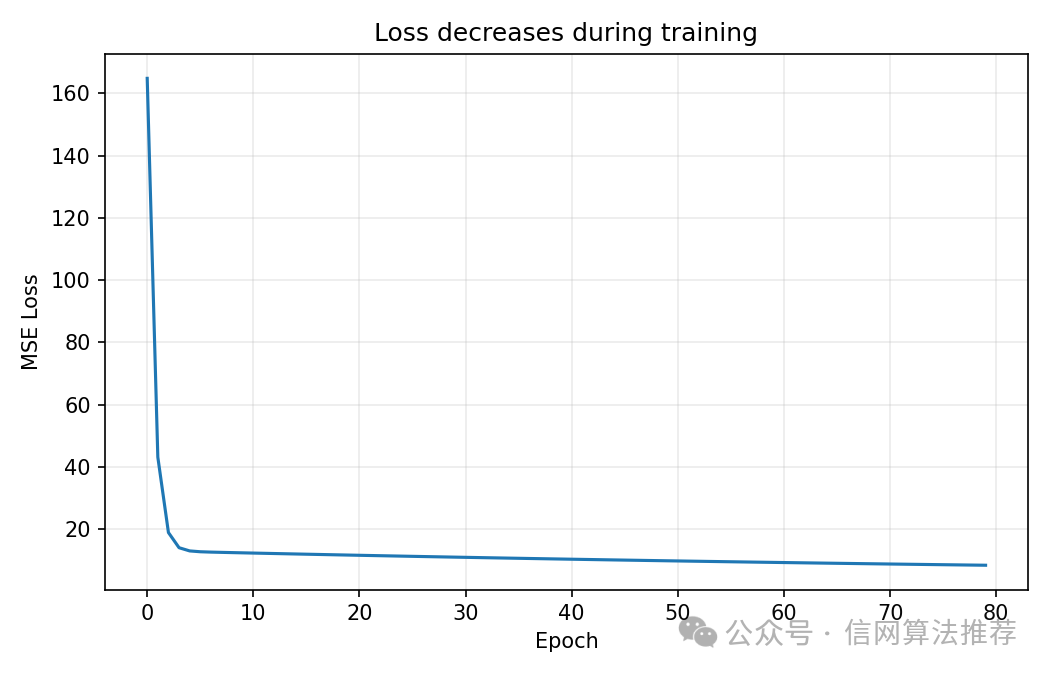
通常情况下,你会看到损失快速下降,然后逐渐趋于稳定。
这意味着:
当损失不再明显下降时,我们通常可以认为模型已经基本收敛。
最终得到的拟合结果如下:
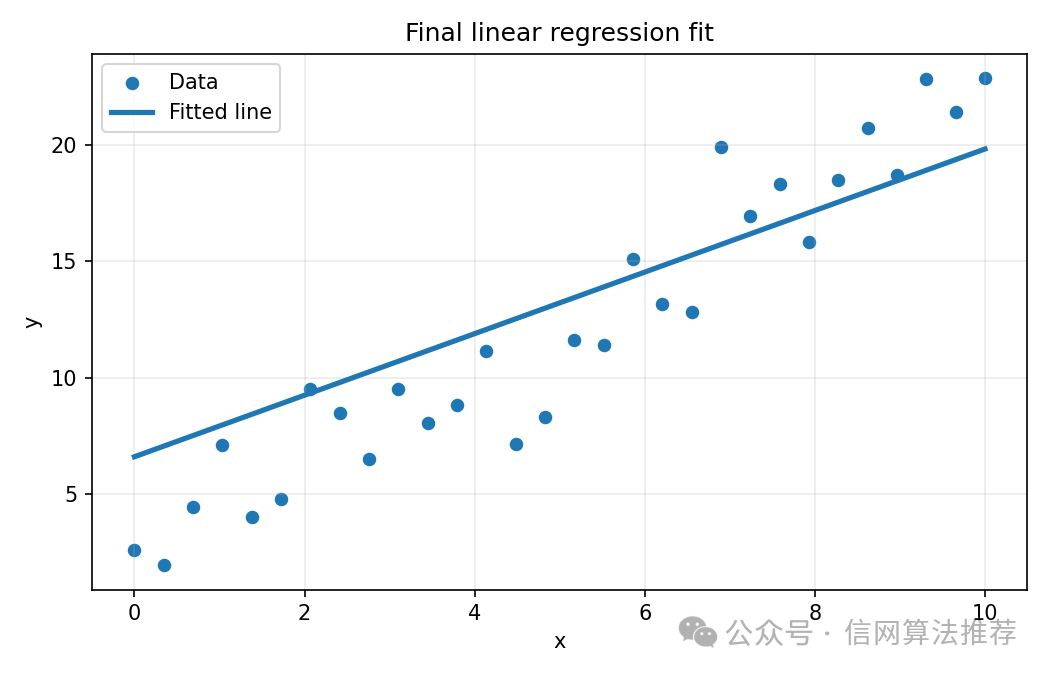
注意:
机器学习通常不是找到一个“绝对正确”的公式,而是找到一个对现有数据来说 足够好的近似关系。
六、把这个过程抽象一下,就是机器学习的基本工作流
几乎所有监督学习模型,都可以抽象成下面这个流程:
第 1 步:准备数据
得到:
其中 是输入, 是标签。
第 2 步:建立模型
例如:
复杂一些的神经网络,本质上也只是一个更加复杂的函数。
第 3 步:计算预测
把输入交给模型:
第 4 步:计算损失
比较:
得到:
第 5 步:更新参数
根据损失对参数的影响方向,修改参数。
第 6 步:重复训练
不断循环:
直到模型达到满意效果。
七、那分类问题又是怎么回事?
如果任务不是预测一个连续数字,而是判断:
这就是分类问题。
虽然输出形式不同,但核心思想没有变化:
模型仍然是在学习参数,使预测结果和真实标签之间的误差尽可能小。
线性回归学习的是一条拟合直线;
逻辑回归、SVM 等分类模型学习的是 决策边界;
神经网络则通过大量参数学习更复杂的非线性边界。
所以不同机器学习算法虽然形式不同,但核心循环非常接近:
八、为什么训练集、验证集、测试集不能混在一起?
机器学习还有一个非常重要的概念:
训练集
用于:
验证集
用于:
例如选择:
测试集
用于:
如果模型在训练集上表现非常好,但在测试集上很差,就可能出现:
过拟合 Overfitting
也就是说:
九、从线性回归到神经网络,其实只是函数变复杂了
线性回归:
神经网络可以写成多层函数组合:
虽然模型复杂程度天差地别,但训练思想仍然是:
所以理解线性回归和梯度下降之后,再去学习神经网络,会轻松很多。
配套练习
下面几道题建议先自己想,再运行文末 Notebook 验证。
练习 1:线性模型参数
已知:
当:
模型预测值是多少?
练习 2:计算均方误差
真实值:
预测值:
计算:
练习 3:学习率
分别尝试:
learning_rate = 0.001
learning_rate = 0.01
learning_rate = 0.1
观察:
练习 4:增加噪声
把数据中的噪声从:
noise = 2
改成:
noise = 8
观察拟合直线和损失曲线发生什么变化。
思考:
练习 5:训练集和测试集
把数据按 80% / 20% 划分为训练集和测试集。
只使用训练集更新参数,然后分别计算:
思考:
最后总结
如果只记住这篇文章的一个结论,可以记住下面这句话:
机器学习的本质,是利用数据定义误差,再通过优化算法不断调整模型参数,让误差逐渐减小。
在线性回归中,我们学习的是 和 。
在神经网络中,我们学习的是成千上万个甚至数十亿个参数。
模型虽然越来越复杂,但核心逻辑一直没有变:
理解这条主线之后,再学习逻辑回归、SVM、决策树、神经网络、Transformer,就会发现它们没有想象中那么神秘。
来源:信网算法推荐
本文仅用于学术分享,如有侵权,请联系后台作删文处理



