从笔记本到生产:一套可移植、可扩展、可组合的云原生 AI 流水线
2026-10-07 · 阅读约 6 分钟 · 面向架构师与平台工程师
Kubernetes 早已成为云原生的操作系统,但它从来不是为机器学习而生的:GPU 调度、分布式训练、超参搜索、模型版本、推理弹性,这些碎片散落在十几个工具里。Kubeflow 要做的,是把它们收拢成一条"从笔记本到生产"的流水线。作为 CNCF 项目,它如今已积累 258M+ PyPI 下载、33.1K+ GitHub Stars、3K+ 贡献者,社区发行版 26.03 更已验证支持 Kubernetes 1.34+。本文基于官方文档,给出从架构认知到部署实战、再到分布式训练与 GenAI 落地的完整路径。
258M+ PyPI 下载量 | 33.1K+ GitHub Stars | 3K+ 社区贡献者 | 1.34+ 已验证 K8s 版本 |
一、为什么 Kubernetes 是 AI 的理想底座
Kubeflow 的核心判断是:机器学习平台需要的所有基础设施能力,Kubernetes 都已经具备。可重复的可移植部署、微服务化的组件管理、按需伸缩的资源编排——这些云原生领域打磨多年的能力,恰好也是 AI 流水线最缺的那一环。Kubeflow 要做的不是另起炉灶,而是把 Kubernetes 的这些能力"翻译"给机器学习。
它起源于 Google 内部运行 TensorFlow 的方式,2017 年底对外开源,随后演化成一个支持多框架、多云环境的端到端机器学习平台。今天的官方定位非常清晰:"Kubeflow is the Cloud Native AI platform"——它不是一个大而全的单体系统,而是一组模块化、可独立安装的子项目集合,共同构成 Kubernetes 原生的数据与 AI 工作负载栈。
1.1 四条设计原则
Kubeflow 社区与所有子项目共同恪守四条核心原则,这四条原则也解释了它为何能在云原生 AI 领域迅速成为事实标准:
1.2 使命:桥接数据、AI 与云原生三个生态
官方将 Kubeflow 的使命表述为:"bridge the Data, AI, and Cloud Native ecosystems"——让团队沿着 AI 生命周期的"明路"(well-lit paths),把更多的模型、Agent 与 AI 应用稳定地交付到生产环境。换句话说,Kubeflow 瞄准的不是单点工具,而是"Kubernetes 上数据与 AI 工作负载的标准"。
一句话理解:Kubernetes 管的是"怎么把容器跑起来",Kubeflow 管的是"怎么把机器学习从数据一路跑到生产"——它把 数据准备、模型开发、调优、训练、编排、管理、服务 七个阶段,全部收编到同一套 K8s 原生 API 之下。
二、核心组件:一张图看懂 AI 生命周期
Kubeflow 的价值不在某一个组件,而在于用一组共享 Kubernetes 底座的子项目,完整覆盖了 AI 生命周期的每一段。官方把 AI 生命周期拆成五个阶段:数据准备、模型开发、模型训练、模型优化、模型服务——它是一个迭代闭环,每个阶段的产出都会回流以持续改进模型。
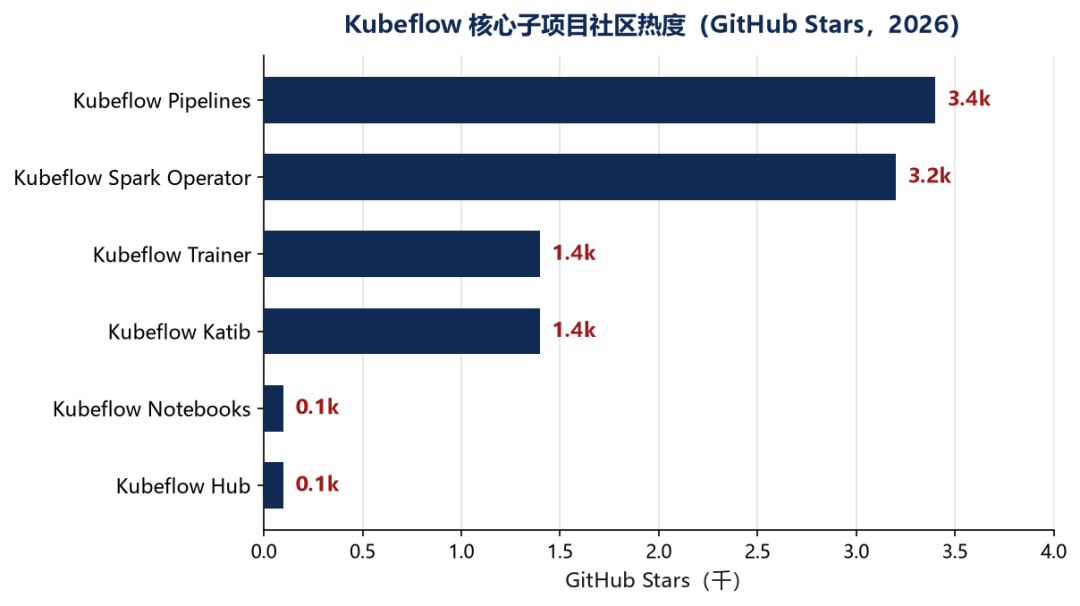
图1 · Kubeflow 核心子项目社区热度(数据来源:kubeflow.org 概览页)
2.1 Kubeflow SDK:把"学 Kubernetes"从算法团队身上摘掉
组件化的代价是接口碎片化。为此 Kubeflow 提供了
Kubeflow SDK——一组统一的 Pythonic API,让你"在任意规模上运行任意 AI 负载,而无需学习 Kubernetes"。它给各子项目提供了一致的使用入口,开发者只需专注业务逻辑,而不必操心底层编排。下一节的训练示例,核心就是 SDK 里的 train() API。
三、部署指南:四种形态,按场景选型
Kubeflow 官方把安装入口集中在 Installing Kubeflow 一处,并强调"很多组件既可整体安装,也可独立安装"。落到工程实践中,部署形态大致分为四类:本地验证、社区 Manifest、生产级发行版、云上部署。它们的生产就绪度差异很大,选错形态往往就是"能装起来"与"敢上生产"的分水岭。
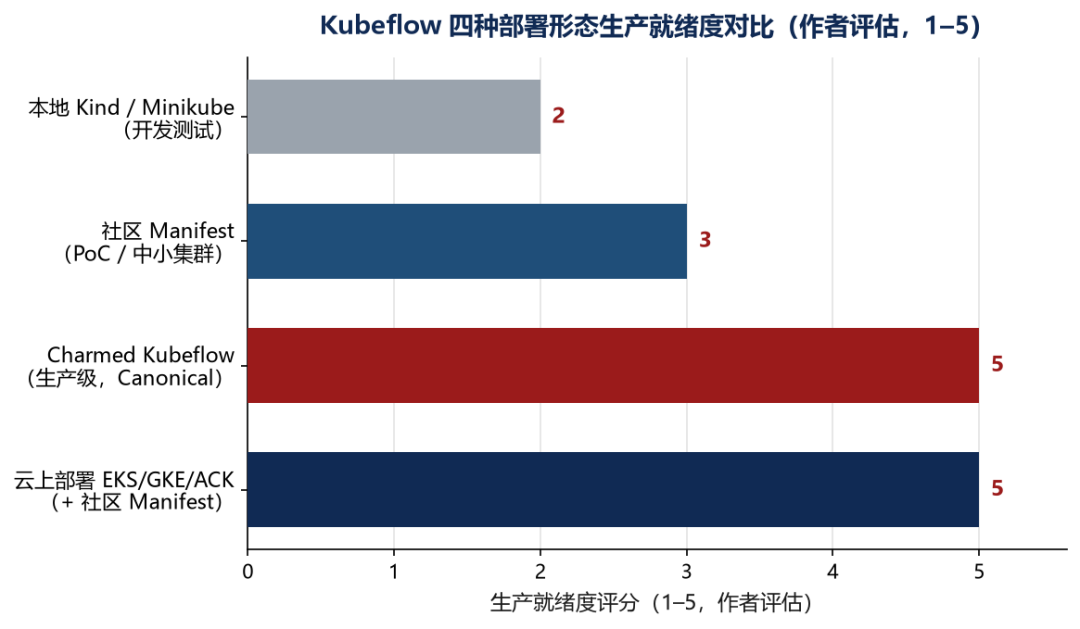
图2 · 四种部署形态生产就绪度对比(评分系作者工程实践评估,仅供参考)
3.1 前置条件
3.2 本地快速验证(Kind / Minikube)
如果只是想在笔记本上先把整条链路跑通,用 Kind 起一个单节点集群是最快的方式。注意社区 26.03 的 CI 已覆盖 Kind 0.31+ / Kubernetes 1.35 组合:
# 1) 创建本地集群 kind create cluster --name kubeflow-lab # 2) 校验 kubectl 上下文 kubectl config current-context kubectl get nodes # 3) 准备命名空间与存储 kubectl get storageclass
3.3 社区 Manifest 安装(推荐入门路径)
Kubeflow 官方维护 kubeflow/manifests 仓库,以 Kustomize 组织全部组件。26.03 版本显著简化了安装——它会自动安装匹配版本的 Kustomize 与 kubectl,并对下载内容做完整性校验:
# 克隆指定发行版 git clone https://github.com/kubeflow/manifests.git cd manifests git checkout v26.03 # 一键安装全部组件(含认证/网关/多租户) while ! kustomize build example | kubectl apply -f -; do echo "Retrying to apply resources..." sleep 10 done # 观察 Pod 就绪情况 kubectl get pods -n kubeflow -w
安装完成后,通过端口转发访问 Central Dashboard,默认账号密码见仓库 README(首次登录务必修改):
kubectl port-forward svc/istio-ingressgateway -n istio-system 8080:80 # 浏览器打开 http://localhost:8080
3.4 生产部署:安全与版本兼容是硬约束
社区发行版 26.03 的主题就是可扩展性与安全性。它默认加固多租户、并实现了 Kubeflow Pipelines v1 与 v2 对 Pod Security Standards(PSS)Restricted 策略的兼容——这对共享 AI 基础设施的组织尤为关键,意味着开箱即可向更严格的安全基线对齐。同时该版本还升级了 Knative 1.20、cert-manager 1.19.4、oauth2-proxy v7.14.3、Dex 2.45.0,并修复了 cert-manager、knative-serving、istio-system、dex 等组件的网络策略。
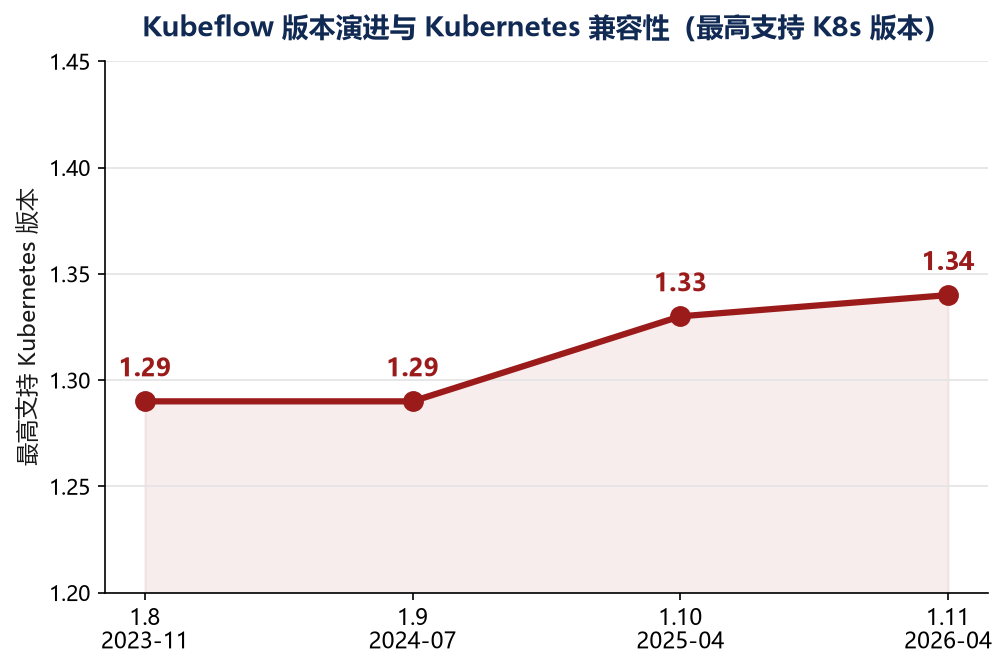
图3 · Kubeflow 版本演进与 Kubernetes 兼容性(数据来源:Charmed Kubeflow 支持矩阵 + 社区发行版说明)
需要提醒的是:社区发行的尽力支持期约为 6 个月,面向生产的组织通常还需要 Canonical Charmed Kubeflow 等发行版或厂商的商业支持来获得更长的维护窗口。这也是"能否上生产"的关键决策点。
四、训练实战:从 Notebook 到分布式微调
部署只是起点。真正决定平台价值的,是算法团队能否用最少的认知成本,把模型从交互式探索推进到大规模训练。这一节按"开发 → 调优 → 训练 → 编排"的顺序,给出可落地的最小示例。
4.1 模型开发:Notebooks 交互式环境
Kubeflow Notebooks 在集群内以 Pod 形式提供 Jupyter / VSCode 环境,数据不落本地、算力用集群 GPU,天然可复现、可共享。最佳实践是先在 Notebook 里把单机脚本调通,再把它封装成 Pipeline 组件或 Trainer 训练函数,实现"探索即生产"。
4.2 分布式训练:Trainer + SDK 的 train() API
Kubeflow Trainer 支持数据并行与模型并行,覆盖 PyTorch、DeepSpeed、JAX、TensorFlow、MLX、Megatron、HuggingFace、XGBoost 等框架,可实现 SFT、知识蒸馏、DPO、PPO、GRPO、量化感知训练等。下面这段基于 SDK 的代码,用官方预置的 BuiltinTrainer 蓝图,在几行内完成一次 LoRA 微调:
from kubeflow.trainer import ( TrainerClient, Initializer, HuggingFaceModelInitializer, BuiltinTrainer, TorchTuneConfig, TorchTuneInstructDataset, DataFormat, DataType, ) client = TrainerClient() client.train( runtime=client.get_runtime("torchtune-llama3.2-1b"), initializer=Initializer( model=HuggingFaceModelInitializer( storage_uri="hf://meta-llama/Llama-3.2-1B-Instruct", access_token="hf_xxxxxxxxxxxxxxxx", ) ), trainer=BuiltinTrainer( config=TorchTuneConfig( dataset_preprocess_config=TorchTuneInstructDataset( source=DataFormat.PARQUET, split="train[:1000]", new_system_prompt="You are an AI assistant. ", ), epochs=10, dtype=DataType.BF16, resources_per_node={"memory": "200G", "gpu": 4}, ) ), )这段代码的价值在于:算法工程师没有写一行 Kubernetes YAML。Trainer 会自动把它翻译成 Training Job,按 resources_per_node 申请 GPU、调度 Pod、挂载数据,并把 checkpoint 落盘。任务规模从 4 卡扩到数千卡,改的只是资源配置,而不是平台代码。
4.3 超参调优:Katib 让搜索自动化
Katib 是 K8s 原生的 AutoML 组件,用 Experiment 定义搜索空间与优化目标(如最小化 loss、最大化 BLEU),支持早停以节省算力。在 RAG 场景里,它常被用来扫描 top_k、temperature 等检索参数,自动找到最优组合。它同时可调度分布式 PyTorchJob,对 LLM 做超参优化。
4.4 工作流编排:Kubeflow Pipelines
KFP 用 Python 定义端到端流水线,每个步骤都是一个容器化的 component,天生可移植、可复现:
from kfp import dsl @dsl.component(base_image="python:3.12", packages_to_install=["pandas"]) def preprocess(raw_path: str, out_path: str): import pandas as pd df = pd.read_csv(raw_path) df.to_parquet(out_path) # 特征工程 / 清洗 @dsl.component(base_image="pytorch/pytorch:2.4.0-cuda12.1-cudnn9-runtime") def train(data_path: str, model_out: str): import torch # 训练并导出模型 torch.save({"w": 1}, model_out) @dsl.pipeline(name="demo-ml-pipeline") def pipeline(raw: str): p = preprocess(raw_path=raw, out_path="/data/clean.parquet") train(data_path=p.output, model_out="/data/model.pt") # 编译为可提交给 KFP 的 IR YAML from kfp import compiler compiler.Compiler().compile(pipeline, "demo.yaml")把上面几个环节串起来,就得到一条完整的 MLOps 主线:Notebook 探索 → Katib 调优 → Trainer 训练 → Hub 登记版本 → KServe 上线推理,而 Pipelines 负责把每一步编排、调度与追溯。
架构师视角:Kubeflow 真正节省的不是"装工具的时间",而是团队之间的协作成本。当数据、算法、平台三方共享同一套 K8s 原生抽象,交付一个模型从"跨三个系统的项目"变成"一次 Pipeline 提交"。
五、GenAI 时代:从预测式 ML 到 LLM 全流程
Kubeflow 的应用早已溢出传统的预测式机器学习。在生成式 AI 浪潮里,它的模块化与 K8s 原生架构,让"从合成数据到推理服务"的端到端 GenAI 流水线既能复现、又能上生产。官方文档明确列出了七类核心用例:
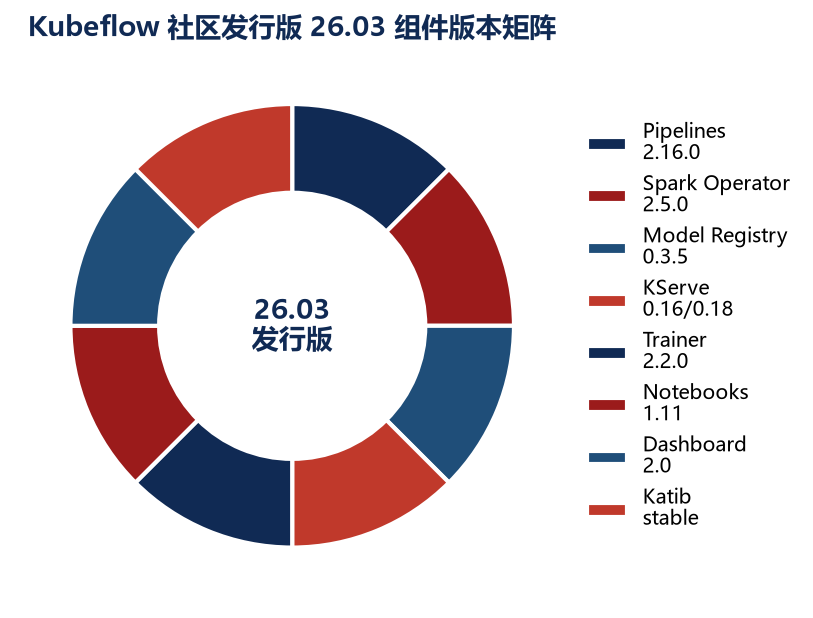
图4 · 社区发行版 26.03 组件版本矩阵(数据来源:kubeflow/community-distribution 26.03 发行说明)
5.1 推理与评估:把"闭环"补齐
训练与调优之后,KServe 通过 Kubernetes 自定义资源暴露模型,自动化蓝绿/金丝雀发布,并基于实时指标(CPU、GPU、请求延迟)自动扩缩;KServe 0.16/0.18 已扩展了集群内外、非 Knative 原生部署下的认证与授权测试。评估环节则被"编码"进 Pipelines——统计基准、BLEU/ROUGE、Katib 早停规则共同构成数据→模型→指标的版本化血缘,让模型不容易漂移与退化。
一个典型的落地范式是金融风控:用 Kubeflow Pipelines 编排从数据准备、特征工程、模型训练、评估到部署的完整欺诈检测 MLOps 工作流,实现端到端的自动化与可追溯。这也印证了官方的判断——Kubeflow 的用例已经远超预测式 ML。
六、结语:Kubeflow 的"标准"野心
把 Kubeflow 放回大图景里看:它是 CNCF 项目,已正式申请 CNCF Graduation,正从"可用"走向"成熟生产就绪"。26.03 版本把重心放在可扩展性与安全性,明确了 Kubernetes 1.34+ 的支持边界,也让多租户默认配置更加坚固。与此同时,Outreach Program、ML Experience Working Group 等社区项目在持续降低使用门槛。
对架构师而言,Kubeflow 的意义不在于"又一个平台",而在于它给出了一个可组合、可移植、生产就绪的参考实现:你不必全盘接受,却可以按需取用其中任意一块,让 Kubernetes 真正成为数据与 AI 工作负载的统一底座。这,或许正是它从 Google 内部工具,长成云原生 AI 事实标准的根本原因。
上手建议:先用 Kind + 社区 Manifest 在本地把 Central Dashboard 跑通,再用 Notebook 跑一个单卡训练,最后把它封装成 Pipeline 并交给 Trainer 做分布式。三步走完,你就拥有了一个可演进到生产的云原生 AI 平台骨架。
附录 · 速查手册
A. 核心组件速查



