👉 这是一个或许对你有用的社群
🐱 一对一交流/面试小册/简历优化/求职解惑,欢迎加入「芋道快速开发平台」知识星球。下面是星球提供的部分资料:
👉这是一个或许对你有用的开源项目
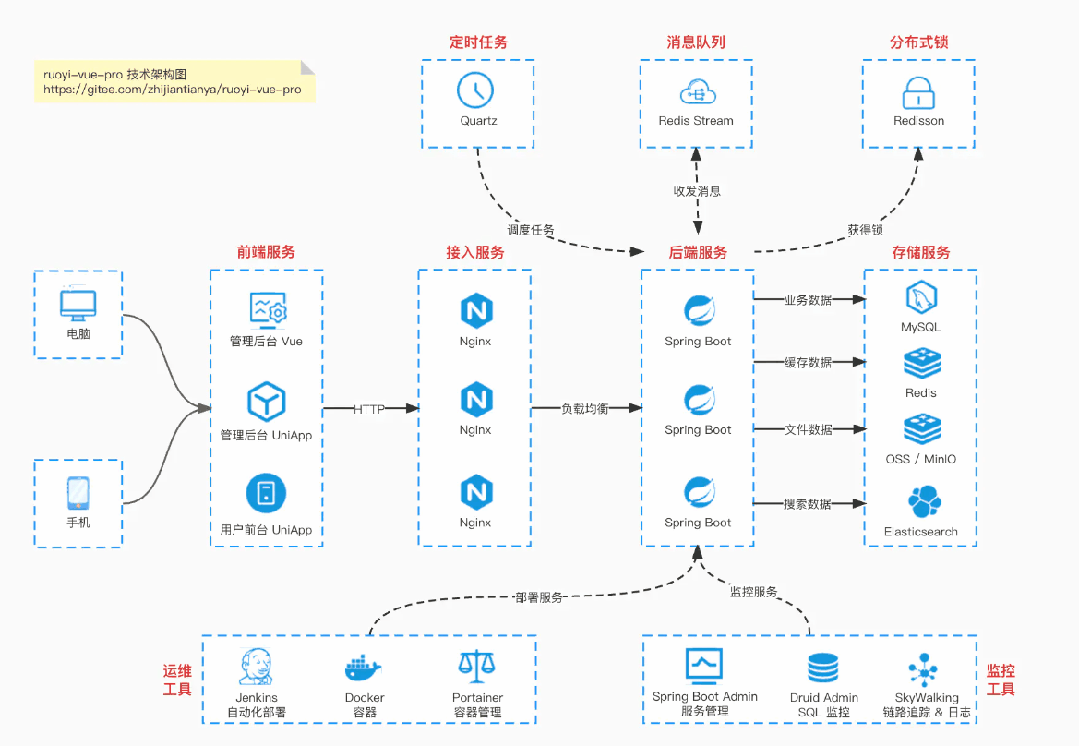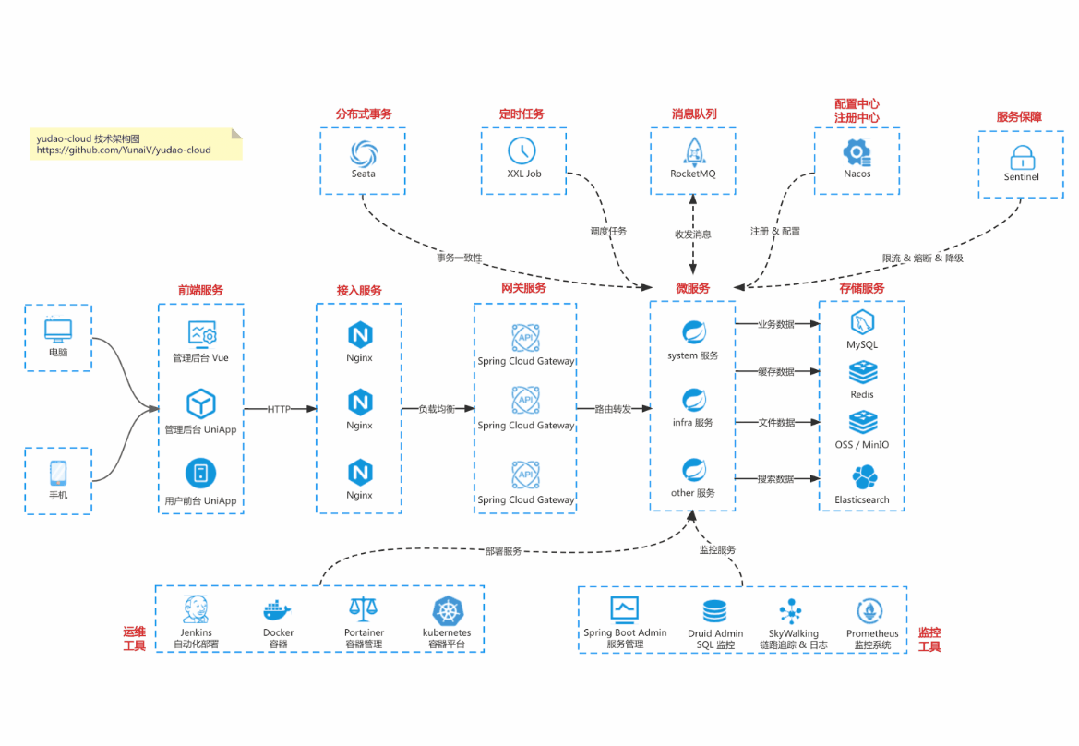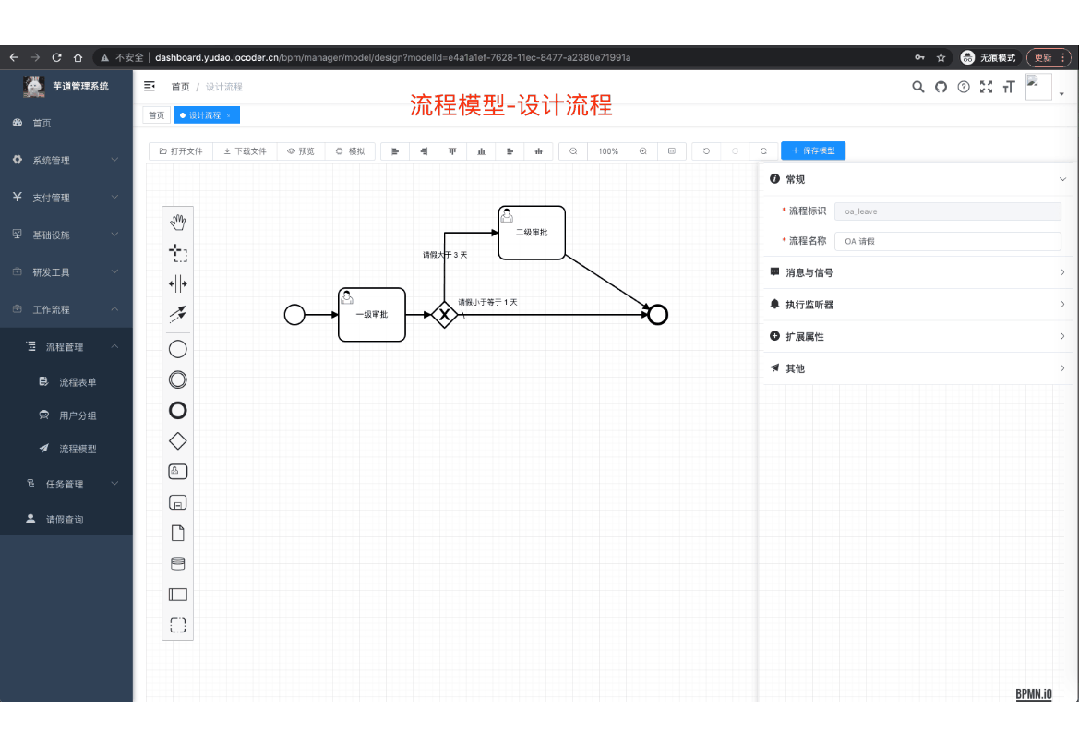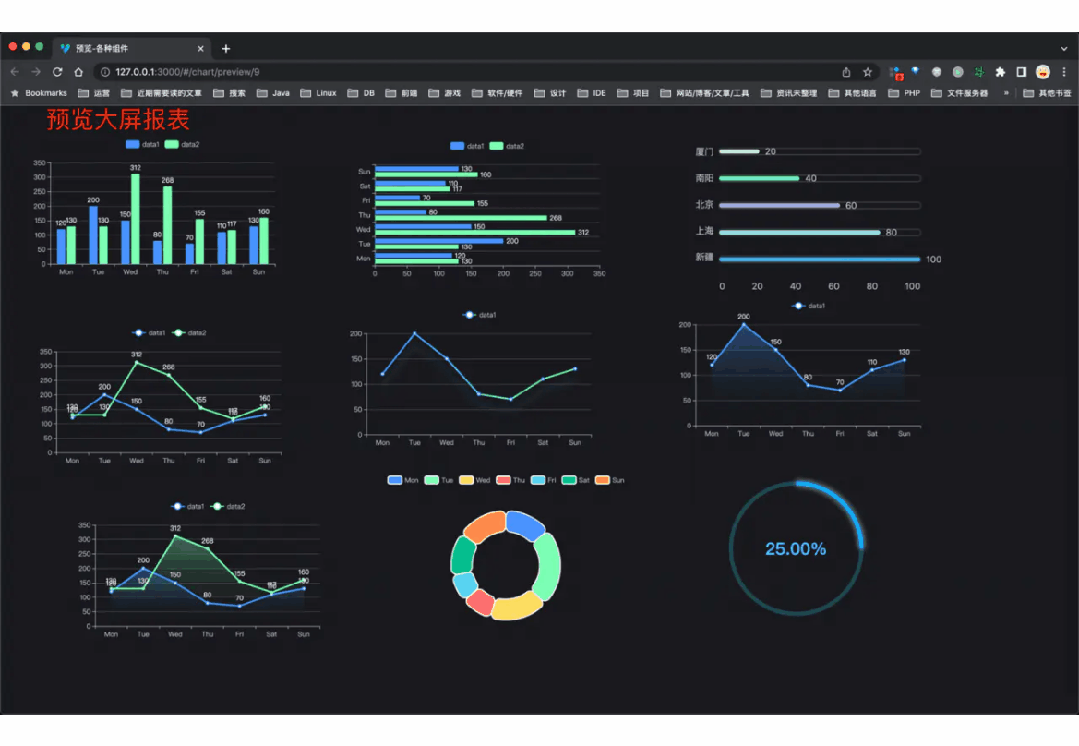
国产Star破10w的开源项目,前端包括管理后台、微信小程序,后端支持单体、微服务架构
RBAC权限、数据权限、SaaS多租户、商城、支付、审批工作流、大屏报表、ERP
、CRM、WMS、MES、EAM、HRM、OA、FMS、PMS、AI大模型、AI工作流、AI Agent、IoT物联网、IM实时聊天等功能:
- 多模块:https://gitee.com/zhijiantianya/ruoyi-vue-pro
- 微服务:https://gitee.com/zhijiantianya/yudao-cloud
- 视频教程:https://doc.iocoder.cn
【国内首批】支持 JDK25 + SpringBoot4、JDK17/21+SpringBoot3、JDK8/11+Spring Boot2三版本 QUOTE
4GB 显存的边界,可以换成硬盘,但速度账单照样要付。
本地跑大模型的人绕不开量化这个词。模型装不下显存,就压成 8bit、4bit,效果差一点也得接受,不然根本跑不起来。我自己的显卡 8G,不量化的话,14B 以上想都不用想。
前阵子翻到 AirLLM 这个项目,它做的事刚好相反,不量化,不蒸馏,不剪枝,跑原始权重,然后告诉你 4GB 显存能跑 70B,140GB 的东西塞进 4GB 显存里,听着就不太对劲。我把 README 和社区的实测帖都翻了一遍,确认不是吹牛。
它是个 Python 库,Apache 2.0 协议,现在三万五千多 Star。用途就一个,让显存不大的显卡也能跑大模型。
— 仓库首页实时截图,Star 与 Fork 计数同时可见
— 传统量化路径与 AirLLM 路径对照
大模型推理不是整个模型同时干活,是一层一层往下算的。AirLLM 的做法是显存里只放当前这一层,算完挪走,再读下一层进来;模型权重整个放在硬盘上,用到哪层读哪层。
— 按层读取,显存只放当前层
所以显存占用只取决于单层多大,跟模型总大小没关系。70B 的模型一层大概 1.6GB,4GB 显存够用。
ruoyi-vue-pro
基于 Spring Boot + MyBatis Plus + Vue & Element & Ant Design 实现的后台管理系统 + 用户小程序,RBAC权限、数据权限、SaaS多租户、商城、支付、审批工作流、大屏报表、ERP、CRM、WMS、MES、HRM、EAM、OA、FMS、PMS、AI大模型、AI工作流、AI Agent、IoT物联网、IM实时聊天等功能
项目地址:https://github.com/YunaiV/ruoyi-vue-pro
视频教程:https://doc.iocoder.cn/video/
这些数字说的都是原始权重,没有经过量化,跑出来的效果就是模型本来的效果。前三行用的是「约」,只有 Kimi K3 那行是「实测」,官方还标了它是在一张 RTX 6000 Ada 上端到端跑出来的。
yudao-cloud
基于 Spring Cloud Alibaba + Gateway + Nacos + RocketMQ + Vue & Element & Ant Design 实现的后台管理系统 + 用户小程序,RBAC权限、数据权限、SaaS多租户、商城、支付、审批工作流、大屏报表、ERP、CRM、WMS、MES、HRM、EAM、OA、FMS、PMS、AI大模型、AI工作流、AI Agent、IoT物联网、IM聊天等功能
项目地址:https://github.com/YunaiV/yudao-cloud
视频教程:https://doc.iocoder.cn/video/
— MoE 只加载当前专家
用法就是传一个模型 ID,一行代码的事。支持列表很长,Llama 2、3、3.1、4,Qwen 全系列,DeepSeek V2 与 V3 与 R1,Mistral、Mixtral、Phi、Gemma、ChatGLM、百川、InternLM、Yi。官方说新出的热门模型基本发布当天就能用。
MoE 架构的还能再省一层。DeepSeek-V3 和 Kimi K3 这种每次推理只激活一部分专家,AirLLM 就只把当前用到的那个专家读进来,所以 2.8T 的模型显存占用也不高。
— 压缩前后速度对比
默认是不压缩的。想快一点,它给了 4bit 和 8bit 两种压缩选项,官方说最多快 3 倍。README 里那张对比图上是同样一段推理的三个耗时,不压缩 449 秒,8bit 是 237 秒,4bit 是 157 秒。
按最后两个数算,实际倍率是 2.86 倍,官方说的「最多 3 倍」是按四舍五入说的,心里有个数就行。代价是精度有一点损失,官方的说法是可以忽略。
要开压缩,先装 bitsandbytes,命令在下一节。
— 预取机制,计算和读取并行
没有 N 卡也能用。Mac 只支持 M 系列芯片,装好 mlx 和 torch,代码跟在 Linux 上写的一样;纯 CPU 推理也支持,速度更慢,但能把流程跑通,适合手头什么卡都没有的情况。
另外有个默认就开着的预取机制。GPU 算当前这一层的时候,下一层已经在后台从硬盘往内存里读了,两件事同时进行,官方说能快 10% 左右。这个不用做任何配置。
pip install -U bitsandbytes
代码跟平时用 transformers 差不多,把初始化那一行换掉,其余照写。
from airllm import AutoModel
MAX_LENGTH = 128
model = AutoModel.from_pretrained("Qwen/Qwen3-32B")
input_text = ["中国的首都是哪里?"]
input_tokens = model.tokenizer(input_text, return_tensors="pt",
return_attention_mask=False, truncation=True, max_length=MAX_LENGTH)
generation_output = model.generate(input_tokens["input_ids"],
max_new_tokens=20, use_cache=True)
print(model.tokenizer.decode(generation_output.sequences[0]))
想跑更大的模型,改一行模型名就行。Qwen3-235B 大概占 3GB 显存,DeepSeek-V3 大概占 12GB。
— 第一次运行,磁盘空间要留足
第一个是磁盘。第一次跑的时候它会先把模型整个下载下来,再一层一层拆开存到磁盘,所以空间要留两倍。70B 的模型光下载就要 130GB 上下,拆分还会再占一份;磁盘不够时它报的错很迷惑,官方 FAQ 专门为这条写了一节。
第二个是硬盘类型。模型文件最好放 SSD 上,它大部分时间花在从硬盘读权重,机械硬盘会慢到离谱。硬盘实在紧张,可以传 delete_original=True,拆完之后把原始模型文件删掉,能省一半空间。
第三个是权限。Llama 这类需要申请权限的模型,要传 Hugging Face 的 token 才能下载;Qwen 和 DeepSeek 这些没有这道门槛,直接下。
— 使用场景,适合与不适合各三种
适合的第一类是离线批量任务。本地有一批文档要总结、一批数据要打标,扔给它慢慢跑,跑一晚上出结果,这种场景速度不重要,能跑完就行。
第二类是本地实验和学习。想看看 70B 到底是什么水平,又不想租云上的卡,用它在自己机器上就能试;跑的是原始权重,看到的效果就是模型真实的效果,没有被量化坑过一遍。
第三类是数据不能出本地的场合。有些行业的数据没法传到外面的服务上,本地部署是硬要求而显存又不够,这种时候它是少数几个能走通的方案。
不适合的只有一类,但这一条很硬,任何要实时交互的场景都不行。在线聊天、客服、代码补全,这些等不起。它的速度瓶颈在硬盘读数据上,快的时候一两秒出一个字,慢的时候几十秒一个字都有可能。社区里有人在 RTX 6000 Ada 上实测过将近 300 秒一个字的成绩。想本地跑聊天助手,用 llama.cpp 或者 Ollama 加载量化模型,体验好得多。
我对这个项目的定位是,它解决的是能不能跑的问题,不是跑得快不快的问题。
Hacker News 上有人拿速度说事,说一分钟出不了几个字。速度确实是它的短板,这个没什么好争的。但反过来想,手里只有消费级显卡的人,以前根本没机会在自己机器上碰 70B、671B 这个量级,现在至少能跑了;批量任务挂一晚上,早上起来看结果,我觉得可以接受。
我做 Java 出身,早几年用大模型就是调接口,接口后面怎么跑的跟我没关系。这两年自己折腾本地模型才发现,显存是最现实的一道坎,多大的模型、多少钱的卡,先过这一关再说。AirLLM 把这关的门槛拉得很低,这是我介绍它的理由。
最后强调一句,如果你只是想本地跑个助手聊天,别用这个,等一个字几十秒谁也受不了。它适合的就是批量任务和本地实验这两类事。
仓库地址是 https://github.com/lyogavin/airllm 。最后交代一句,我没实际跑过 AirLLM,上面所有数字都来自官方 README 与来源正文,效果和速度建议自己拿一个小模型先试一遍。
欢迎加入我的知识星球,全面提升技术能力。
👉 加入方式,“长按”或“扫描”下方二维码噢:
星球的内容包括:项目实战、面试招聘、源码解析、学习路线。
文章有帮助的话,在看,转发吧。
谢谢支持哟 (*^__^*)



