大家好,我是Bite
随着我自己年龄的增长,在我自己的认知中,有了一定的原始积累后,金融是我们就业的终极形态。因此,用AI编程助手:能不能让 Claude Code 也帮我看看股票? 这件事情就变的比较重要了。
想法很自然AI能读财报、能算估值、能写分析,理论上是个不错的投研搭子。可真上手就卡住了:AI 编程助手默认拿不到任何行情数据,你让它看 K 线、查资金流,它只能开始编数字。 想让 AI 做投研,先得解决一个更底层的问题:把 A 股数据喂给它。
最近刷到一个项目,5 个月冲到 11k 星,干的就这一件事把散落在 34 个数据源里的 A 股数据,封装成一个 AI 助手直接能调的 Skill 文件。
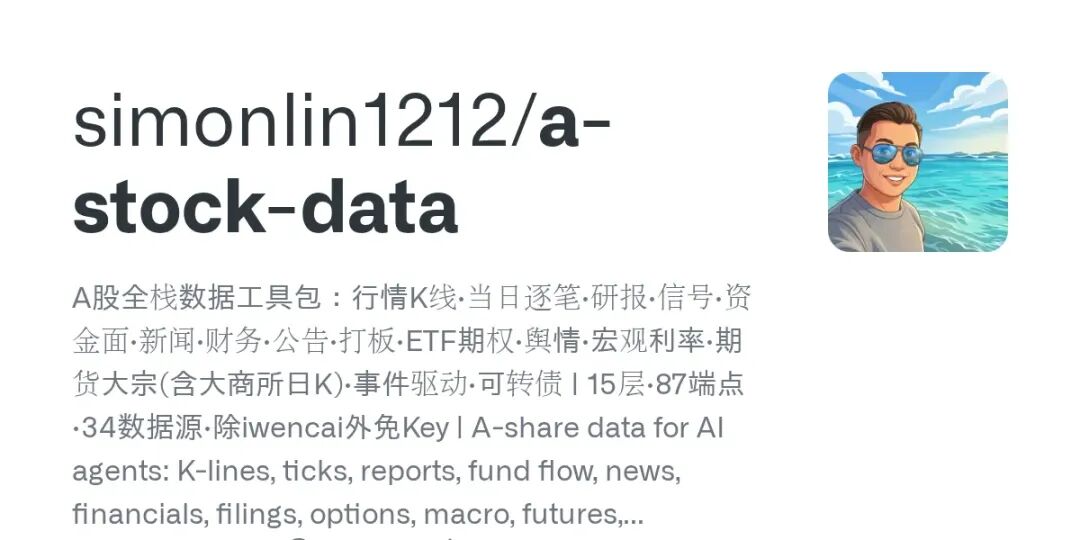
A 股数据的"万能转接头"
简单来说:
a-stock-data 把 A 股 15 类数据、87 个端点、34 个数据源,全塞进了一个 SKILL.md 文件里。
这个 SKILL.md 本质是结构化 Markdown + 内嵌 Python。你把它装进 Claude Code、Codex、OpenClaw、WorkBuddy 这些 AI 编程助手,AI 就突然"看得懂"沪深行情了。实时价、K 线、研报、资金流、财务、公告、打板、期权、期货、可转债,全都能查。
最香的一点是:除了 iwencai 一个源需要 Key,其余 33 个数据源全部零鉴权,装完就能用,不用注册任何账号。
作者是个人开发者 Simon 林,一个把"让 AI 能看 A 股"这件事做到极致的人。
三个直击痛点的设计
一是覆盖面广到离谱。 15 层架构从行情、研报、信号、资金面,一路铺到宏观利率、期货大宗、事件驱动、可转债。连大商所日 K 这种稀缺数据都有很多付费数据源都未必齐。
二是把脏活全替你干了。 你不用再背腾讯 K 线的分段参数、通达信盘后包的二进制格式、东财的 Referer 头。这些"接口黑话"作者全封装好了,你只需要说一句人话。
三是主源被封自动降级。 每个核心数据都配了独立备胎——东财被封走交易所官方,巨潮挂了走深交所直连。这是真正跑过生产的人才会想到的设计。
为什么它敢"零鉴权"
它最聪明的地方,是数据源优先级策略。官方文档里白纸黑字写着原则:能用腾讯和交易所官方,就别碰东财。
原因是东财系接口有频率风控,封 IP 会成片失联。所以作者把数据源按"封 IP 风险"排了序:腾讯财经、交易所官方放最前(不封 IP),东财压到最后(只用于它独有、别处拿不到的数据),且全部走 em_get() 串行限流。
架构上另一个硬核决定是:直连 HTTP API,不经任何第三方数据封装。它甚至为此在 V3.0 主动移除了 akshare。因为中间层多一层就多一个故障点。这份"去中间商"的工程洁癖,是它能稳定跑的关键。
安装与配置
# 1. 建目录
mkdir -p ~/.claude/skills/a-stock-data

# 2. 把 SKILL.md 放进去
curl -o ~/.claude/skills/a-stock-data/SKILL.md \
  https://raw.githubusercontent.com/simonlin1212/a-stock-data/main/SKILL.md

# 3. 装依赖
pip install mootdx requests pandas stockstats numpy baostock xlrd openpyxl
然后直接说人话:帮我估一下 688017,给 PE / PEG / 消化时间,它自动激活。
项目还内置了 4 套调研流程:单票估值 30 秒、批量对比 1 分钟、主题研报 2 分钟、新标的调研 1 分钟。对个人投资者来说,这几乎是把一个初级研究员的活儿自动化了。
从单机玩到工作流
它不只是个查询工具,能串成投研流水线:
- 批量对比:一句话对比 5 只半导体股的估值,横向排好序。
- 新标的调研
:机构覆盖 → 估值 → 概念板块 → 资金流向 → 龙虎榜 → 解禁 → 两融,一条龙走完。
- 接量化:
to_joinquant() 能把代码转成聚宽格式,数据直接喂给回测框架。
三件事必须讲清楚
抛开亮点,这个项目有三个不能回避的硬伤:
一是合规灰色地带。 它采集的 34 个源是公开接口,但公开接口的合法性和再分发,本身就处在灰色区域。证券数据经营需要牌照,项目定位是"个人研究用途"企业商用、对外提供服务,得先想清楚这条线。
二是数据源变动风险。 项目依赖腾讯、东财、同花顺这些"非承诺稳定"的接口,上游一改就失效。FAQ 里 #52 就记录了 2026 年 9 月通达信行情接口整体失效的事,作者是靠"多源降级"硬扛过来的。
三是不带回测引擎。 它只负责取数,回测得交给聚宽或你自己的框架。而且它自己也写得很清楚:仅提供数据工具,不构成任何投资建议。
个人观点
这个项目我最觉的棒的地方,是它戳中了一个被低估的范式:AI Agent 的瓶颈,往往不在模型,在数据接入。
Claude Code、Codex 这些工具已经很强了,但一碰到垂直领域A 股、法律、医疗就集体"失明",因为拿不到结构化数据。a-stock-data 的价值,是证明了一件事:把散落的公开数据封装成 Agent 能消费的形态,本身就是一件值得 11k 星的硬活。
不过话说回来,它再香也是个"取数工具",不是"赚钱机器"。用它做研究、做数据准备没问题,但别指望它替你判断买卖那件事,AI 和工具都替代不了你自己的判断。股市有风险,工具再顺手,本金也是你自己的。
Github开源地址:https://github.com/simonlin1212/a-stock-data
点击下方卡片,关注极客AI开源圈
本号持续更新实用有趣的开源项目。如果你不想逐篇翻阅往期文章,可以直接关注公众号【极客AI开源圈】,在后台留言与号主互动交流。
如有收获,请您点个赞+分享+推荐,谢谢您呐!



