文章来源:Optiver 技术博客
作者:Denis Perevalov,量化研究员
在大多数机器学习任务中,模型不会直接改变它所预测的环境。但金融市场不同:当一个模型发现交易机会并采取行动时,竞争对手可能抢先成交、撤单或调整报价。模型不仅要预测市场,还必须面对一个会不断适应自身行为的竞争系统。
Optiver 量化研究员 Denis Perevalov 在本文中,从做市商的定价问题出发,讨论机器学习如何利用市场信号、为什么历史回测难以还原真实交易,以及为何有效的 Alpha 也会随着竞争而衰减。文章还进一步解释了交易所规则如何影响模型表现,以及为什么交易模型上线后,研究仍远未结束。
TL;DR:Optiver 核心观点
- 1. 交易模型不是市场的旁观者。 模型一旦开始交易,就会影响它试图预测的市场。竞争对手可能抢先成交、撤单或调整报价,原本存在的机会也可能因此消失。
- 2. 机器学习的优势在于组合大量弱信号。 订单簿、成交、价格与跨市场变化相互作用,单一信号的预测能力有限,但将它们有效组合,可能形成有价值的定价优势。
- 3. 回测必须还原当时的信息和真实成交条件。 模型只能使用决策时已经获得的信息。历史某个价位出现成交,不代表自己的订单一定能成交;即使成交,也可能面临逆向选择。延迟、排队位置和交易成本,都可能让回测中的利润在真实交易中消失。
- 4. 真实的 Alpha 也会被竞争消耗。 一个模型即使没有过拟合,预测关系也确实存在,其优势仍可能随着其他交易者发现并利用相同信号而衰减。模型没变,市场已经变了。
- 5. 交易所规则本身就是模型的一部分。 撮合优先级、最小报价单位、手续费与订单类型会改变成交概率和收益结构。同一模型在不同交易场所未必同样有效。
- 6. 模型上线不是研究的终点。 真实交易会暴露回测无法完全模拟的市场反应。研究者需要持续观察模型表现,识别市场变化,并据此调整研究方向。
正文精编
在物理或数学等领域,一项研究成果到产生现实影响,间隔可能长达数年。交易则会给出直接而清楚的反馈:一个想法和结果之间的联系很近,环境又充满竞争,持续变化。在大多数机器学习领域,产生数据的系统并不知道、也不在乎你正在研究它;交易市场里,其他参与者却都在努力解决与你相同的问题。
这样的环境奖励直觉与创造力,而不只是日复一日地寻找某个真理。把机器学习用于交易,本身就是一项真正需要智力投入的研究;它既吸引金融业者,也吸引数学家、物理学家、程序员和学者。
在竞争系统中建模
Optiver 是一家做市商,持续买卖金融工具,并报出愿意买入和卖出的价格,两者之间存在买卖价差。如何定价是一个研究问题,而且这个问题发生在实时竞争的系统内部。
模型本身就是它试图预测的系统的一部分。在一般的机器学习问题中,人们通常认为数据和环境的行为大体已知,而且模型不会改变它们;在交易中,模型的行动会改变环境。如果模型判断一笔交易有利可图并试图成交,可能出现两种结果:
- 2. 交易成交了,但也许是因为竞争对手不想做这笔交易。究竟是我们的模型判断正确,还是对手的模型判断正确?
策略依据信号行动后,其他参与者可能在几微秒内作出反应:撤掉报价、扩大买卖价差,或修正自己的模型。你发现的优势,取决于那一刻所有参与者的共同表现;一旦你开始行动,你自己也成了其中一员。因此,真正的研究问题是:当我们参与定价的系统也在主动适应我们时,怎样仍然准确地定价?
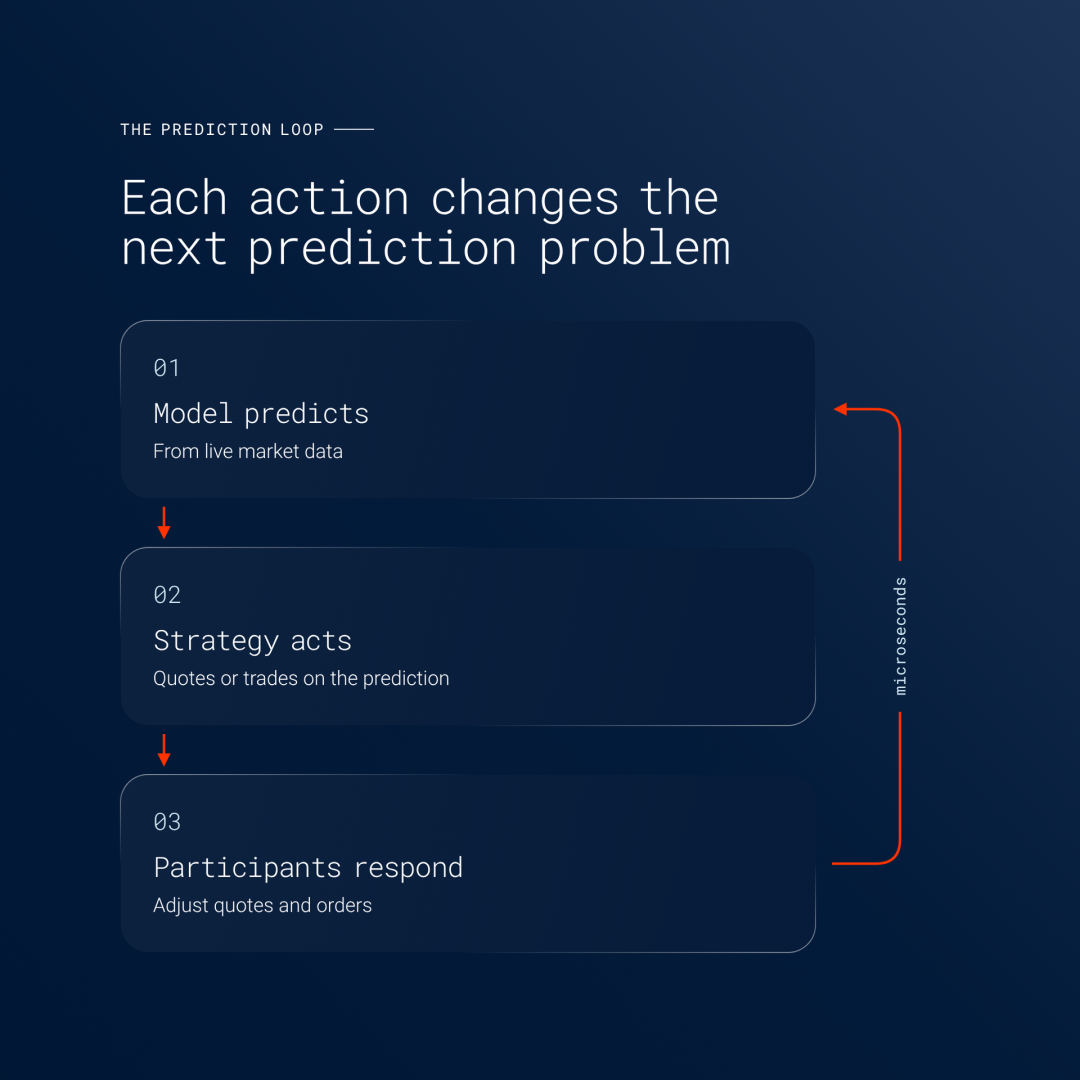 交易研究反馈循环示意图
为什么机器学习适合这个问题
市场不断产生大量结构化数据:许多金融工具和交易所的价格、订单、成交量及其他交易活动。在高频交易中,买卖决策需要以极快的速度、大规模地反复作出。检验目标也很明确:模型有没有帮助我们更准确地定价、更好地管理风险、完成更有利可图的交易?
机器学习适合处理这些数据,因为它们无法被压缩为一条简单规则。价格可能同时受到数百个微弱信号影响:刚刚发生了什么成交,订单簿怎样变化,相关金融工具怎样波动,竞争对手又作出了什么反应。单独看,每个信号说明不了多少;把它们恰当地组合起来,就可能发现难以用简单规则表达的关系,给相互竞争的信号分配合适的权重,在新信息出现时更新预测,并迅速反馈哪些方法有效。
采用传统统计方法时,研究者通常要预先指定变量之间的关系结构。但在市场微观结构中,这种结构会随市场状态、产品和预测期限变化。机器学习能让数据呈现研究者未必会主动寻找的结构。在信号众多、信号间的相互作用又难以事先预见时,这一点尤为重要。
为什么历史回测难以还原真实交易
在让模型接触真实市场、冒实际资金风险之前,研究者可以先用大量历史数据检验它。通常的起点是一个反事实问题:如果当时运行的是这个模型,它会怎么做?它能否更准确地预测价格变化、报出更有竞争力的买卖价差、避开不利的交易?
首先,模型在每个历史时点只能使用那个时点确实能够获得的信息。如果把明天的价格泄漏进今天的数据,回测就无效。其次,还必须真实地模拟交易执行:如果别人先成交了,或者订单传输期间订单簿已经变化,一个看似很好的报价也没有意义。交易费用、延迟,以及具体交易所的运作方式,也都会造成摩擦。
假设我们在订单簿的最优买价挂出一笔被动买单。历史数据表明,这个价位后来有成交,粗糙的回测便会记下一次买入。但在真实市场里,这笔成交很可能是因为一位急于卖出的交易者打穿了该价位;买单成交的同时,价格可能已经开始对我们不利。回测看见的是一笔已完成交易,现实中发生的却可能是逆向选择:其他人选择不再留在那个价位,我们才得以成交。
还有一个更深的问题:用于回测的历史数据里,本来就没有这项待测试策略。再漂亮的回测也不是证明。研究者必须判断:模型究竟学到了市场里的规律,还是只学会了适应回测本身?
非平稳性与模型衰减
一种模式可能确实存在,但建立模型时所依赖的数据环境已经变化。这就是非平稳性。许多来到我们这里的量化研究员以前从事变化较慢、基本假设相对稳定的领域;这种变化也正是交易研究吸引他们的原因之一。
衰减最快的,有时恰恰是最前沿的模型:它们发现了真实关系,回测表现很好,也没有过拟合。问题是,其他参与者也发现了同一个信号,并通过交易消耗掉模型原本可以捕捉的机会。曾经的优势变成了市场共识。最初的想法没有错;市场围绕它适应了。模型没有变,周围的世界却变了。等到汇总后的表现明显下滑,底层问题可能已经存在很久了。也许只是几天,但对高频交易而言,几天已经很漫长。
最好的模型,不是来历最漂亮的模型,而是现在仍然有效的模型。
相同的交易,不同的规则
交易所本身也会给研究增加难度。每个交易场所的参与者构成、收费方式、最小报价变动单位、订单类型和撮合规则都不一样。在高频交易中,这些差异会改变数据的含义,也决定策略能否按设计执行。
订单在队列中的位置就是一个例子。多人报出相同价格时,交易所的规则决定谁先成交;这些规则因场所而异,有时甚至会彻底改变数据的含义。你的订单会先于对手成交,还是在别人都撤离某个价位后成为最后一笔挂单,都取决于这些规则。模型必须考虑订单按计划成交的可能性,因为哪怕规则只发生很小的变化,也可能改变整个交易所内的行为。
同一份期货合约还可能在两个最小报价变动单位不同的交易所交易。较小的变动单位意味着价格可以报得更细,它会改变买卖价差的形成、报价队列的深度,以及在各价位提供流动性的收益结构。一个用某交易所数据训练的模型,得出的结论可能对该交易所完全正确,放到另一交易所却明显错误,即使标的合约没有变。
因此,熟悉具体交易环境的领域知识仍然重要。有时,成功取决于对单个交易场所作极其细致的建模;机器学习的规模化能力,需要与熟悉该市场的研究员经验结合。费用调整、订单类型更新,或对参与者报价方式增设限制,都可能使原本有效的策略失效。以人的日常时间尺度看,这些差别似乎微不足道;在高频交易中,它们就是市场的一部分。
为什么研究不会结束
模型真正上线后,我们才会看到回测无法展示的事情。这是研究假设第一次进入竞争系统,也是其他参与者第一次能够对我们的存在作出反应。数据会告诉你某些事情发生了变化;究竟变了什么、是否重要,则需要判断力和领域知识。
交易模型永远不会真正完成,量化研究员的工作也因此不会结束。我们检验一个想法,观察它在真实系统中的表现,再依据观察结果决定下一步研究什么。
而最常挑战你的那个对手,往往是过去的自己。
原文链接:
https://www.optiver.com/insights/technology-blog/machine-learning-in-trading-an-adversarial-research-problem/



