做机器学习、深度学习研究的朋友想必深有体会,很多时候光前期找数据集就要花不少时间。搜出来的资源看着很多,但真正符合自己研究任务的并不一定多,还可能遇到标签不全、数据规模不合适、下载链接失效等问题。
因此,如果只是想找一些通用数据集,我建议你可以先从下面几个渠道入手:
一、常用的数据集获取渠道
- Kaggle:有不少公开数据集,适合做分类、预测、回归等任务,也可以参考其他人的数据处理思路。
- UCI Machine Learning Repository:经典机器学习数据集比较集中,适合入门实验和算法验证。
- Google Dataset Search:可以通过关键词检索不同网站发布的数据集。
- Hugging Face Datasets:更适合查找NLP、LLM以及部分多模态任务的数据集。
这些平台适合自己检索,但如果已经明确了研究方向,逐个平台搜索、核对任务和数据格式,还是会花不少时间。
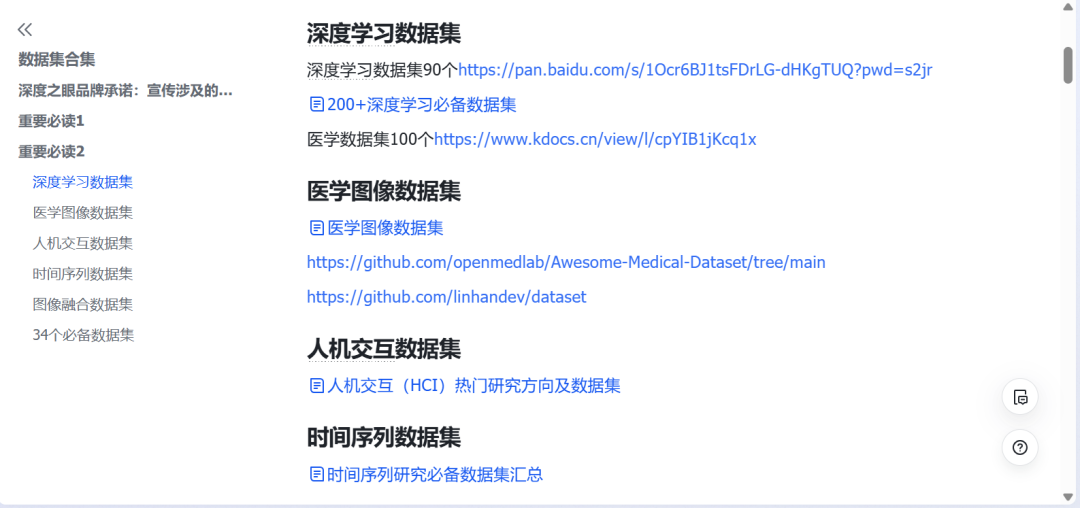
如果你不想自己从头搜索、逐个筛选,我也整理了一批数据集资料,包括200+深度学习数据集,以及医学图像、人机交互、时序数据、图像融合等细分方向的数据集,你可以直接从对应方向入手,省去不少前期搜集资料的时间。需要的朋友可以无偿领取!
二、不同研究方向,重点找什么数据集?
不同研究方向,对数据集的要求也不一样。比如CV,可以从COCO、ImageNet等公开数据集入手,具体还要看自己做的是分类、检测还是分割。
如果是医学图像,重点关注数据对应的疾病、成像类型、标注方式,以及数据使用许可;时序数据常见于交通流量、能源、工业传感器等任务,要留意采样频率、时间跨度和缺失值;人机交互可以围绕用户行为、交互过程、可用性评估等研究问题寻找数据;图像融合要重点确认不同模态或来源的图像是否配对、是否对齐,以及数据是否适用于自己的融合任务。
另外,选数据集时,不要只看数据量大不大。任务是否匹配、标注是否可靠、许可是否允许研究使用,往往更重要。
三、找到数据集后,还要检查什么?
- 任务是否匹配:数据集的任务定义和你的研究问题是否一致?
- 数据质量如何:有没有缺失值、错误标签或严重类别不平衡?
- 使用条件是否明确:是否需要申请,能否用于公开发表的研究?
- 划分是否合理:训练集和测试集之间是否可能存在数据泄漏?
数据集选得合适,后续的模型训练、实验对比和结果分析才更有意义。
如果你正在做深度学习,或者研究方向涉及医学图像、人机交互、时序数据、图像融合,可以领取我整理的数据集资料,后续找数据、做实验时都能用得上。






