CoralNPU 是 Google 开源的边缘侧 RISC-V 加速器 IP,集成标量前端、RVV 向量引擎与实验性 VME 矩阵扩展,设计上强调静态形状与确定性执行。其目标场景为 AI 眼镜、智能戒指等始终在线设备的视觉、音频与轻量 ML 推理,以低功耗与高能效为主要指标 ⚡。
本文以官方架构图、微架构图、数据流图及执行单元图为主线,从总体架构逐层展开至执行单元与同步模型,分析 CoralNPU 将“窄前端、宽后端、静态内存、显式同步”作为核心设计取舍的工程依据 🎯。
📚 目录
一、总体架构:标量前端、解耦后端与 banked 内存
二、三个变体:共享前端与后端能力叠加
三、数据流:指令、内存与后端的物理分离
四、微架构:窄前端与宽后端的结构性对比
五、MLU:单实例三阶段流水
六、MAC 与卷积:小单元、多循环的降级策略
七、SIMD 与向量:解耦后端的指令消化机制
八、AXI 与外部互连
九、LSU 与 banked 内存
十、DMA Engine:粗粒度并行搬运
十一、同步模型:配置在标量核,完成靠轮询
十二、编译栈与编程模型
十三、边界与适用场景
十四、结语
十五、License
🏗️ 一、总体架构:标量前端、解耦后端与 banked 内存
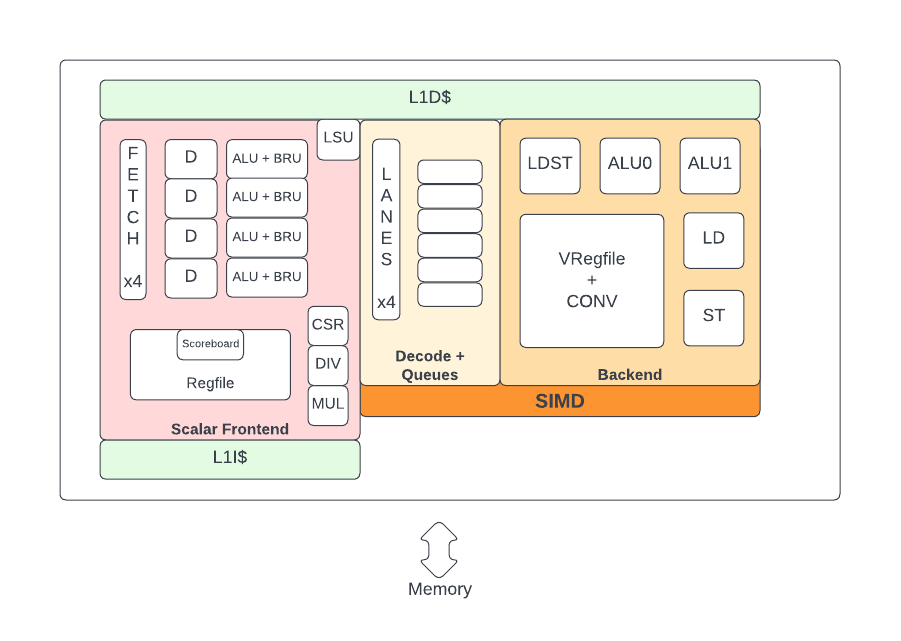
图 1:CoralNPU 总体架构
总体架构将 CoralNPU 划分为若干物理独立的区域:
- • 标量前端:4-lane 顺序派发,负责取指、解码、派发与退休,是整个核心的控制中枢 🧭。
- • 标量执行:ALU、BRU、MLU、DVU、FPU、LSU,承担控制流、地址计算与标量运算 ⚙️。
- • 解耦后端:RVV 向量引擎与实验性 VME 矩阵引擎,二者具有独立的执行节奏 🚀。
- • banked 内存:ITCM、DTCM、CSR 控制区与外部 AXI4/TL-UL 总线 🏦。
该架构的核心信息不在于执行单元数量,而在于各区域之间的连接方式。标量前端通过三条不同的路径驱动后端:
- • 向量指令经“入队”路径进入向量后端的 Command Queue 📥。
- • 矩阵配置经“CSR 写”路径,通过 KISA/KSCM 或
mset* 指令完成配置与启动 🔧。 - • 内存操作统一经由 LSU,标量、浮点、向量、矩阵/tile 的 load/store 均在此汇集 🚪。
标量核并非计算主力,而是控制锚点。
它通过 CSR 写启动矩阵、
通过指令入队驱动向量、
通过状态轮询确认完成 ⚓。
这种非对称控制通道是 CoralNPU 区别于通用 RISC-V 处理器的关键设计。通用处理器通常让所有指令走同一条派发路径;CoralNPU 则承认矩阵与向量是物理上异步的执行体,因此以不同控制通道驱动,并在软件层显式处理同步 🔐。
🎛️ 二、三个变体:共享前端与后端能力叠加
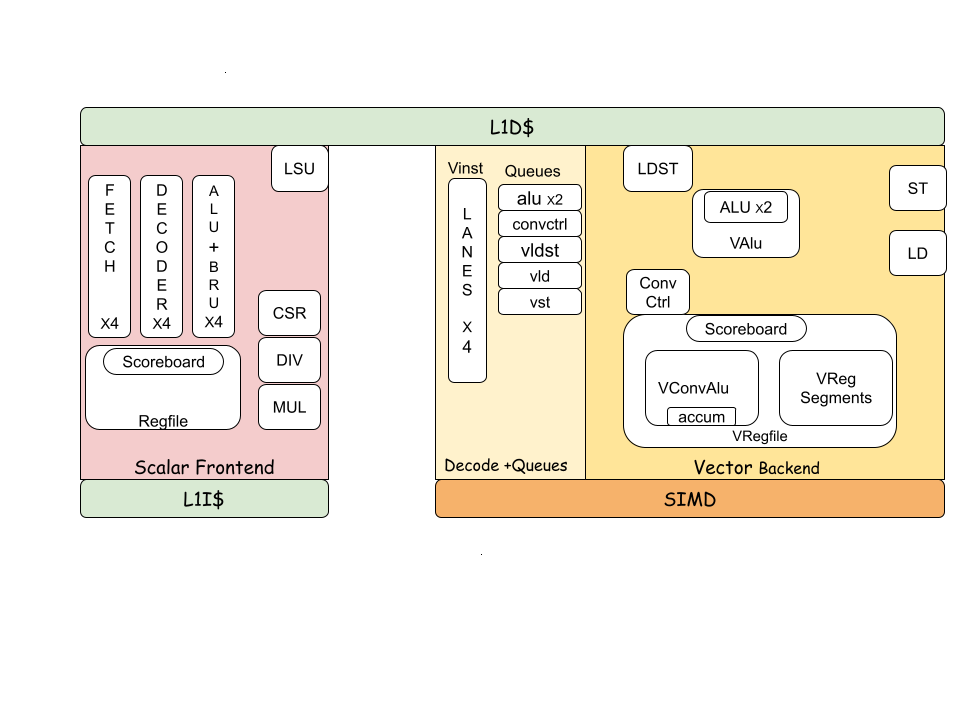
图 2:CoralNPU 模块框图
模块框图说明了三个生产变体的共享结构:
- • CoreMini:标量加浮点基线,ISA 为
RV32IMF_Zba_Zbb_Zicsr_Zifencei_Zfbfmin。执行资源包括 4×ALU、4×BRU、1×MLU、1×DVU、1×FloatCore、1×LSU。无向量、无矩阵,LSU 仅服务标量与浮点访问 🧮。 - • RvvCoreMini:在 CoreMini 上叠加 RVV 1.0,
VLEN=128、32 个向量寄存器(v0..v31)、SEW 8/16/32、LMUL 1/8 至 8。后端包含 8 项 Command Queue、2 级解码器、16 项 Uop Queue、16 项向量 ROB;执行单元包括 2×VALU、2×VMUL/MAC、1×VDIV、2×VFALU、1×VFDIV、1×Permutation/Reduction 🚀。 - • VmeCoreMini:在 RvvCoreMini 上叠加实验性 VME / Zvt,16 个矩阵 tile 寄存器
mt0..mt15,映射至 4 个 sub-tile block(每个 subtile 16 字节)。矩阵配置使用 mtype、msetmtype、msetmtypei、msettn、msettm、msettk 等专用 CSR 与指令,PE 阵列支持 INT8/FP32/BF16 GEMM,另配备 zvt_acc 累加器与 zvt_mt 转置单元 🧊。
三个变体的前端完全一致,同步模型完全一致,差异仅在后端能力。
同一套编译栈与 runtime 可在三个变体上复用,
仅在 lowering 阶段选择是否生成 RVV 指令或 VME 矩阵指令 🧰。
VME 被明确标注为实验性、可选实现 ⚠️。其指令编码、CSR 地址与 PE 阵列细节可能随版本变化;生产配置是否启用、启用后编译栈如何 lowering,取决于具体构建。对于逐 tile 流水线,VME 的同步遵循同一原则:标量核配置矩阵、启动计算、确认完成,再交由向量或标量消费结果 🎯。
🔄 三、数据流:指令、内存与后端的物理分离
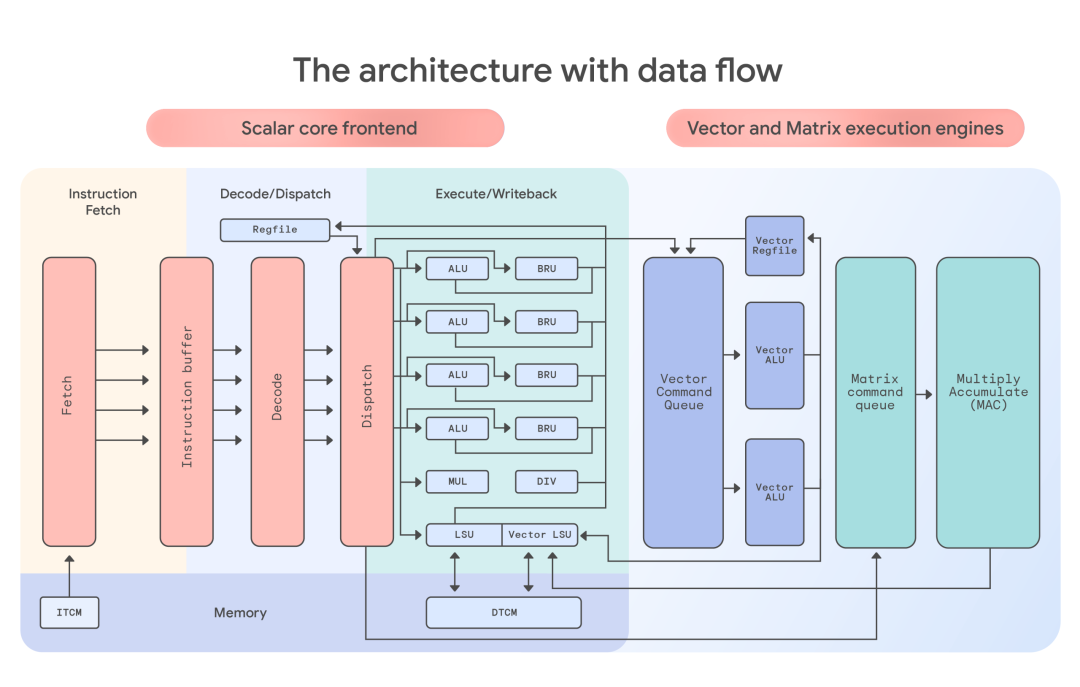
图 3:CoralNPU 架构数据流
数据流图展示了三条主要通路,它们在物理上分离,但在标量核控制下协同工作:
① 指令通路:128-bit IBus 从 ITCM 取指,进入 FetchReorderBuffer 与 InstructionBuffer。取指为无缓存方式,支持静态分支预测。当 PC 超出 ITCM 范围时,取指回退至外部 AXI4/TL-UL 总线。FetchReorderBuffer 允许总线响应乱序返回,再按序放回指令缓冲 📥。
② 标量/向量/矩阵内存通路:128-bit DBus 统一由 LSU 服务。标量 load/store、浮点 load/store、RVV 的 unit-stride/strided/indexed 访问、VME 的 mload/mstore 均经过 LSU。所有执行单元共享同一内存派发口,每周期只能派发一条内存指令 🚦。
③ 外部通路:AXI4/TL-UL master 用于 DDR、系统总线与外设;host/DMA 可通过 slave 端口访问 ITCM、DTCM 与 CSR。DMA Engine 作为交叉开关上的主设备,可独立搬运数据,与标量核执行并行 🌐。
LSU 是唯一的内存出口,每周期仅能派发一条内存指令。
这是内存通路的稀缺资源,
也是编译器必须合并访问、采用连续或 unit-stride 模式的原因 📦。
🧠 四、微架构:窄前端与宽后端的结构性对比
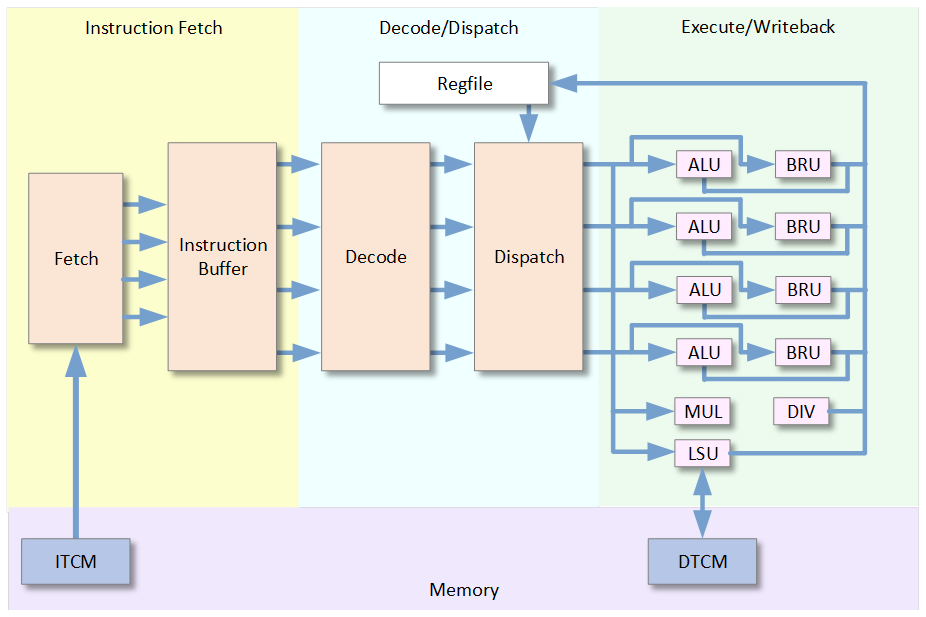
图 4:CoralNPU 微架构
微架构图清晰呈现了前端与后端的分工:
- • 前端为 in-order、三级流水、每周期最多四条派发:Fetch → Decode/Dispatch → Execute/Writeback。解码阶段设 4 个并行解码器,派发阶段设 Hazard Scoreboard、结构规则与控制互锁 🧭。
- • 执行单元延迟:ALU 1 周期、CSR 1 周期、BRU 1 周期、MLU 2 周期、DVU 可变、LSU 2+ 周期 ⏱️。
- • 后端为解耦结构:向量指令进入 Command Queue,矩阵经 CSR 配置与启动 🔀。
该图隐含一个重要事实:4-lane 并不等于任意四条指令可同周期发射。执行单元数量并不对称:
- • ALU 与 BRU 具备足够实例服务每个 lane,每周期各可服务 4 条 ✅。
- • MLU 仅 1 个,每周期最多接受 1 条乘法指令,延迟 2 周期 ⚠️。
因此,4-lane 是一个受结构冒险限制的发射宽度。乘法、除法、浮点、内存、向量命令均会因单实例或有限队列而反压。编译器生成逐 tile 控制代码时,必须考虑这些单实例约束 🧱。
更关键的是特殊指令约束 🔒。CSR 指令(csrrw/csrrs/csrrc)与 fence/fence.i/wfi 等影响核心状态的指令,通常被限制在派发槽 0,并独占派发周期。这不是性能优化,而是矩阵配置与状态轮询能够成为同步原语的基础:CSR 写是一个控制流节点,不可与普通指令随意混排 ⚛️。
矩阵引擎的 msetmtype、msettn、msettm、msettk 以及启动与状态查询,
均依赖该独占性保证配置的原子性。
⚙️ 五、MLU:单实例三阶段流水
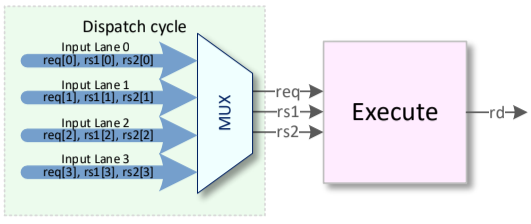
图 5:MLU 接口
MLU 接口简洁:
- • 输入来自派发单元或寄存器文件:
req.valid、req.op、req.addr、rs1.data、rs2.data 📥。 - • 输出写回寄存器文件:
rd.valid、rd.addr、rd.data 📤。 - • 四个 lane 均可发起请求,但 MLU 仅接受第一个有效请求,每周期最多一条 🎯。
MLU 执行 MUL、MULH、MULHSU、MULHU,为三阶段流水:
- 1. Dispatch:派发单元判断是否可执行。四个 lane 中,MLU 接受首个有效 MLU 指令,该请求在下一周期处理。
- 2. Compute:使用
rs1 与 rs2 的寄存器读数据执行乘法。
乘法延迟为 2 周期。该设计表明 CoralNPU 并不追求每个执行单元全并行,而是以
有限实例加派发约束换取面积与确定性的平衡 ⚖️。
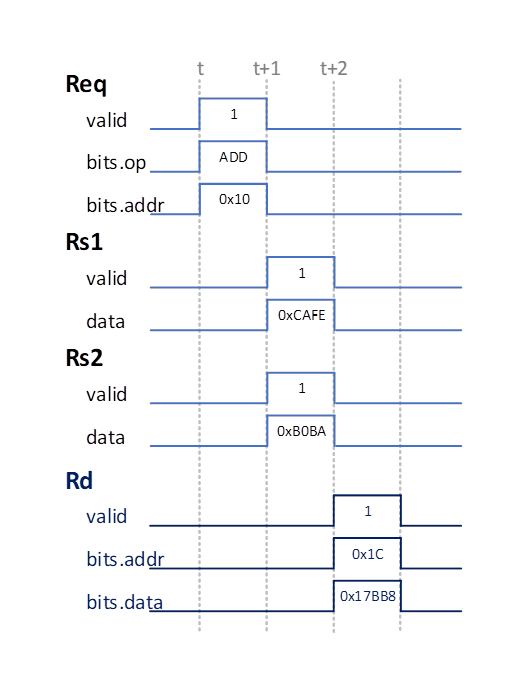
图 6:MLU 波形
波形图展示了典型的 ready-valid 握手:请求被接受后,下一周期进入计算,再下一周期写回结果。由于 MLU 为单实例,背靠背乘法会产生反压,后续指令必须等待 ⏳。
逐 tile 控制代码中的乘法、地址计算、循环计数会竞争 MLU。
编译器应尽量将可改写的乘法转换为加法或移位,
地址计算尽量采用基址加偏移、常量折叠与移位,
避免每次迭代执行乘法 ✂️。
🧮 六、MAC 与卷积:小单元、多循环的降级策略
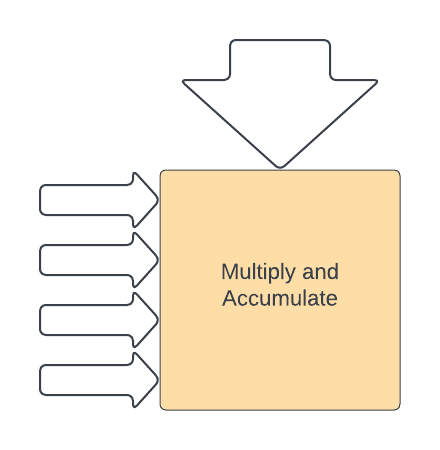
图 7:MAC 单元
MAC 单元是矩阵与卷积运算的基本节拍。CoralNPU 矩阵引擎以外积 MAC 为核心,典型配置 8×8、K=4,每周期执行 256 次乘加 💪。支持 INT8、FP32、BF16 等数据格式,累加器为 acc<8,8> 或 16 个 mt 寄存器 🧊。
MAC 单元本身规模有限,但吞吐较高。关键问题在于:如何以有限的 CSR 与指令驱动该单元完成复杂卷积?
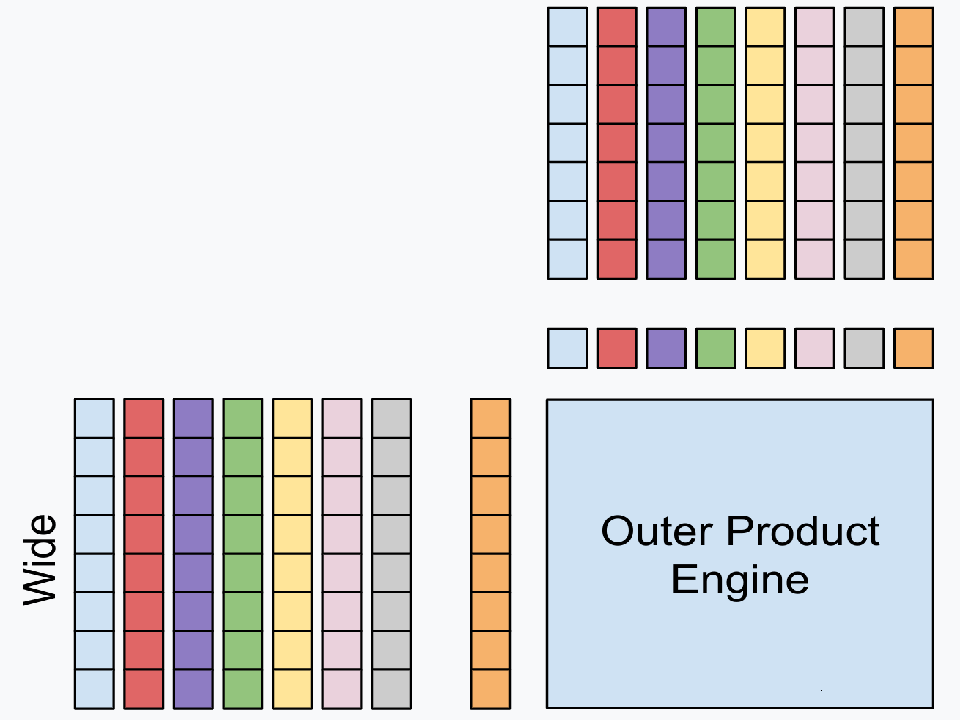
图 8:CoralNPU 卷积加速
卷积在 CoralNPU 上并非由单个大单元完成,而是被拆解为多个 8×8 外积节拍:
- • 权重与激活值存放于 TCM,不占用 CSR。CSR 仅负责告知硬件从哪个 TCM 地址读取数据 📦。
- • 卷积形状(KH、KW、通道深度)体现在标量核的循环控制流中,而非作为 CSR 参数存在 🔁。
- • 硬件仅负责单个 8×8 外积节拍,完整卷积由标量核反复触发节拍完成 🎯。
- • 静态字段(数据类型、运算模式、累加器初始化)在进入逐 tile 循环前一次性配置,循环内不再重写 ⚙️。
参数规模体现为循环次数,而非寄存器位宽。
这是 CoralNPU 能以少量 32 位 CSR 驱动复杂卷积的关键 🧩。
一个 3×3 卷积在生成的汇编代码中表现为执行若干次的循环;每次迭代,标量核计算新的 TCM 地址,写入 CSR,触发一次 8×8 MAC 🔄。
🚀 七、SIMD 与向量:解耦后端的指令消化机制
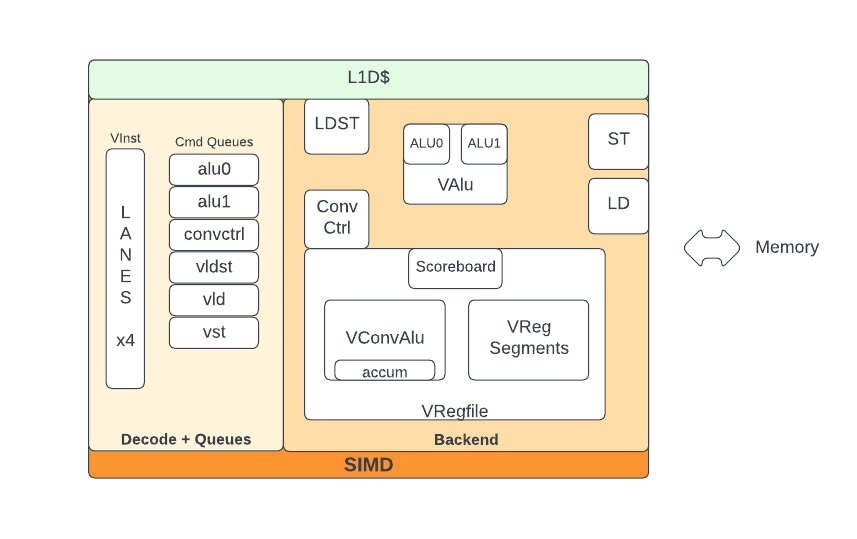
图 9:SIMD 执行
SIMD 图展示了向量后端的并行执行方式与流水线结构:
- • 8 项 Command Queue:标量核将向量命令放入 CQ 后即可继续执行后续标量指令,不必逐条等待 📥。
- • 2 级向量解码器(DE1/DE2):将向量指令展开为微操作 🔧。
- • 16 项 Uop Queue:微操作在此等待分发。
- • 专用保留站与多 lane 执行单元:按 RAW/WAW 重命名后,微操作进入专用保留站,再驱动 2×VALU、2×VMUL/MAC、1×VDIV、2×VFALU、1×VFDIV、1×Permutation/Reduction 🧮。
- • 16 项向量 ROB:保证精确异常、顺序退休与异步写回标量/浮点寄存器文件 🛡️。
关键对比:前端窄而顺序,后端宽而乱序。
解耦使标量核不必等待向量完成,
但 ROB 的退休仍然顺序,异常仍然精确 ⚖️。
向量后端执行单元配置对应不同向量负载:
- • 2×VALU 处理逻辑、算术、移位、mask、
viota.m/vid.v。 - • 2×VMUL/MAC 处理整数乘法、融合乘加、定点舍入
vxrm 与饱和 vxsat。 - • 2×VFALU 与 1×VFDIV 处理 FP32 与 BF16 向量数学 🌊。
- • 1×Permutation/Reduction 处理 gather/scatter 寄存器 slide、compress、整数归约与浮点归约。
LSU 对向量内存访问的支持覆盖 unit-stride、strided、ordered/unordered indexed、mask 与 fault-only-first。Normal 模式合并同一 16 字节行的访问;Strict 模式仅用于 ordered indexed 与受限 zero-stride,强制元素顺序以满足 RVV 规范 📐。
🌐 八、AXI 与外部互连
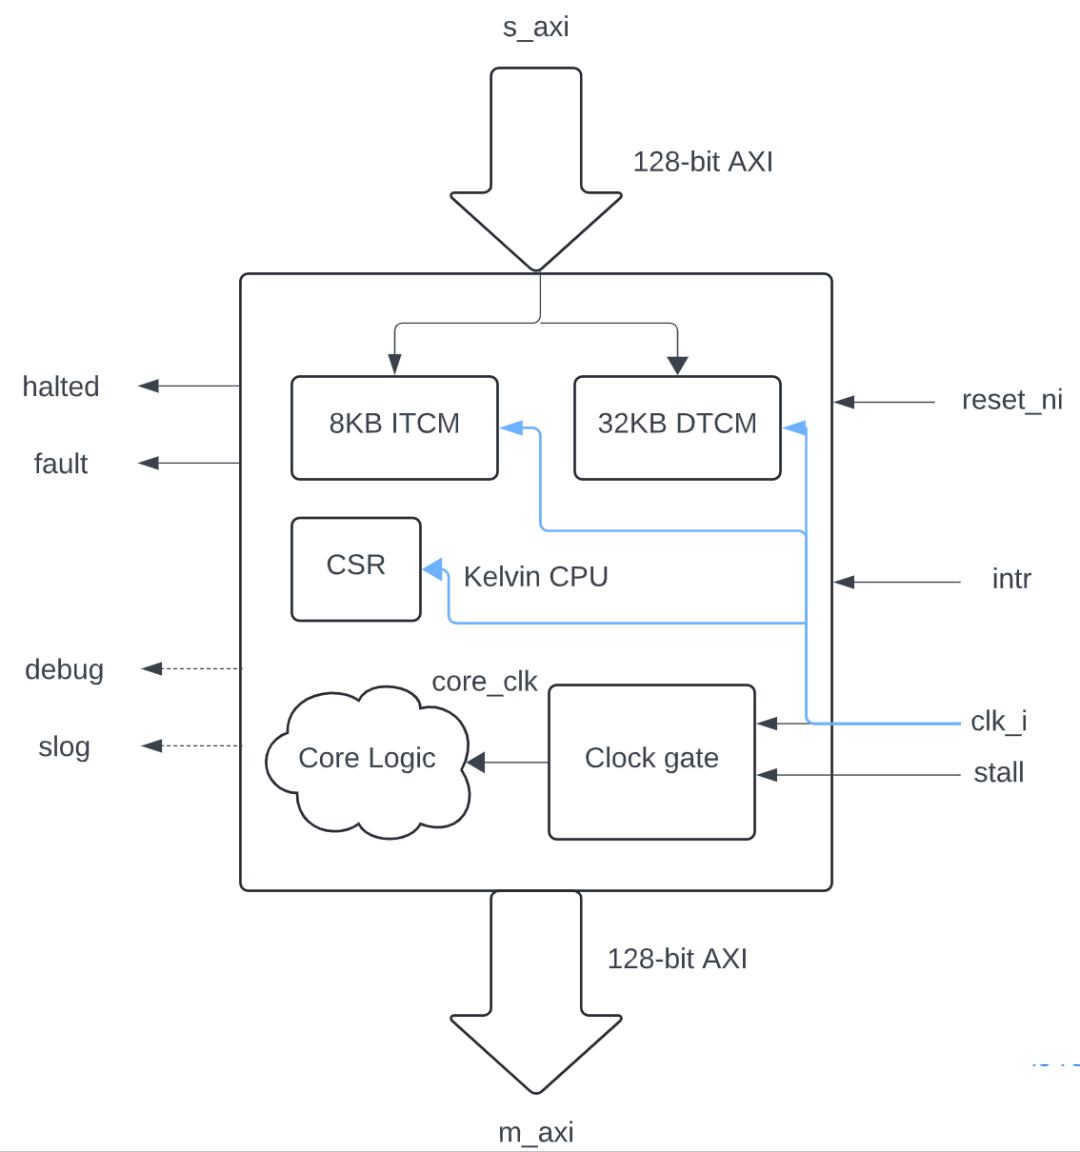
图 10:CoralNPU AXI 总线接口
AXI 图展示了外部互连方式:
- • AXI4 master(128-bit):LSU 用于外部内存事务,取指在 PC 超出 ITCM 时作为回退。连接 DDR、SRAM 与内存映射外设 🌐。
- • AXI4 slave(128-bit):允许 host 或系统 DMA 直接读写 ITCM、DTCM 与核心 CSR。这是外部主机编程与监控 CoralNPU 的入口 🚪。
- • TileLink-UL 变体:用于 OpenTitan 与 TileLink 风格 SoC fabric,提供
CoreTlul/CoralNPUChiselSubsystem 等变体 🔗。
默认内存映射如下:
| | | |
|---|
| ITCM | 0x0000_0000 | | |
| DTCM | 0x0001_0000 | | |
| CSR / 外设 | 0x0003_0000 | | |
| 外部内存 | | | |
Highmem 配置可扩展至 ITCM 最多 1 MB、DTCM 最多 1 MB、CSR 位于 0x0020_0000 🗺️。
该内存映射的设计意图明确:
TCM 是低延迟、确定性的 scratchpad,
外部总线是容量扩展与主机交互的通道。
编译器在布局时将热点数据与权重置于 TCM,大块外部数据交由 AXI/DMA 处理 🎯。
🏦 九、LSU 与 banked 内存
LSU 的定位是标量、浮点、向量、矩阵/tile 内存操作的统一出口 🚪。向量 load/store 经过 LSU,mload/mstore 亦经过 LSU,标量与浮点访问同样如此。
LSU 为解耦的顺序执行流水线:
- • 每周期解码最多
p.instructionLanes 条 LsuCmd,从寄存器文件读取基地址与 store 数据 📥。 - • 微操作存入
CircularBufferMulti,由 LsuSuperSlot 一次出队一条执行 🔄。 - • 执行被划分至字节级
LsuCell 数组(启用 RVV 时为
8 × VLENB,仅标量时为 4 字节)🧱。 - • 每个 cell 保存状态、8 位数据、16 字节行地址与一热掩码。
- • 总线事务对齐至 16 字节行,Normal 模式合并同一行地址的访问,Strict 模式保持元素顺序 📐。
代价是:每周期仅一条内存指令可派发 🚦。编译器必须尽量合并访问、采用连续或 unit-stride 模式 📦。
内存侧为 banked TCM 🏦:
- • ITCM 与 DTCM 均为 4 个 32-bit bank。
- • 默认配置 8 KB ITCM / 32 KB DTCM,Highmem 可扩展至 1 MB / 1 MB(或 512 KB / 512 KB)。
- • DTCM 配备本地交叉开关
BankedDtcm.scala,支持标量 LSU、向量内存单元、矩阵引擎与外部 DMA/host 端口的并发访问而不产生 bank 冲突 🔀。
这是向量与矩阵能够同时从 DTCM 取数的物理基础。
若缺少 banked 结构,向量与矩阵的并发访问将相互阻塞;
banked 结构将不同端口的访问分散至不同 bank,降低结构性阻塞 🧱。
📦 十、DMA Engine:粗粒度并行搬运
DMA Engine 在 CoralNPU 中定位明确:将批量数据搬运从标量核的派发路径上卸载 🚚。其规格为单通道、链表描述符、单 outstanding 事务、v1 无中断、CPU 轮询 STATUS。这些约束与 CoralNPU 整体设计哲学一致 🎯。
若无 DMA,所有内存传输——从 SRAM/DDR 加载权重至 TCM、流式传输外设数据——均须由标量核执行。标量核内存派发口每周期仅接受一条内存指令,逐字节搬运权重将完全占用 LSU,导致矩阵与向量引擎空等 ⏳。
DMA Engine 寄存器共五个:CTRL、STATUS、DESC_ADDR、CUR_DESC、XFER_REMAIN。编程序列如下:
- 3. 写
CTRL(enable=1, start=1)。
描述符为 32 字节、32 字节对齐,包含源/目的地址、长度、beat 大小、src_fixed/dst_fixed/
poll_en 标志、next_desc 链指针,以及 poll_addr/poll_mask/poll_value 轮询三元组。next_desc 为 0 表示链结束。一次编程后,DMA 自动遍历整条链 🔗。
外设流控设计体现了 CoralNPU 的设计哲学:
SPI/I2C 等外设并不感知 DMA 存在,亦不为 DMA 修改。
DMA 在每次数据 beat 前读取 poll_addr,
等待 (read_data & poll_mask) == poll_value 成立后继续。
流控逻辑置于描述符内,而非外设或专用 DMA 通道内 🎛️。
DMA 与计算引擎的并行是粗粒度的。CPU 编程 DMA 后,DMA 在 Host 端口上自行搬运,CPU 可同时配置矩阵、发射向量指令。两条异步流水线通过标量核的轮询循环在粗粒度上汇合 🎯。
🔐 十一、同步模型:配置在标量核,完成靠轮询
综合上述分析,CoralNPU 的同步模型可归纳为三条 📜。
第一,启动方式不同,但均由标量核发起 🚀:
- • 向量:指令入队 CQ,后端异步消费,标量核不必逐条等待。
- • 矩阵:
mset* 指令/CSR 配置加启动,PE 阵列异步执行。 - • 两种后端均不需要标量核逐周期托管,但启动动作均来自标量核的指令流 🎯。
第二,完成状态依赖软件轮询,不依赖硬件自动跟踪 🔄:
- • Scoreboard 跟踪寄存器层面的 RAW/WAW,不跟踪“矩阵 PE 阵列何时完成”这类跨引擎状态。
- • 向量 ROB 保证向量退休顺序,但不保证“矩阵结果何时可被向量读取”。
- • 逐 tile 的正确序列为:配置矩阵 → 启动 → 轮询矩阵状态/完成位 → 发射向量 load 🎯。
第三,普通 FENCE 不承担数据同步职责 🚧:
- • 普通 FENCE 在派发时被识别为 NOP,立即退休。
- • FENCE.I 用于取指同步与排空在途 store,不是数据同步工具。
- • 不应以普通 FENCE 等待矩阵完成,完成判断只能来自状态轮询 ⚠️。
为何不采用中断?
CoralNPU 标量前端被设计为
不需要频繁中断的执行器。
irqn 与 halted/fault 信号存在,
但设计用途为粗粒度事件——整个内核完成、发生故障、外部主机需要干预——
而非 tile 级别的细粒度握手。
在逐 tile 粒度上,中断上下文切换开销很可能超过轮询数个周期状态位的开销。
轮询并非低级方案,而是与该架构 run-to-completion 哲学一致的务实选择 🎯。
🧰 十二、编译栈与编程模型
CoralNPU 编译栈基于 MLIR/IREE 🛠️。多框架模型(PyTorch/JAX/LiteRT)经 StableHLO 或 TOSA 进入,经过常量折叠、死代码消除、缓冲区复用、循环分块与算子融合,随后分区为标量、RVV 向量与 VME 矩阵指令。不支持的算子自动回退至 host CPU 🔄。
社区 CIRCT RFC 中的 CoralNPU Dialect 展示了更底层的目标:TOSA 被降至 coralnpu.vle32、coralnpu.vmul、coralnpu.outer_product 等操作,矩阵操作最终映射为 KISA/KSCM 的 CSR 序列 📐。
然而,编译器生成的指令骨架中,
矩阵 CSR 配置与向量指令之间并不自动包含
“轮询 → 确认 → 发射”的跨引擎握手序列。
MLIR 的 SSA 依赖可表达逻辑结果依赖,
但无法从 SSA 图自动推导目标硬件所需的完成状态轮询。
该序列要么由 runtime 显式构造,要么由手写汇编保证 ⚠️。
编译器负责生成正确的指令流骨架,跨引擎就绪判断的最后一公里仍需软件层面的显式锚点。 该锚点不在 SSA 图内,而在标量核发出的轮询循环与 CSR 写的独占派发中 🎯。
在逐 tile 流水中,软件(编译器或 runtime)需负责:
- • 循环外配置静态字段(数据类型、运算模式、矩阵 M/N/K)。
- • 每次迭代计算当前 tile 的 TCM 地址,写入地址 CSR。
- • 推进标量寄存器中的地址指针,进入下一次迭代 🔄。
TCM 的静态分区(4 KB 槽位) 使地址在编译时确定,
运行时仅按迭代使用对应常量地址。
这减轻了运行时地址管理负担,
但同时排除了动态形状 📐。
🚧 十三、边界与适用场景
✅ 适用负载:
- • 静态形状、配置可静态化、计算靠循环摊薄的场景。
- • MobileNet 风格卷积、紧凑生成模型、始终在线的视觉/音频推理 🧠。
- • CoreMini 用于控制面,RvvCoreMini 用于 SIMD DSP/视觉/音频,VmeCoreMini 用于 CNN/GEMM/attention 🎯。
- • AI 眼镜、智能戒指等对功耗高度敏感的设备 👓💍。
❌ 不适用负载:
- • 每 tile 需要
海量动态配置的算法:CSR 与
mset* 的独占派发开销将成为瓶颈 🚦。 - • 动态形状:TCM 静态布局与矩阵 M/N/K 配置不擅长运行时变化 📐。
- • 需要低延迟中断驱动细粒度同步的场景:当前模型以轮询为主 🔄。
- • 需要多通道高并发 DMA 的高吞吐流:DMA 实现为单通道链表描述符、单 outstanding 事务 🚧。
- • 需要复杂缓存一致性协议的负载:CoralNPU 使用 TCM 而非硬件 Cache,无 Cache Miss 处理逻辑 🧱。
上述限制并非实现缺陷,
而是“以静态性与确定性换取能效”的前提被打破后的必然结果。 🎯
CoralNPU 的取舍明确:不追求通用处理器的动态适应能力,而将静态性、确定性与低功耗置于首位。对于边缘推理,该取舍通常正确;对于需要动态调度与复杂内存一致性的负载,则并非合适选择 ⚖️。
🏁 十四、结语
CoralNPU 的核心设计选择可归纳为一句:
让标量前端保持窄而确定,
让向量与矩阵后端保持宽而异步,
以 CSR 写、状态轮询与集中式 LSU
将二者粘合为一条正确的流水线。 🛣️
三个变体共享同一套 4-lane 顺序前端与同一套同步模型,仅在后端逐级叠加 RVV 与 VME 能力 🧱。其性能来自后端的乱序执行与 PE 阵列密度;其正确性来自标量核的显式配置与轮询,以及 LSU 的集中排序 🔐。
从架构图至微架构图,从 MLU 波形至 SIMD 流水,从 AXI 互连至 banked TCM,每张图均指向同一设计哲学:以静态性承担复杂性,以标量核的“窄”换取后端的“宽”,以轮询与 CSR 独占派发换取确定性 🎯。
理解这一点,比记住 VLEN=128 或 16 个 mt 寄存器更为重要。
📄 十五、License
CoralNPU 的软件与 RTL 以 Apache License 2.0 发布 📜。
- • 免版税:使用 Coral NPU 架构或软件,无需向 Google 支付许可费或权利金 💰。
- • 商业可用:任何公司或开发者均可基于 Coral NPU 构建与销售商业产品 🏢。
- • 第三方 IP 例外:若 SoC 厂商将 Coral NPU 与其他专有授权组件(例如特定 CPU 核或内存 fabric)集成,该第三方组件仍受其各自许可条款约束 ⚠️。
核心 IP 本身为 Apache 2.0、免版税、可商用;
需单独付费的是所集成的第三方组件。 🎯



