各位好啊,我是开源君!
找工作的时候,你是不是也这样:招聘页开了一排,简历改了好几个版本,投递状态还得另外记进表格。忙到最后才发现,有的岗位已经关了,有的硬性条件根本不匹配。
收到面试通知后,又得重新翻资料:这家公司招什么人?我当时投的是哪份简历?最近看到的 Career Ops,就想把这套来回折腾的流程接起来。
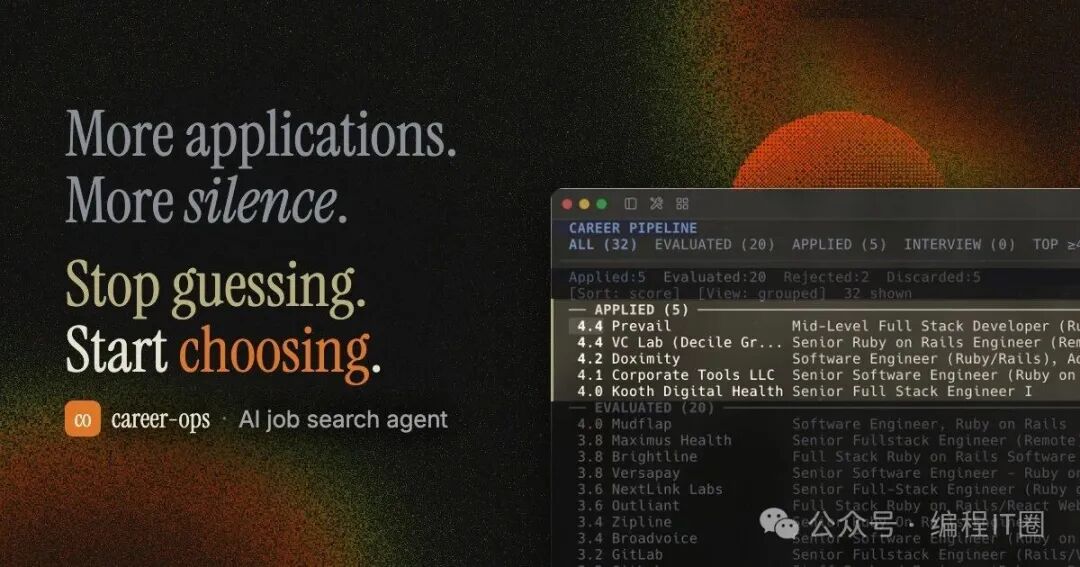 Career Ops · 项目展示
项目简介
Career Ops 是一个采用 MIT 许可的开源 AI 求职助手,主要在你自己的电脑里,配合 Claude Code、OpenCode 等 AI 命令行工具使用。
你提供真实简历、求职目标,再贴一个职位链接或职位描述,它就能围绕这份岗位做评估、准备申请材料,并记录进度。截至写稿时,项目已有 7.4 万+ Star。
工具本身免费,简历和记录保存在本地文件里;使用云模型时,相关内容仍会发给你选择的 AI 服务,模型费用另计。也能接本地模型,但需要自己配置。
先看看值不值得投,再花时间改简历
有些岗位,标题看起来挺合适,细看要求却差得有点远。它会先尝试检查职位是否仍开放,再把岗位要求和你的经历放到一起比较。
报告里会整理工作内容、匹配点、短板、级别等信息,并给出 1—5 分的评估。遇到匹配较弱的职位,会建议跳过,你也可以保留自己的判断。这个分数用于排优先级,别把它当成录取概率。
目标城市、是否接受远程、哪些条件不能让步,最好先说清楚。它一开始并不了解你,偏好没交代完整,评估再整齐,也可能在替你筛一份自己不想要的工作。
它还可以扫描已适配的招聘渠道和公司招聘页,比如 Greenhouse、Ashby、Lever。具体能查到什么,取决于渠道适配和筛选配置;手头已有岗位说明,直接粘贴文字也能开始。
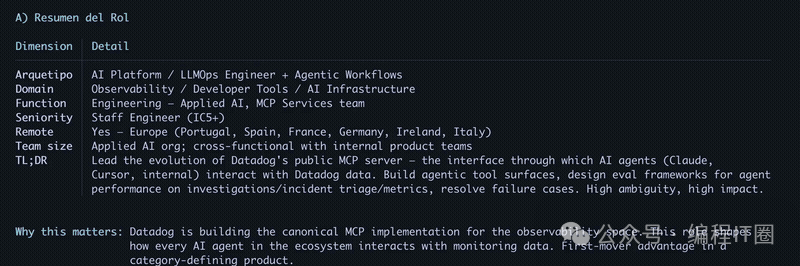 职位评估报告中的岗位摘要(演示示例)
简历按岗位整理,少做一遍重复劳动
同一段经历,投不同岗位时,重点常常不一样。工程岗位关心你怎么落地,管理岗位可能更想看协作和推进。每次从头改,很容易把自己绕晕。
它会根据职位描述,重新组织你已有的经历,生成针对性的简历、求职信和申请问题答案。PDF 也有适合招聘管理系统读取的版本,方便你接着投递。
生成流程里有事实检查,用来拦截部分没有依据的数字和表述,但还不能判断所有改写。发出去之前,简历里的经历、数字和措辞,仍要自己逐项过一遍。
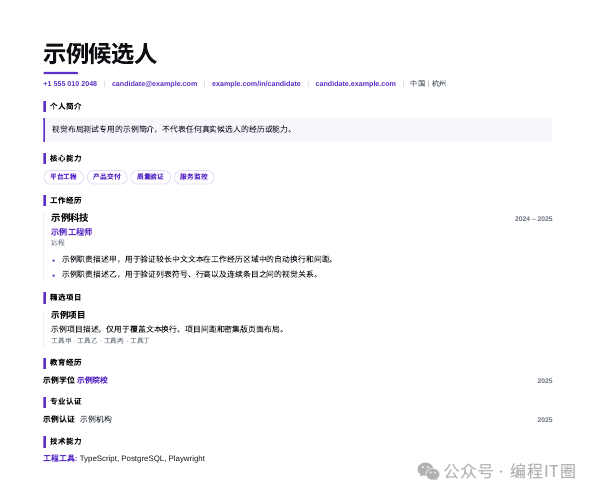 中文简历模板示例 · 内容为虚构测试资料
面试前,把经历整理成讲得清的故事
项目做过不少,一被问“你遇到过最大的挑战是什么”,却突然不知道从哪儿讲。这种时候,多背几道面试题,未必能解决表达混乱。
Career Ops 可以结合岗位、简历和面试时间,安排准备计划,并把真实经历整理成故事库:当时什么情况、你负责什么、做了什么、结果如何,再补上反思。
模拟练习会一次问一道题,再给结构化反馈。练完还可以做复盘,把答得不完整的地方留下来,下次继续补,省得每轮面试都从零整理。
投到哪一步了,放在一起看
今天投三家,明天约两场,过一周就容易记混。它会把岗位、评分、材料和申请状态串在同一套记录里,也能汇总投递漏斗,回头看哪些环节卡得最多。
终端看板支持筛选、排序和查看报告。想用浏览器,也有可选的 Web 界面,不过目前仍是 alpha 阶段。
对于支持的申请表单,它能协助准备答案或预填内容,最终提交由你操作。联系人消息、申请邮件也是先给草稿,方便你核对后再发。
比如“为什么想来这家公司”“讲一个相关项目”,可以先让它起草,再改成自己的表达。表单里遇到验证码或未适配的字段,仍需要手动处理。
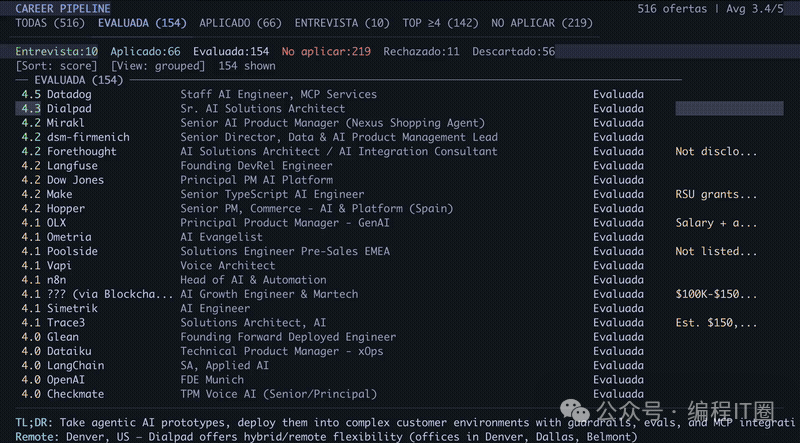 终端投递看板(西班牙语演示示例)
快速安装、使用
先准备 Git、符合项目要求的 Node.js(可用 24.x),以及一个已配置好的 AI 命令行工具。下面以 Claude Code 为例:
npx @santifer/career-ops init
cd career-ops
claude
首次启动后,按对话引导补充简历、目标岗位和个人偏好,再粘贴一个真实职位开始评估。生成 PDF 需要 Playwright 的 Chromium,若安装时未准备好,按文档补齐即可。
终端看板还需要 Go 环境,Web 界面则要单独启动。第一次使用,先跑通一个岗位,再考虑批量扫描,会更容易发现配置哪里需要调整。
核心记录采用 Markdown、YAML 等文本格式,后续也方便自己编辑、备份。跨设备没有内置的自动同步,需要你安排文件的保存和迁移。
career-ops 值不值得用 ?
这个项目的价值是把查岗位、改材料、练表达和记进度接在一起,让你少在几个窗口之间搬资料,把精力留给真正需要判断的部分。
如果你正在认真找工作,又已经会用 AI 命令行工具,可以先拿一个目标岗位试试。看看它指出的差距、整理的经历,到底有没有帮你把这次申请准备得更清楚。
项目地址https://github.com/career-ops-hq/career-ops



