本文为 AI 研习社编译的技术博客,原标题 Top 10 Pretrained Models to get you Started with Deep Learning (Part 1 – Computer Vision),作者为 PRANAV DAR。
翻译 | 杨东旭 白开水 机智的工人 Lamaric
校对 | Lamaric
介绍
对于那些想学习算法或者尝试现有框架的人来说,使用预训练模型能够提供很好的帮助。因为时间与计算量方面的诸多限制,不可能随时从头开始训练一个模型,这也正是预训练模型存在的原因。你可以运用预训练作为基准来改进现有模型,或者根据它测试自己的模型。因此,预训练模型的潜能是巨大的。
 来源:Facebook AI
本文旨在研究具有Keras中具有计算机视觉应用的各种预训练模型。 为什么是 Keras?首先对于神经网络的初学者来说,是一个很容易上手的框架。其次,希望大家在文中只选择一个框架。这样可以使得大家不用在意框架方面的问题,而专注于模型。
然后,鼓励大家在自己的机器上尝试每个模型,试着理解模型的工作原理,以及熟悉如何改进或调整内部参数。
对于这一课题,我们将其分成一系列文章分别讲解。第二部分把关注主要放在NLP上,而第三部分我们主要考虑音频语音模型。这样,读者就可以通过这些领域中现有的解决方案迅速跟踪你们的学习过程。
内容列表
Mask R-CNN
YOLOv2
MobileNet
生/熟 西红柿分类
汽车分类
目标检测
目标检测是计算机视觉领域最常见的应用之一。它适用于各行各业,从自动驾驶汽车到计算人群中的人数。本节介绍可用于检测目标的预训练模型。您还可以查看以下文章以熟悉此主题:
使用 Python 来理解和从头建立目标检测模型(https://www.analyticsvidhya.com/blog/2018/06/understanding-building-object-detection-model-python/)
Mask R-CNN
https://github.com/matterport/Mask_RCNN
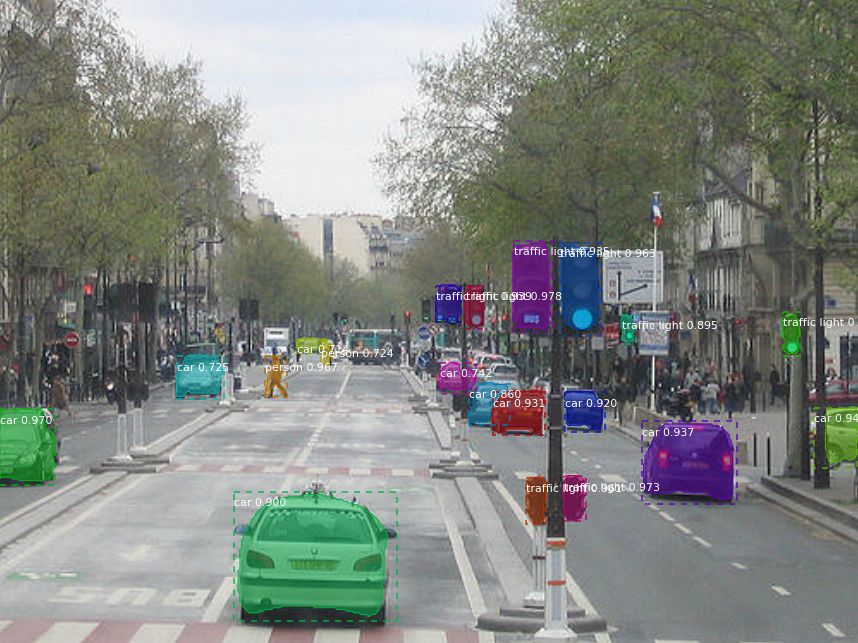
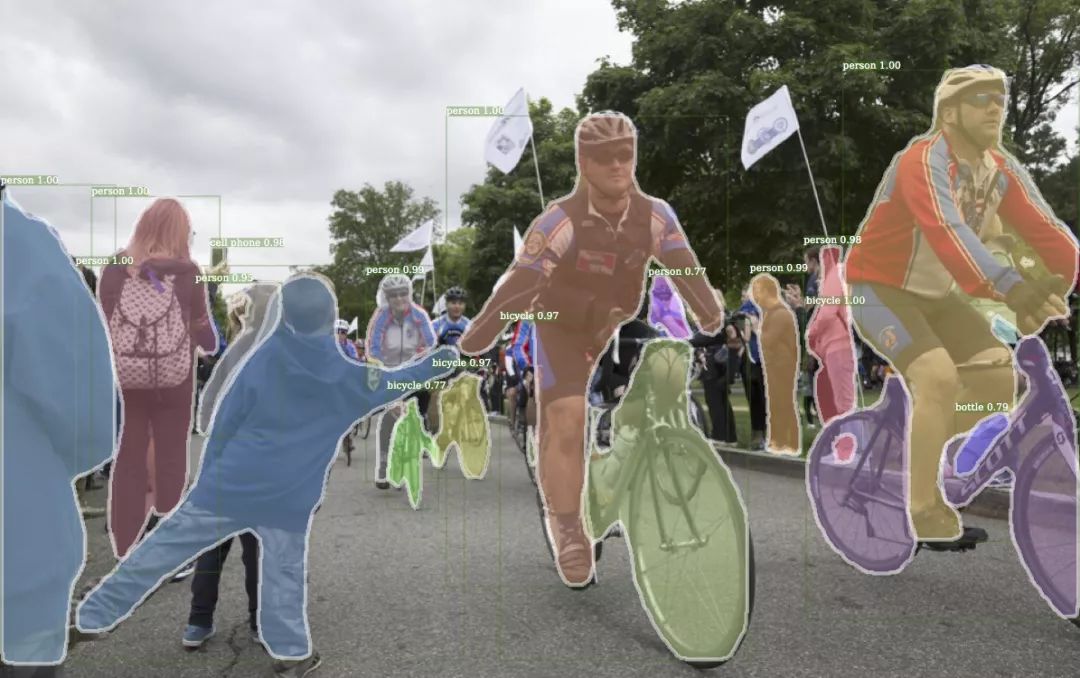
Mask R-CNN 是为目标实例分割而开发的灵活框架。这个预训练模型是使用 Python 和 Keras 对 Mask R-CNN 技术的实现。它为给定图像中的目标的每个实例生成边界框和分割掩模(如上所示)。
这个 GitHub 存储库提供了大量的资源来帮助新手入门。它包括 Mask R-CNN 的源代码,用于MS COCO 数据集的训练代码和预训练权重,Jupyter notebook 用于可视化检测流程的每个步骤。
YOLOv2
https://github.com/experiencor/keras-yolo2
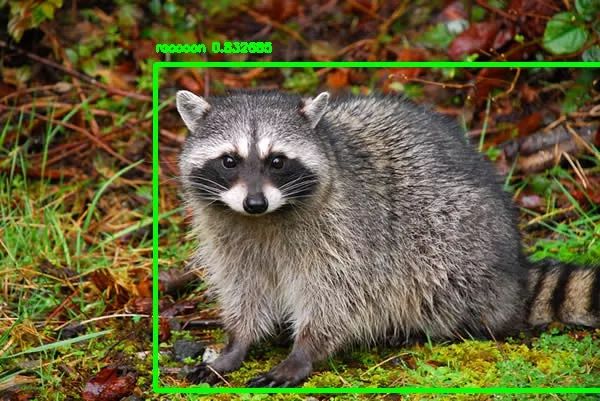
说到 YOLO,这是一个广泛运用于深度学习的目标检测框架,这个库包含Keras 中的YOLOv2 实现。尽管开发者已经在各种目标图像上测试了这一框架,比如袋鼠检测、自动驾驶汽车,红细胞检测等等,他们依然发布了浣熊检测的预训练模型。
这里你可以下载浣熊的数据集(https://github.com/experiencor/raccoon_dataset),并且开始训练这个预训练模型。这一数据集包含200个图片(160个训练集,40个测试集)。同样,你可以下载整个模型的预训练权重(https://1drv.ms/f/s!ApLdDEW3ut5feoZAEUwmSMYdPlY)。而根据模型开发者所说,这些权重可以用于一类物体的目标检测。
MobileNet
https://keras.io/applications/#mobilenet
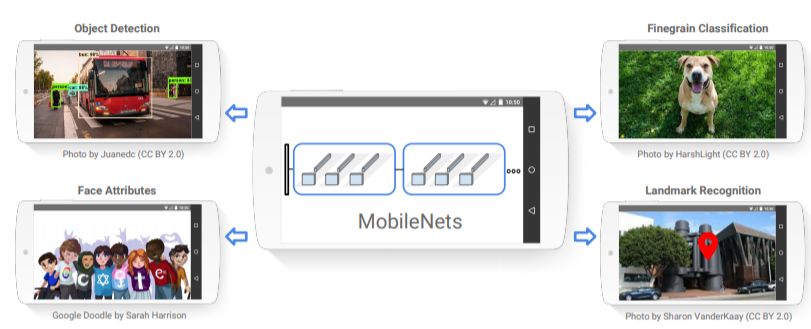
顾名思义,MobileNet是为移动设备设计的架构。而搭建它的正是移动设备行业龙头谷歌。而我们之前附上链接的模型,带有对流行的 ImageNet(包含两万个类的数百万张图片的巨型数据库) 数据集的预训练权重。
正如上文所提,MobileNet不止可以用于目标检测,同样它也适用于类似面部识别、地标识别、细致纹理分类等多种计算机视觉任务。
生熟番茄分类
https://github.com/fyrestorm-sdb/tomatoes
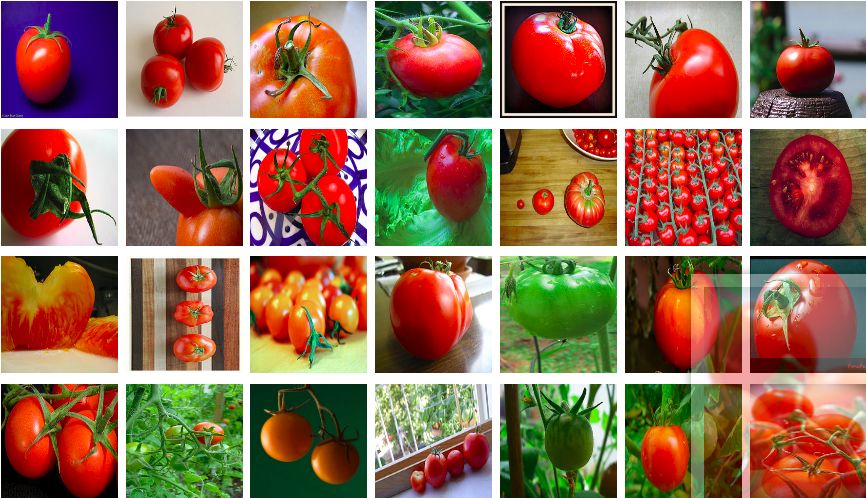
假定我们有几百个数据集的番茄图片,现在考虑如何如何区分它们,比方说按是否瑕疵,或者按成熟与否区分。这里我们考虑使用深度学习模型,而解决这个问题的关键技术就是图像处理。应对于这一分类问题,我们可以利用在Keras上预训练好的 VGG16模型来区分给定图片的番茄是生是熟。
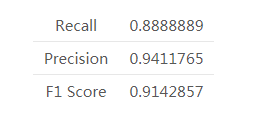
通过在ImageNet数据集上抓取的390张或生或熟的番茄图像进行训练,并在18张不同的验证集上进行测试。这些验证集图像上的总体结果如下所示:
汽车分类
https://github.com/michalgdak/car-recognition
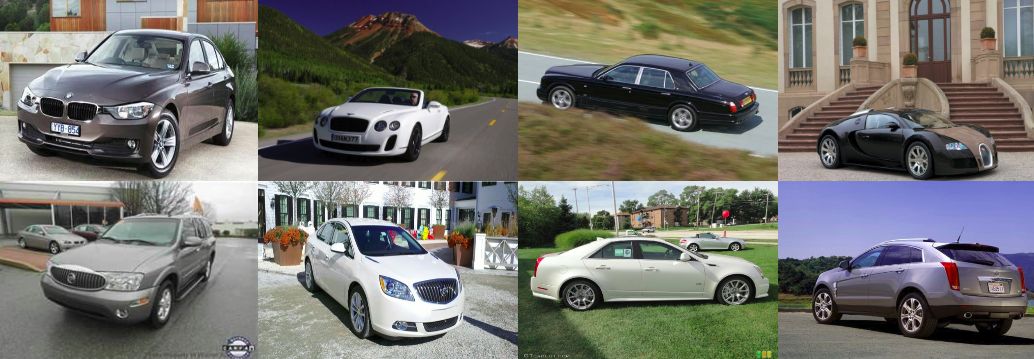
众所周知,对一辆车分门别类有很多方法:譬如车体设计风格、车门数量、是否敞篷、车座数量等等。对于这一问题,我们需要将车辆图片分门别类,比如考虑品牌、设计模式、年限等等的分类。2012年,Tesla Model S 使用了斯坦福大学的车辆数据集(其中包含196类汽车的16185张图片)正是为了开发这一模型(http://ai.stanford.edu/~jkrause/cars/car_dataset.html)。
Tesla Model S使用预训练过的VGG16、VGG19、InceptionV3模型进行训练。由于仅仅使用 3*3的卷积层增加深度,VGG这一简单特点为人所知,这里16和19分别代表两种VGG网络的层数。
由于数据量较少,最简单的模型——VGG16是最精确的。这一神经网络的训练,使得在交叉验证集上达到了66.11%的准确度。而由于偏差方差的问题,反而使得比较复杂的模型譬如InceptionV3得到的准确率较低。
人脸识别与重建
人脸识别在深度学习社区是非常流行的。越来越多的技术与模型以令人惊讶的速度发展着而被应用于人脸识别技术。它的应用范围同样也是很广泛的,包括但不限于手机解锁,人群检测,基于人脸的情感分析等等。
人脸重建从另一方面讲,是指由人脸特写图像到人脸三维建模图像的生成过程。从二维信息中创建三维结构化对象是工业界又一个十分关心的问题。人脸重建在电影及游戏产业的应用是十分广泛的。多种 CGI 模型已经能够实现自动化,因而在人脸生成过程中节省了大量的金钱与时间。
本文的这一部分将讨论用于这两个领域的预训练模型。
VGG-Face 模型
https://gist.github.com/EncodeTS/6bbe8cb8bebad7a672f0d872561782d9
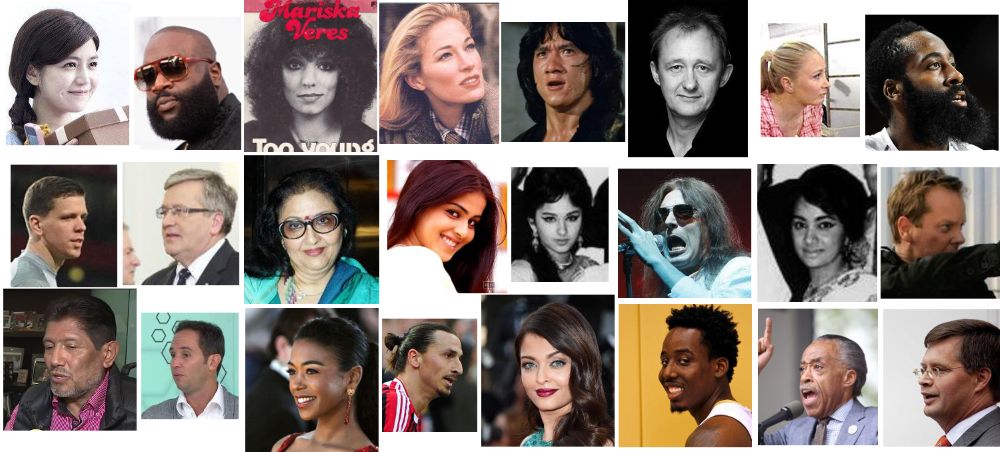
从头开始创建一个人脸识别模型其实是一个令人害怕的任务。为了最终构建出令人满意的模型,你需要去寻找搜集并且标注大量的图像。因此,在这个领域使用预训练模型是非常有道理的。
VGG-Face(http://www.robots.ox.ac.uk/~vgg/data/vgg_face/)是一个有超过2百万张人脸图像,包含2622个独立身份的数据集。预训练模型已经通过以下方法构建完成:
基于单图像的三维人脸重建
https://github.com/dezmoanded/vrn-torch-to-keras
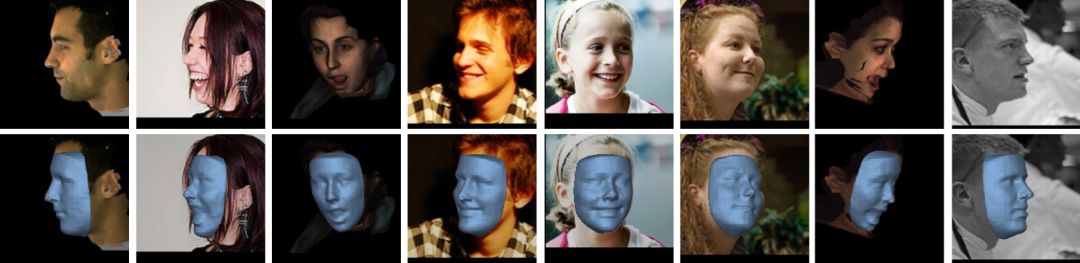
这是深度学习的一个非常炫酷的成就。从以上图像你可以推断出为了将脸部特征重建成三维空间模型是怎样工作的。这个预训练模型最初是用 Torch 实现的(https://github.com/AaronJackson/vrn),之后被转化成keras模型。
图像分割
语义图像分割 – Deeplabv3+
https://github.com/bonlime/keras-deeplab-v3-plus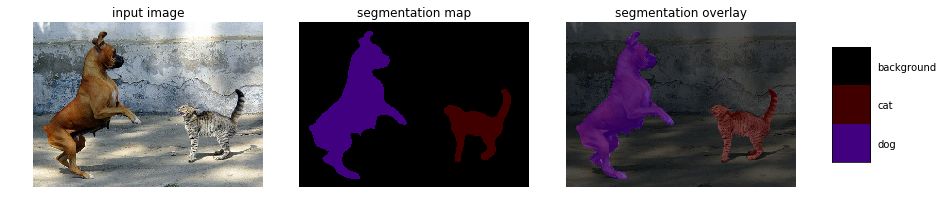
语义图像分割是指将语义标签分配给图像的每个像素的任务。这些语义标签可以是‘天空’,‘汽车’,‘道路’,‘长颈鹿’等等。这项技术所要做的就是找到对象的边界因而需要对精度要求做出约束(这也就是与图像层面的分类任务的区别所在,分类任务对精度的要求更加宽松)。
Deeplabv3 是Google最新的语义图像分割模型。 它最初是使用TensorFlow实现并且现在也已经通过keras实现了。这个GitHub仓库包含如何获取标签,如何使用自定义类别数的预训练模型的代码,当然也包含如何去追踪自己模型的代码。
机器手术分割
https://github.com/ternaus/robot-surgery-segmentation
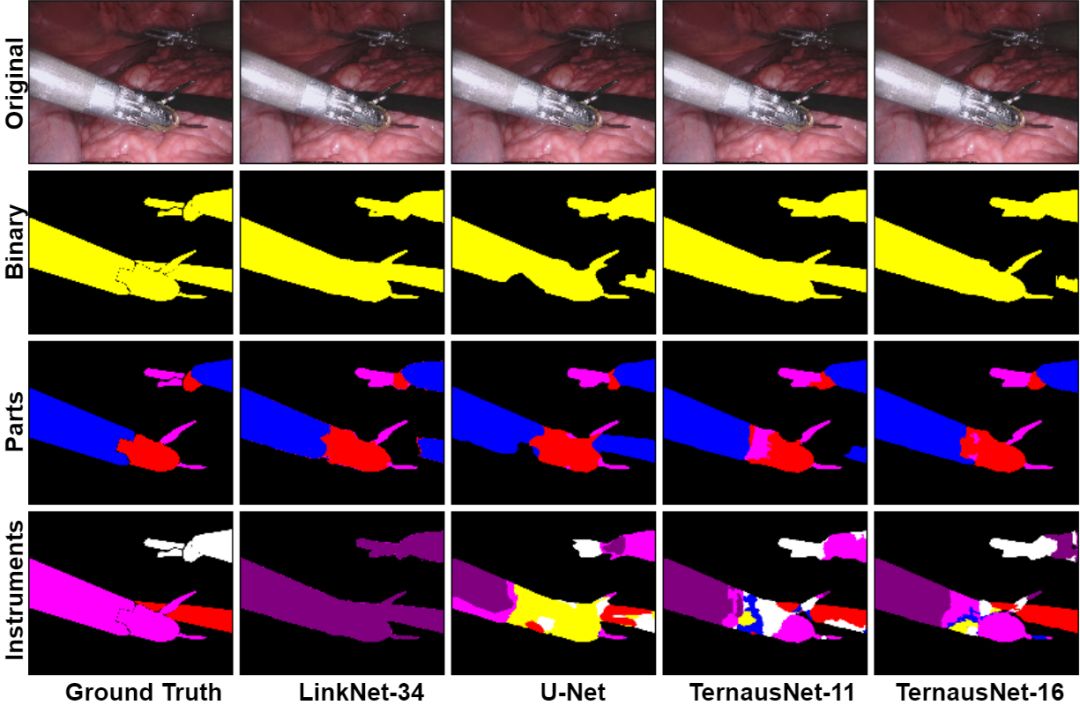
这一模型尝试定位确定在机器人辅助手术方案中的医疗器械图像分割的问题。该问题又被分成两个部分,如下文所说:
二值分割:图像中的每一个像素都会被标记成仪器或背景。
多类别分割:不同仪器以及同一仪器的不同部分将会与背景区分开来。
该预训练模型是以U-Net网络架构为基础,并且通过应用如LinkNet 和TernausNet等先进的神经网络又得到了性能的提升。模型是在高分辨率立体相机图像的8 × 225帧序列上训练得到的。
其他图像描述
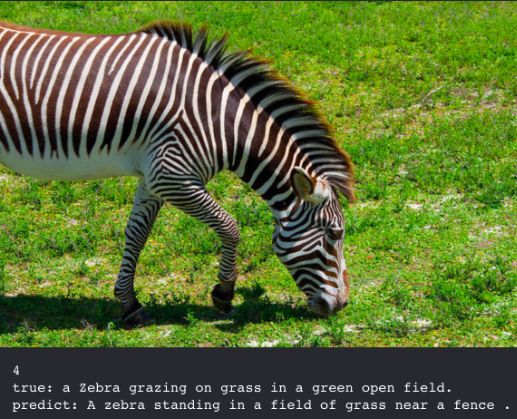
还记得那些给你照片并且让你对它做出描述的游戏吗?这基本上就是图像描述。它使用自然语言处理和计算机视觉的组合来生成描述结果。这项任务长期以来一直是一项具有挑战性的任务,因为它需要具有无偏见图像和场景的大型数据集。鉴于这些约束,该算法必须可以针对任何给定的图像都可行。
现在很多企业正在利用这种技术,但你怎么能去使用它呢?解决方案在于将给定的输入图像转换为简短且有意义的描述。编码器 - 解码器框架广泛用于此任务。图像编码器是卷积神经网络(CNN)。
这是基于 MS COCO 数据集(http://cocodataset.org/#download)上的 VGG 16 预训练模型,其中解码器是预测给定图像的描述的长短期记忆(LSTM)网络。有关的详细说明及介绍,建议您跟进我们关于自动图像描述的文章(https://www.analyticsvidhya.com/blog/2018/04/solving-an-image-captioning-task-using-deep-learning/)。
结尾小提示
深度学习是一个难以攻破的棘手领域,这就是为什么我们看到研究人员发布了如此多的预训练模型。亲自使用它们来理解和扩展我说的关于对象检测任务的知识,我强烈建议从上面选择一个领域并使用给定的模型来开始你们自己的旅程。
在下一篇文章中,我们将深入研究自然语言处理。如果您对本文和整个系列有任何的反馈或建议,请在下面的评论区告诉我们。
原文链接:
https://www.analyticsvidhya.com/blog/2018/07/top-10-pretrained-models-get-started-deep-learning-part-1-computer-vision/
点击文末【阅读原文】即可观看更多精彩内容:
教你只需连接电脑摄像头,就能用深度学习进行实时对象检测
手把手教你搭建能够实现 Prisma 风格迁移效果的 iOS 酷炫应用
教你在真实图像数据上应用线性滤波器
等你来译:
我是如何在 Python 内使用深度学习实现 Iphone X 的 FaceID的
用深度学习技术,让你的眼睛可以控制电脑
针对 3D 计算机视觉的简介