作者:黑黄条纹的野喵
简书专栏:https://www.jianshu.com/u/7cabd1cbad0d
喜欢看小说的骚年们都知道,总是有一些小说让人耳目一新,不管是仙侠还是玄幻,前面更了几十章就成功圈了一大波粉丝,成功攀上飙升榜,热门榜等各种榜,扔几个栗子出来:
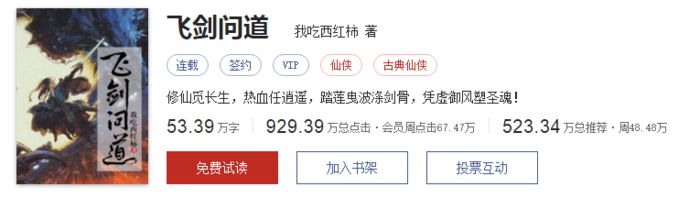
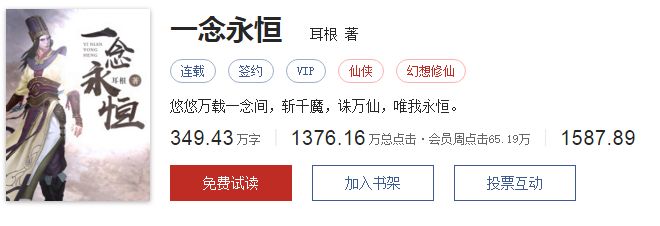
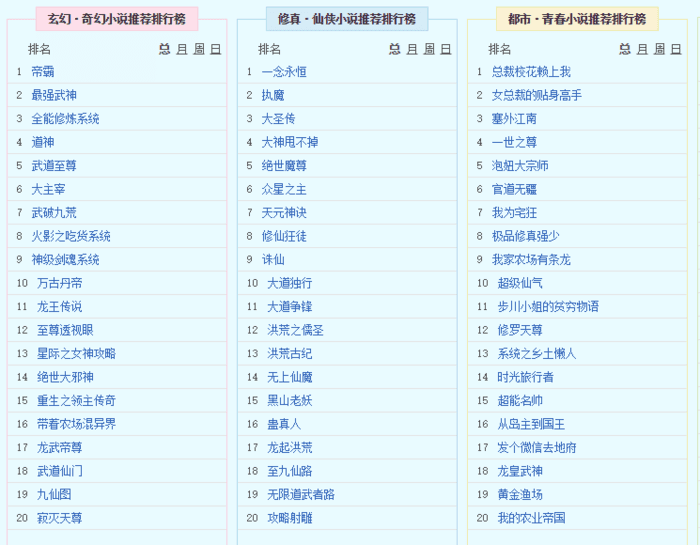
新笔趣阁是广大书友最值得收藏的网络小说阅读网,网站收录了当前......我就不打广告了(其他满足下文条件的网站也行,之前已经有做过简单爬取章节的先例了,但效果不太理想,有很多不需要的成分被留下了,来链接:http://python.jobbole.com/88560/。我们本文就爬取这个网站的上千本小说。重点在和大家一起分享一些爬虫的思路和一些很常遇到的坑。
本文的行文脉络:
1、先构造一个单本的小爬虫练练手;
2、简要分享一下安装MongoBD数据库时的几个易错问题;
3、运用Scrapy框架爬取新笔趣阁全站排行榜。
一、爬取单本小说
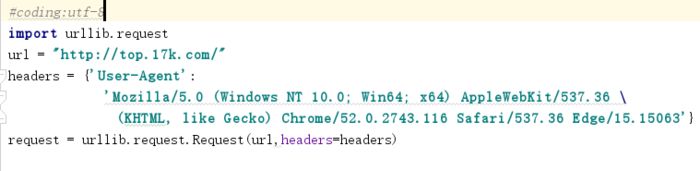
爬取该网站相对来讲还是很容易的,打开编辑器(推荐使用PyCharm,功能强大),首先引入模块urllib.request(Python2.x的引入urllib和urllib2即可,待会我把2.x的也写出来给大家看看),给出网站URL,写下请求,再添加请求头(虽然这个网站不封号,但作者建议还是要养成每次都写请求头的习惯,万一那天碰到像豆瓣似的网站,一不留神就把你封了)话不多说,直接上图:
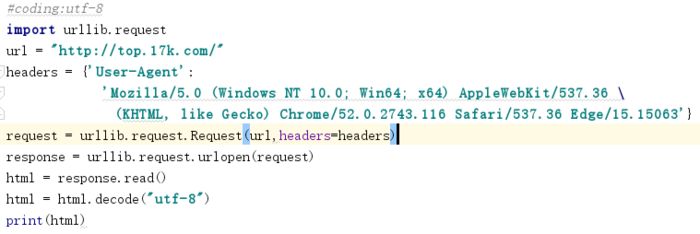
然后再将请求发送出去,定义变量response,用read()方法观察,注意将符号解码成utf-8的形式,省的乱码:
打印一下看结果:
看到这么一大条就对喽,对比一下网页源码,发现是一致的。
这步观察很重要,因为这就说明该网站没有使用AJAX异步加载,否则就要开始抓包的工作了,这个我们留着分析动态网站时候再说。建议大家在没有更好的方法时使用。之前记得确实有直接判断的方法,然而一不小心忘记了,有知道的读者还请发给我哦。
我们现在得到了网站的response,接下来就是对我们想要获取的数据进行解析、提取,但等等,考虑到我们要爬取大量小说,不搞一个数据库存储真是太失败了,作者推荐MongoDB数据库,属于NOSQL类型数据库,以文档存储为主,这里用来爬小说真是太适合不过了。但安装起来需要一定的程序,想要试着做做的骚年可以参考一下下载和安装教程,参考链接:http://blog.csdn.net/u011262253/article/details/74858211,在安装好后为方便启动,可以添加环境变量,但这里有个坑,你要先打开mongod(注意是mongodb,别一上来就打开mongo),然后需要准确添加dbpath路径,不然打开很容易就会失败,上图上图:
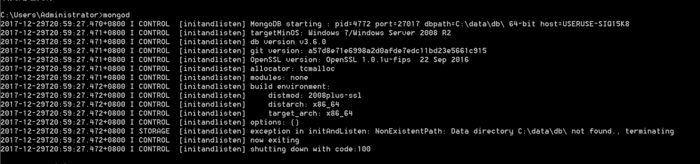
失败状态
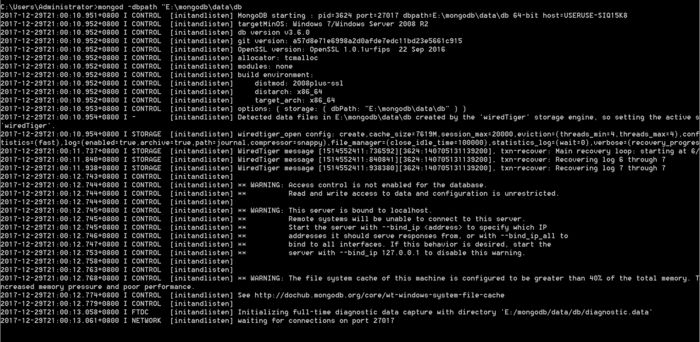
成功状态
添加路径后成功连接,出现waiting for connections on port 27017,则表示数据库连接成功,而后就不要关掉这个终端了,只有保持数据库是连接的,才可运行MongoDB数据库(不然报错你都不知道自己是怎么死的)
好了,连接好数据库后,我们将数据库与编辑器进行交互链接,位置很隐秘,在File>>Settings>>Plugins下添加组件Mongo Plugin,没有就下载一个:
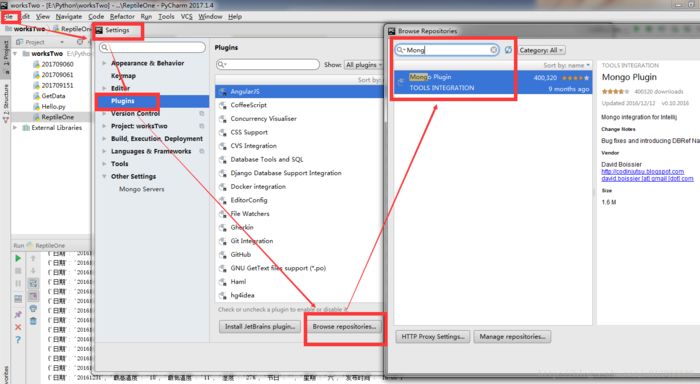
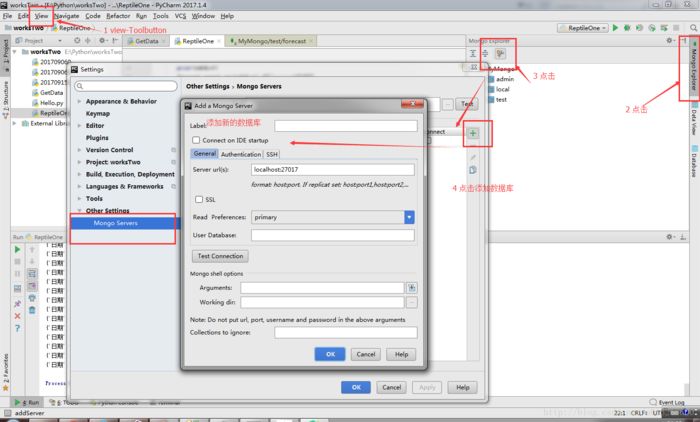
盗个图
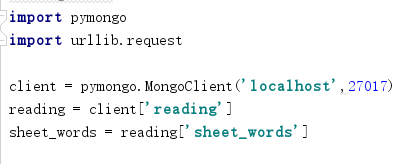
我们在编辑器内编写代码,引入Python专门用来与MongoDB交互的模块pymongo,然后在最上面链接MongoDB数据库的端口,默认是27017,我们先创建一个叫做reading的数据库,然后在reading内新建一个叫做sheet_words的数据表,代码如下:
我们先找一个叫做《修罗武神》的小说来练练手,个人来讲,我很讨厌看小说时来回的翻页,有时候还跳出广告,这时候我还得返回去重新翻页,作为一名懒得不行的懒人,我想到要是把整部小说放进一个文档里再看不就好了么,但要是一章一章的复制粘贴我想还是算了吧,这时候你就知道爬虫是有多么便捷了。好,现在我们要做的是把《修罗武神》这部小说完整的爬取下来,并在数据库中备份。我们回到刚才停留的地方,在得到response后,我们应该选用一种方法来解析网页,一般的方法有re,xpath,selector(css),建议新手使用xpath而不是re,一是因为re用不好很容易导致错误,“当你决定用正则表达式解决问题时,你有了两个问题。”,相比较xpath才是步骤明确,十分稳妥;二是在Firefox,Chrome等浏览器中可以直接复制xpath路径,大大的减少了我们的工作量,上图:
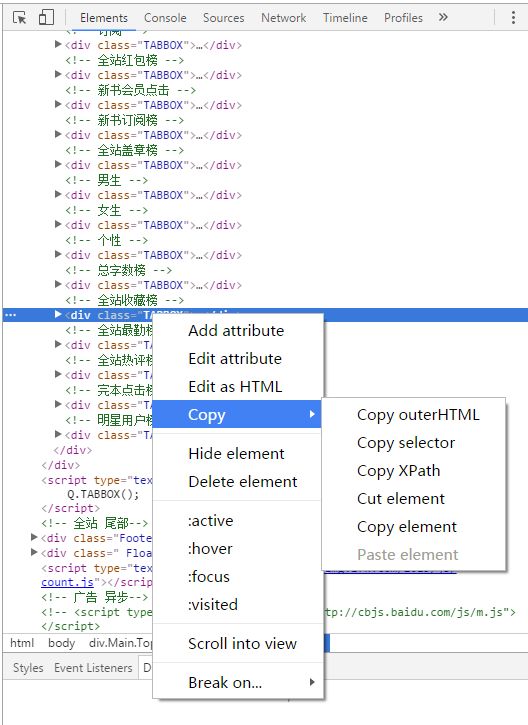
如果你决定使用xpath之后,我们需要从lxml中引入etree模块,然后就可以用etree中的HTML()方法来解析网页了,从网页>检察元素(F12)中复制下来我们所需数据的路径,我选择的是小说每章的标题和内容,上图,上图:
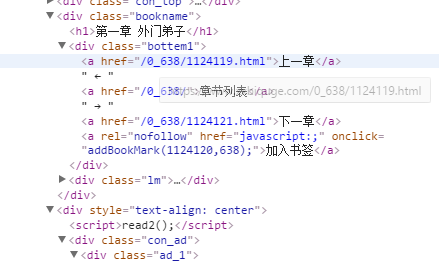
路径//div[@class="readAreaBox content"]/h1/text()
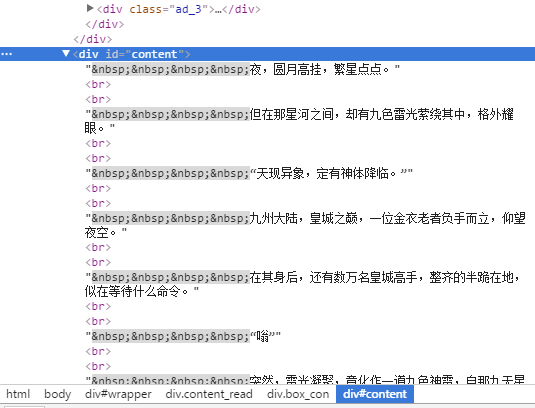
路径/html/body/div[4]/div[2]/div[2]/div[1]/div[2]/text()
注意注意,又来一个坑,当你复制xpath时得到的是这个东东:
//div[@class="readAreaBox content"]/h1
和这个东东;
/html/body/div[4]/div[2]/div[2]/div[1]/div[2]
但你需要的是这个路径里的文本text,故我们需要另外添加具体文本:/text(),然后就像上面那样啦。上代码,查数据:
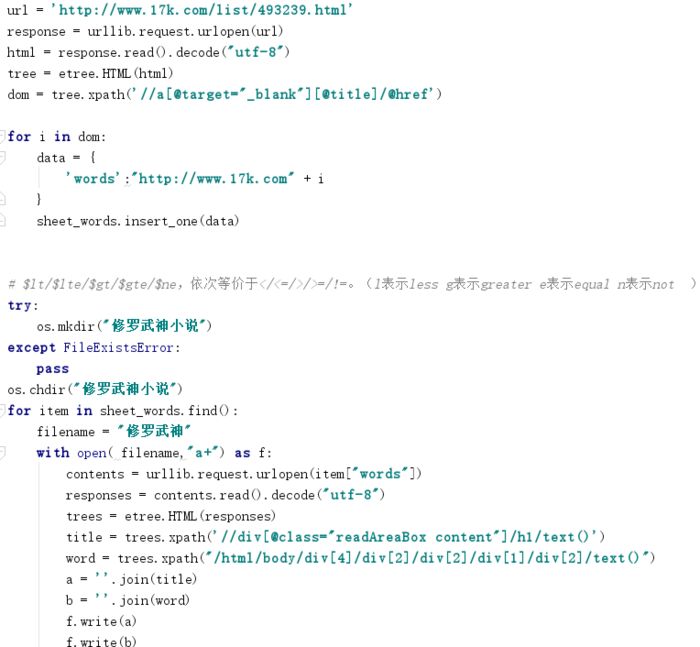
完整代码见百度网盘:
链接:https://pan.baidu.com/s/1jHYNF86密码:ho9d
小说有点大,一共是三千五百章,等个大约4-7分钟吧,打开文件夹《修罗武神小说》,就可以看到我们下载好的无需翻页的一整部小说,数据库内页备份好了每章的链接,它自动从零开始排的,就是说你要看第30章就得打开序号为29的链接,这个调一下下载时的顺序就好了,作者很懒,想要尝试下的读者可以自行更改。
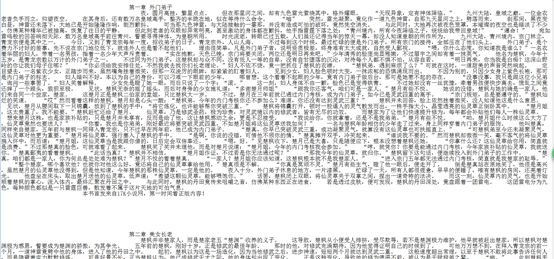
小说文本
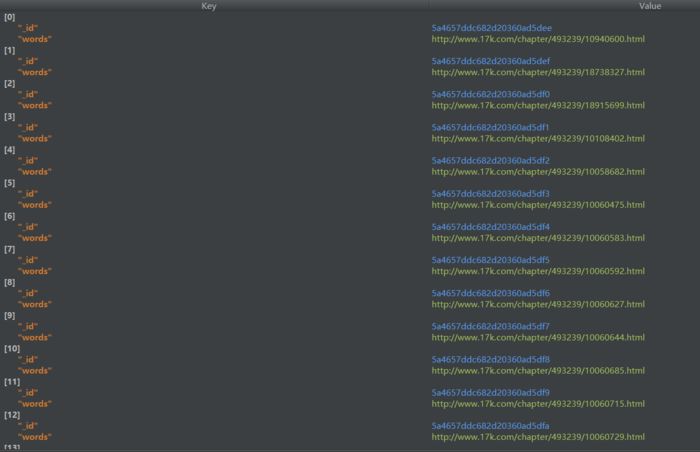
数据库连接
看看,感觉还不错吧,好的小例子讲完了,接下来我们准备进入正题。
我们要像上面的例子那样爬取整个网站,当然这里就不再建议使用普通的编辑器来来执行了,聪明的读者已经发现,一部小说爬了4分钟,那么上千本不说,单单是一组排行榜里的100本就够爬好一会了,这就显示出Scripy框架的作用,用专门的Scripy框架写工程类爬虫绝对快速省力,是居家写虫的必备良药哇。
二、爬取小说榜所有小说
首先安装Scrapy的所有组件,建议除pywin32以外都用pip安装,不会的话度娘吧,很简单的,pywin32需要下载与你所用Python版本相同的安装文件。
来连接:https://sourceforge.net/projects/pywin32/
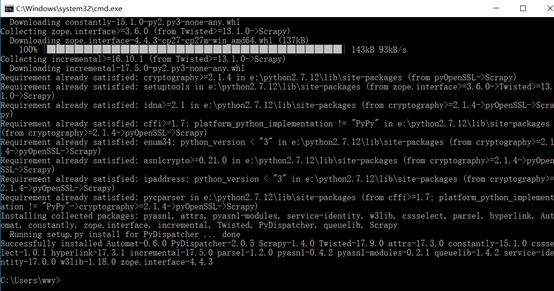
Scrapy插件安装成功
然后还是老规矩,不想每次终端运行都一点一点找路径的话,就将根目录添加到环境变量,然后打开终端,我们测试一下是否安装成功:
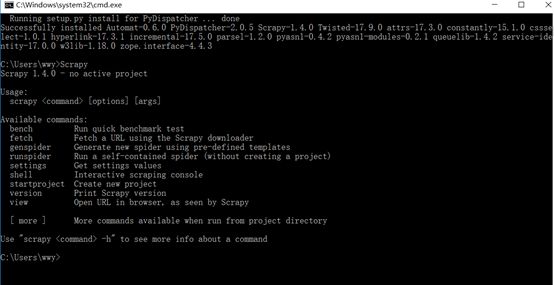
Scrapy安装成功
好,安装完毕后,打开终端,新建一个Scrapy工程,这里你可以根据索引,选择使用Scrapy的各种功能,这里不一一详解了,D盘内已经出现了我们建立好的Scrapy工程文件夹:
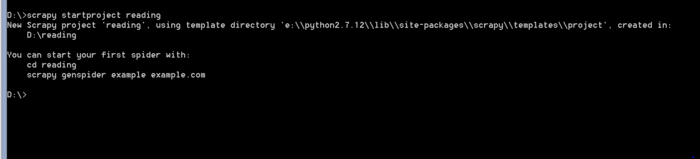
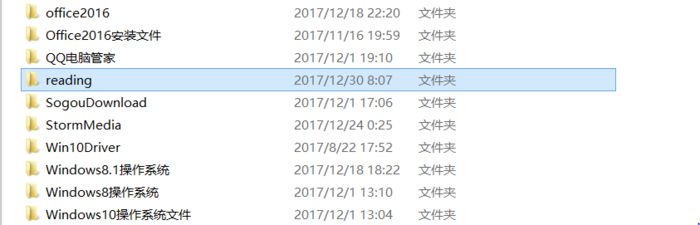
打开文件夹,我们会看到Scrapy框架已经自动在reading文件夹中放置了我们所需的一切原材料:
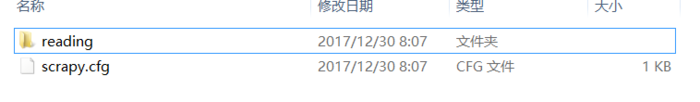
打开内部reading文件夹,就可以在spiders文件夹中添加爬虫py代码文件了:
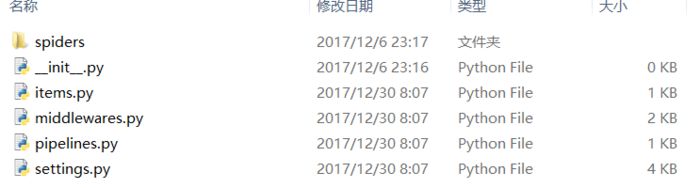
我们这里定向爬小说排行榜,除了我们写的spider文件,还要在items.py中定义我们要爬取的内容集,有点像词典一样,名字可以随便取,但已有的继承类scrapy.Item可不能改,这是Scrapy内部自定义的类,改了它可找不到,spider就用我们上面抓取单本再加一个for循环就OK了,十分简单,一言不合就上图:
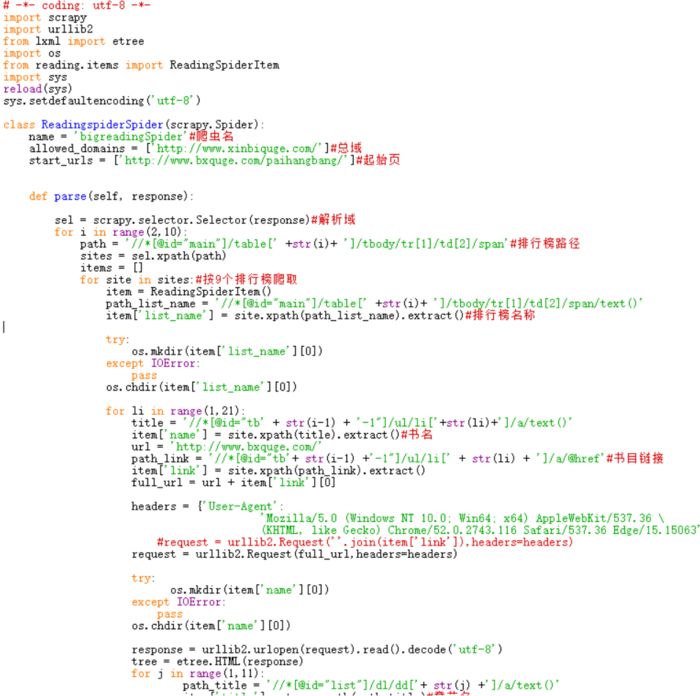
爬虫文件截图
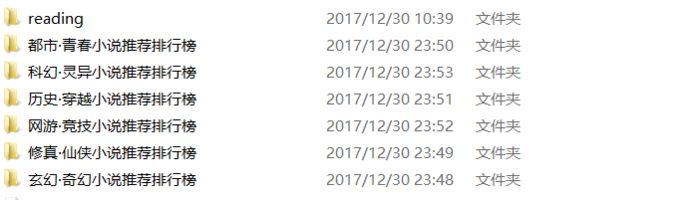
爬取的小说排行榜
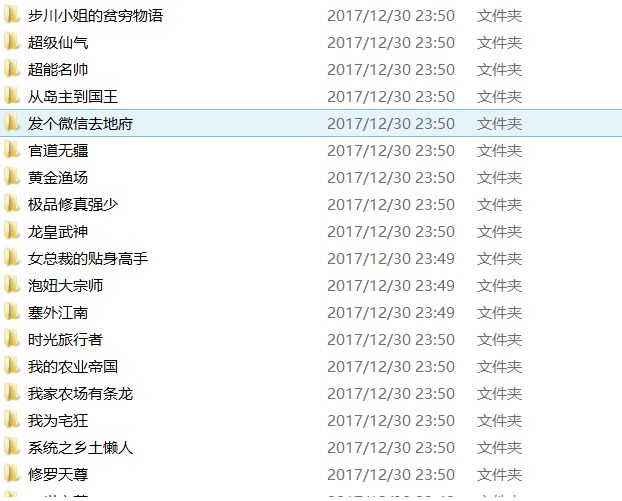
每个排行榜上大约20本小说
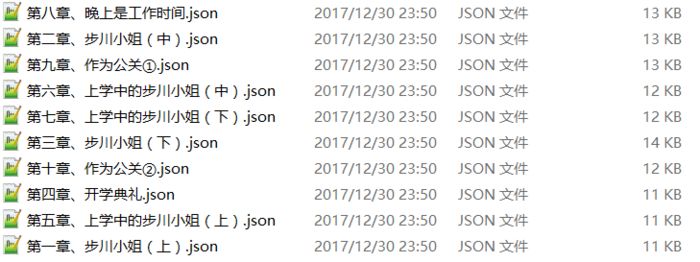
每部小说的爬取情况(用的是.json格式)
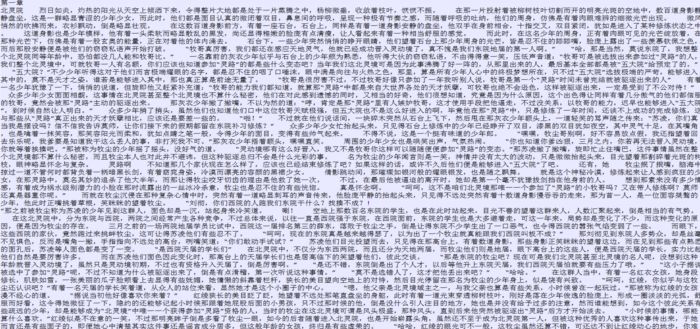
小说显示内容
想要完整代码的骚年们,见百度网盘链接:
items:
链接:https://pan.baidu.com/s/1pKLMyWr
密码:3dee
Settings:
链接:https://pan.baidu.com/s/1slkKQV7
密码:xn0u
Spider:
链接:https://pan.baidu.com/s/1nvBrrtf
密码:76z8
至此,我们所需的数据就都爬取完了,它们都按照相应的文件夹目录放置好在相应位置,适合条理性的观看。

Python爱好者社区历史文章大合集:
Python爱好者社区历史文章列表(每周append更新一次)
 福利:文末扫码立刻关注公众号,“Python爱好者社区”,开始学习Python课程:
关注后在公众号内回复“课程”即可获取:
小编的Python入门视频课程!!!
崔老师爬虫实战案例免费学习视频。
丘老师数据科学入门指导免费学习视频。
陈老师数据分析报告制作免费学习视频。
玩转大数据分析!Spark2.X+Python 精华实战课程免费学习视频。
丘老师Python网络爬虫实战免费学习视频。