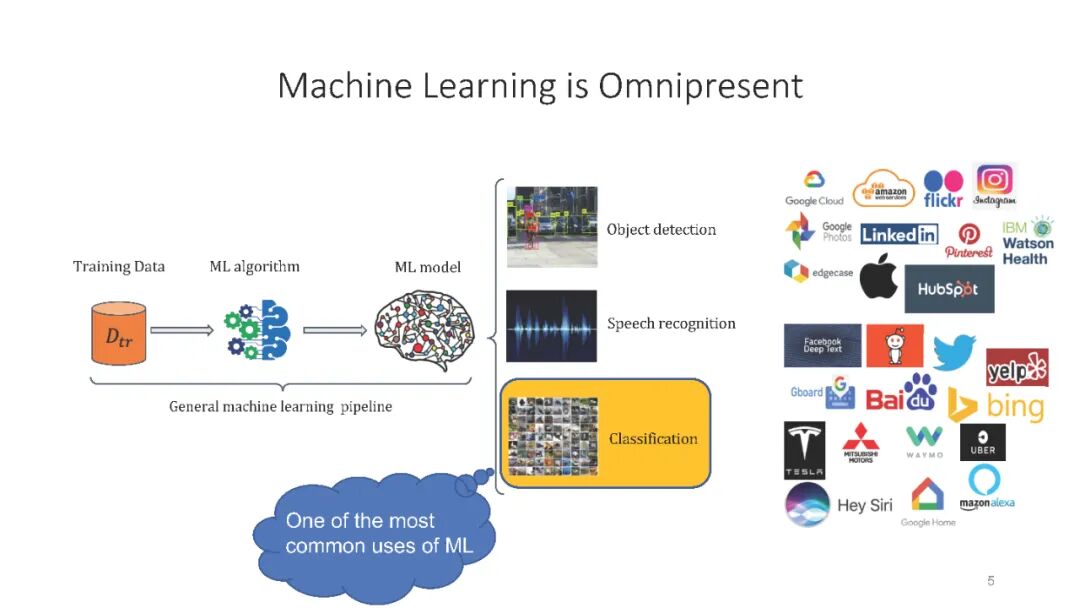
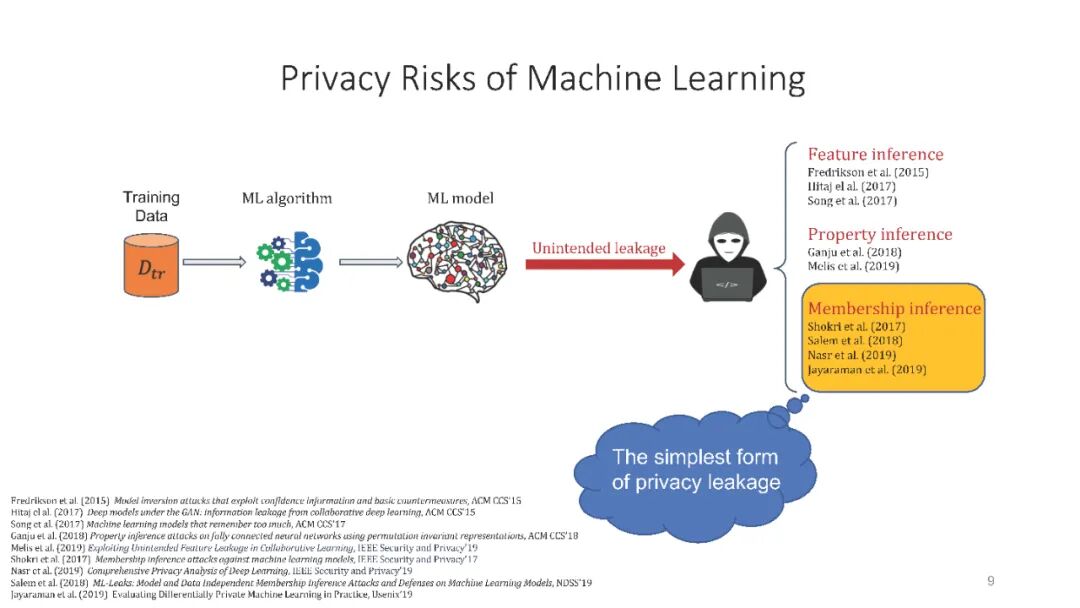
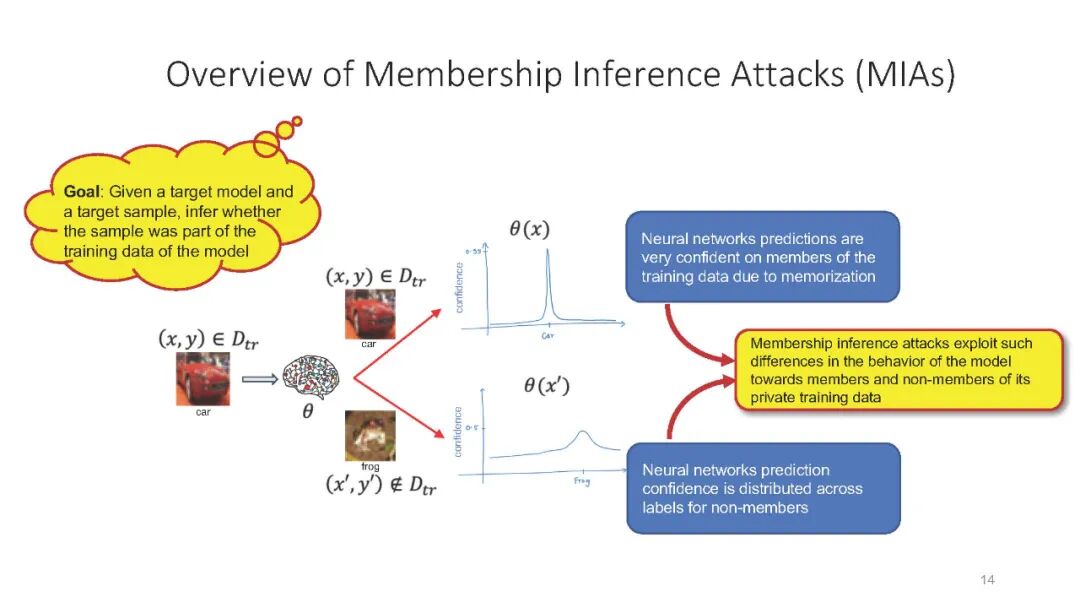
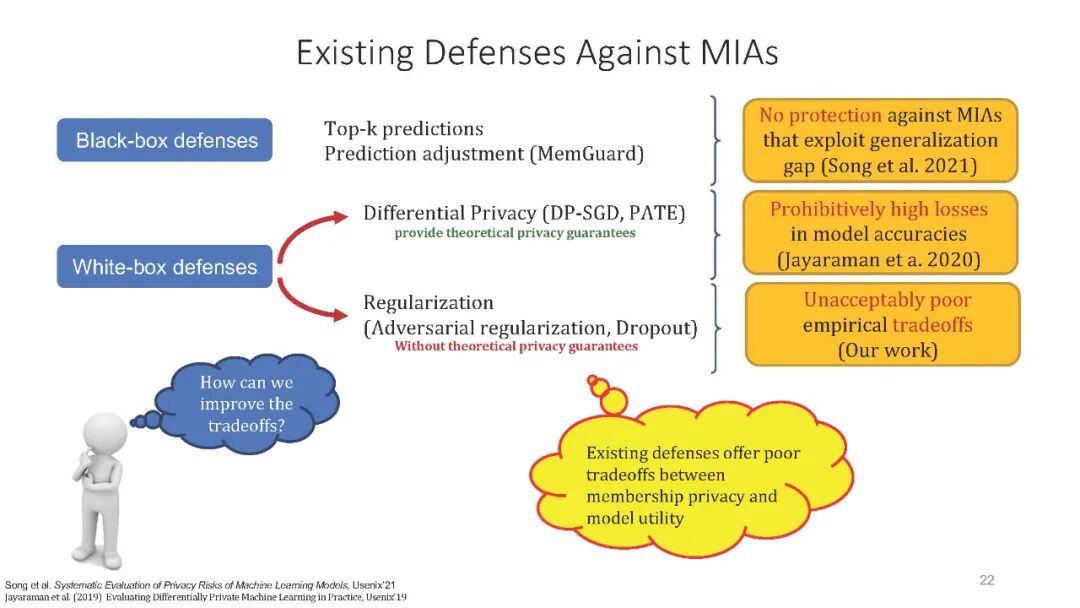
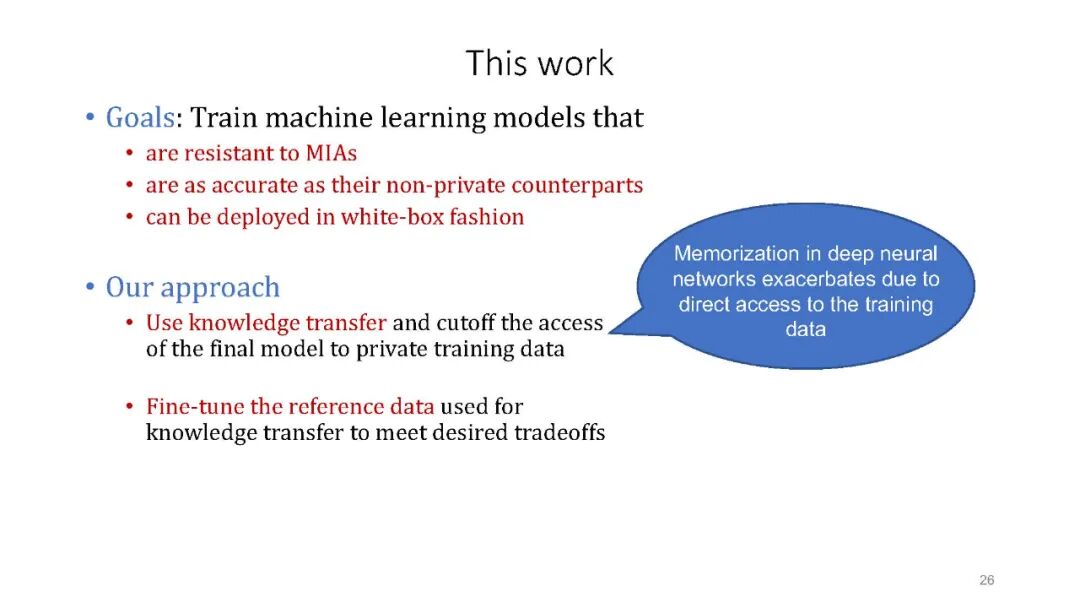
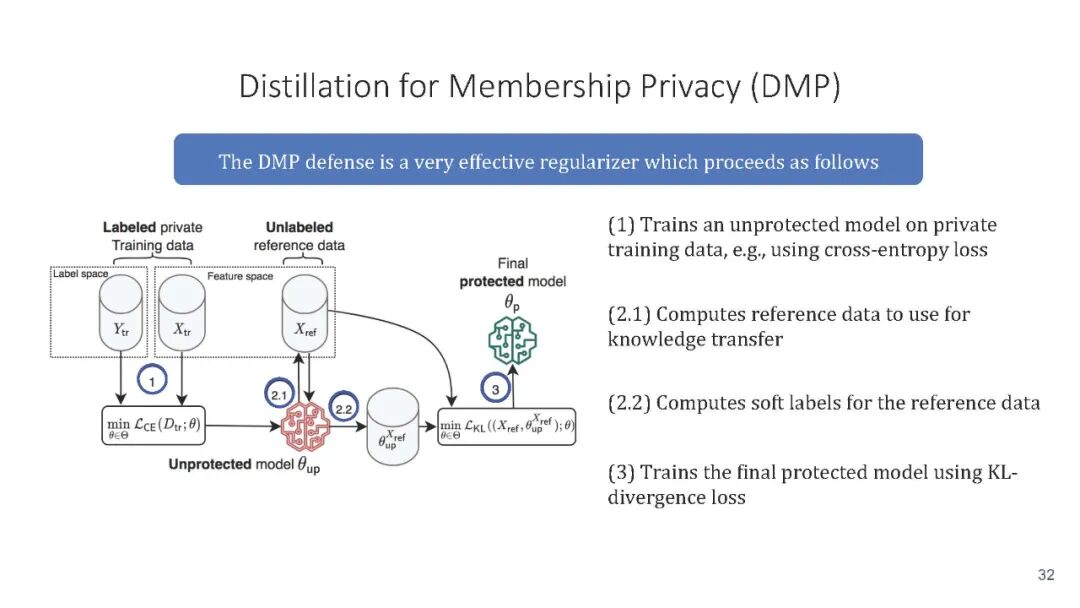
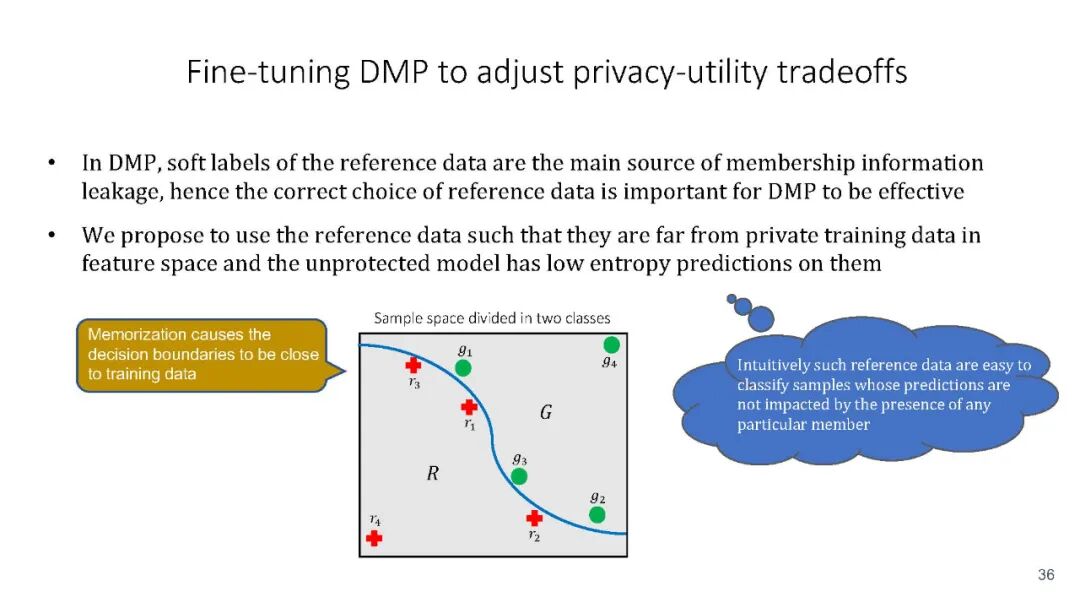
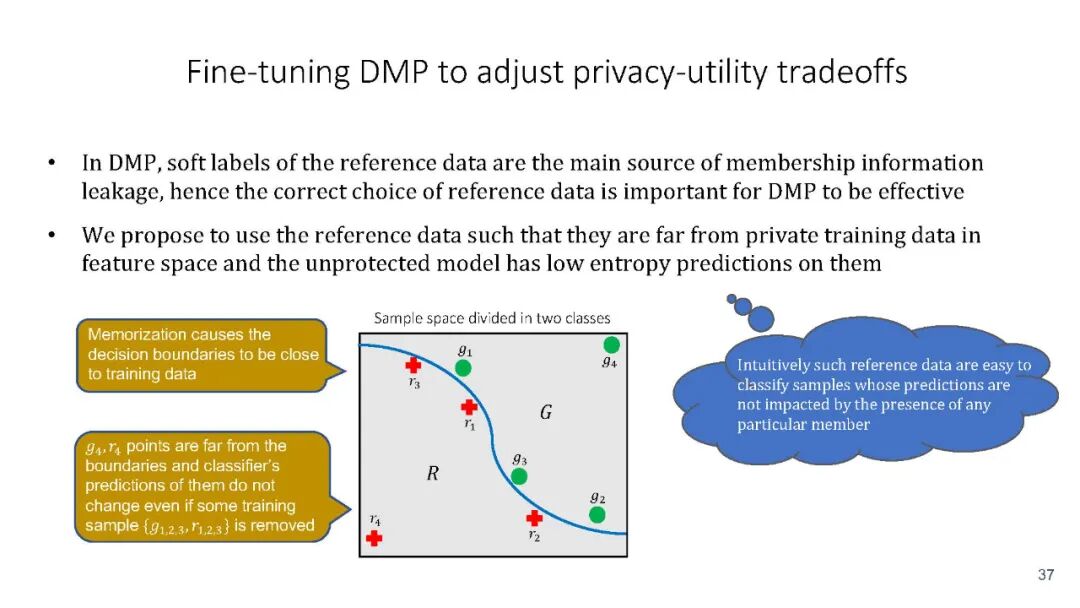
机器学习模型容易受到成员推断攻击,目的是推断目标样本是否属于目标模型的训练数据集。由于成员推理而引起的严重的隐私问题引发了对成员推理攻击的多种防御,例如差分隐私和对抗性正则化。不幸的是,这些防御方法产生的机器学习模型的实用性低得令人无法接受,例如,分类准确性。我们提出了一种新的基于知识蒸馏的防御,称为成员隐私蒸馏(DMP),以对抗成员推理攻击,这种攻击比先前的防御更有效地保留了生成模型的效用。我们提供了一个新的准则来调整DMP中用于知识迁移的数据,以调整所得模型的效用和隐私之间的权衡。我们的评估清楚地展示了最先进的会员隐私-效用折衷。
https://people.cs.umass.edu/~vshejwalkar/dmp_aaai_slides.pdf
专知便捷查看
便捷下载,请关注专知公众号(点击上方蓝色专知关注)

专知,专业可信的人工智能知识分发,让认知协作更快更好!欢迎注册登录专知www.zhuanzhi.ai,获取5000+AI主题干货知识资料!
欢迎微信扫一扫加入专知人工智能知识星球群,获取最新AI专业干货知识教程资料和与专家交流咨询!点击“阅读原文”,了解使用专知,查看获取5000+AI主题知识资源



