一、图解Pandas透视表、交叉表
终于开始Pandas进阶内容的写作了。相信很多人都应该知道透视表,在Excel会经常去制作它,来实现数据的分组汇总统计。在Pandas中,我们把它称之为pivot_table。
透视表的制作灵活性高,可以随意定制我们想要的的计算统计要求,一般在制作报表神器的时候常用。
下面通过具体的例子来对比Excel和Pandas中透视表的实现方法。
二、Excel透视表
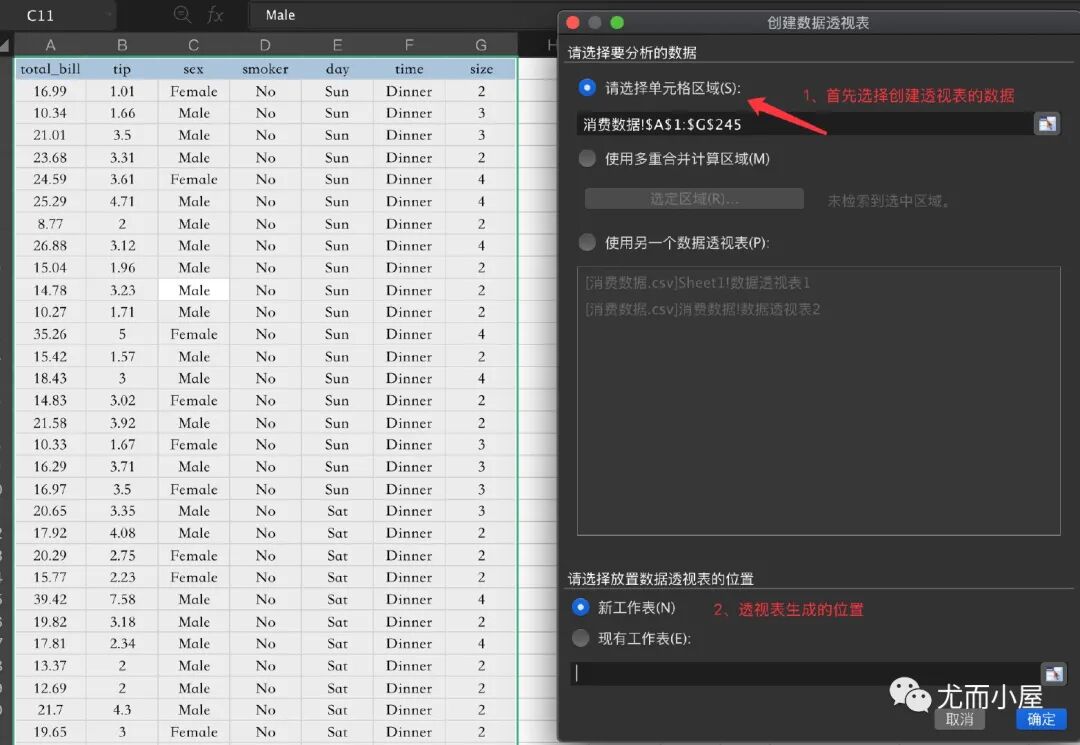
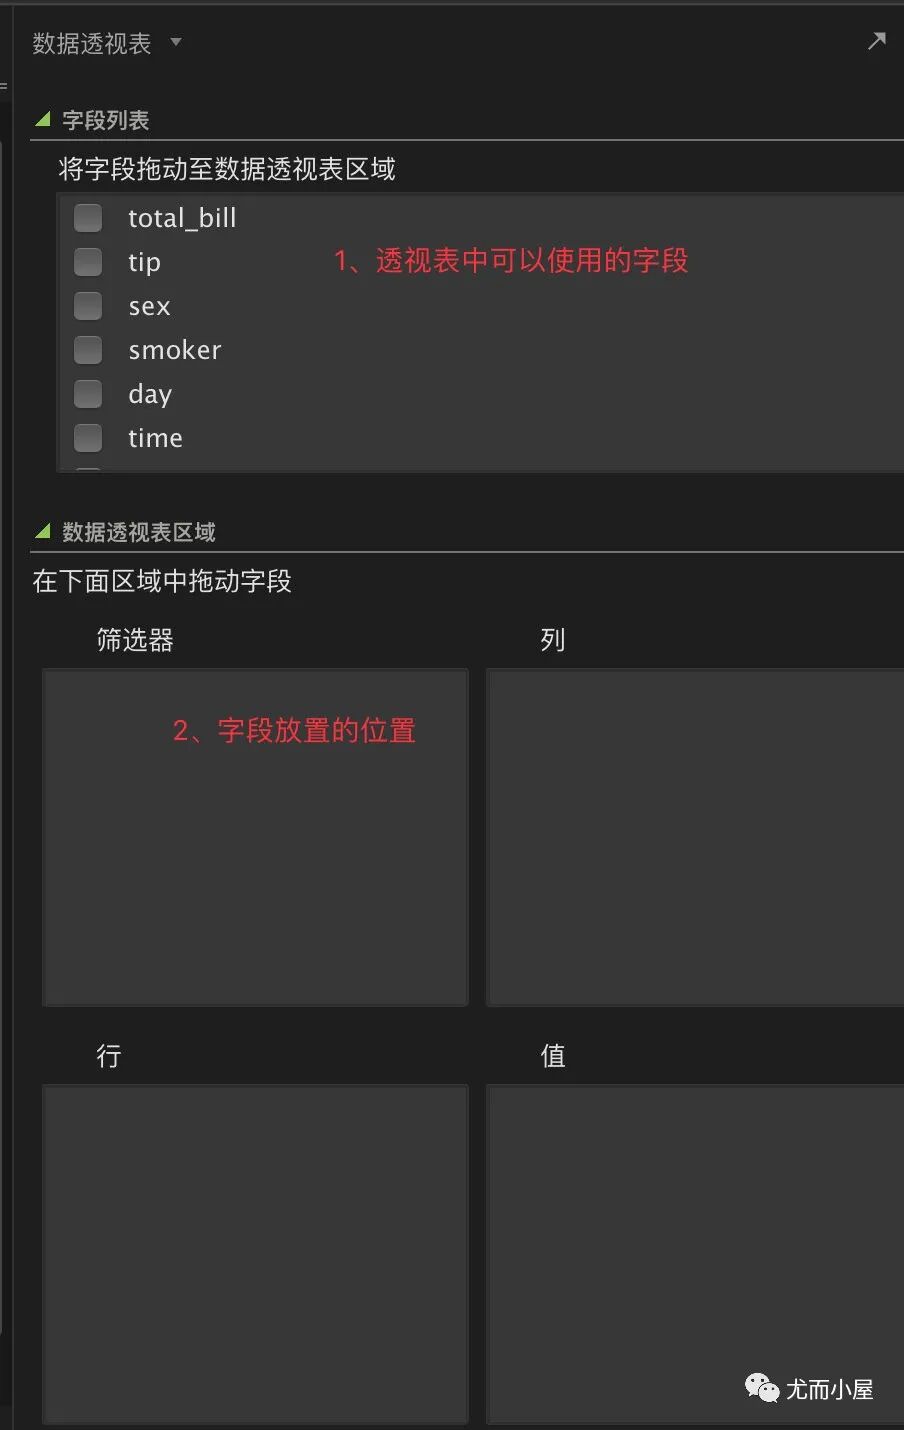
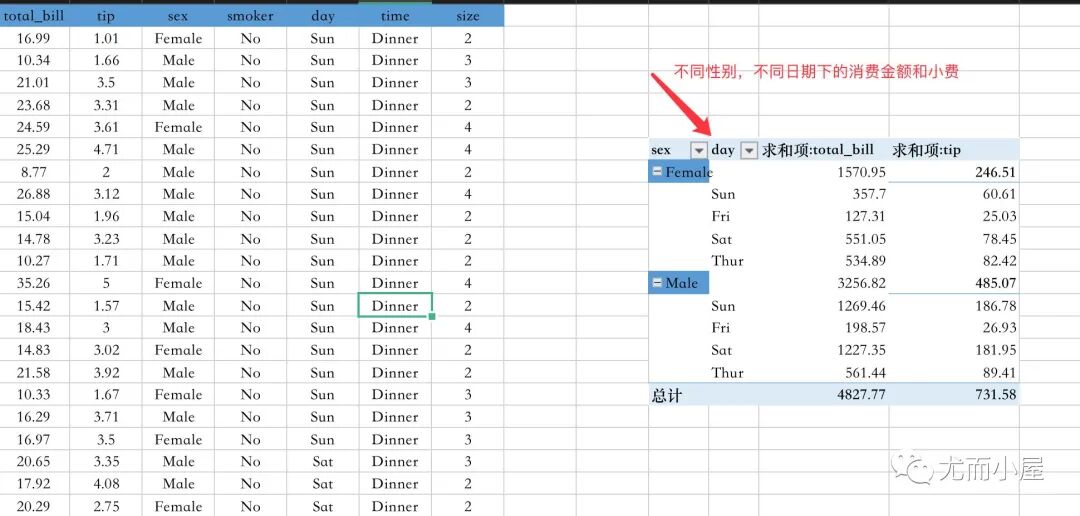
下面是在Excel表格中使用消费数据制作的透视表(部分数据截图),我们统计的是不同性别不同日期下的消费金额和小费,同时还显示了总计的数据。
那如果是使用pandas该如何来实现呢???
三、透视表参数
pandas中实现透视表使用的是:pandas.pivot_table
pd.pivot_table(data,  # 制作透视表的数据
               values=None,  # 值
               index=None,  # 行索引
               columns=None,  # 列属性
               aggfunc='mean',   # 使用的函数,默认是均值
               fill_value=None,  # 缺失值填充
               margins=False, # 是否显示总计
               dropna=True,   # 缺失值处理
               margins_name='All', # 总计显示为All
               observed=False,
               sort=True  # 排序功能  版本1.3.0才有
              )
最重要的参数还是:values、index、columns、aggfunce,甚至包含margins、margins_name
附上官网学习地址:https://pandas.pydata.org/pandas-docs/stable/reference/api/pandas.pivot_table.html
四、透视表参数详解
4.1参数index
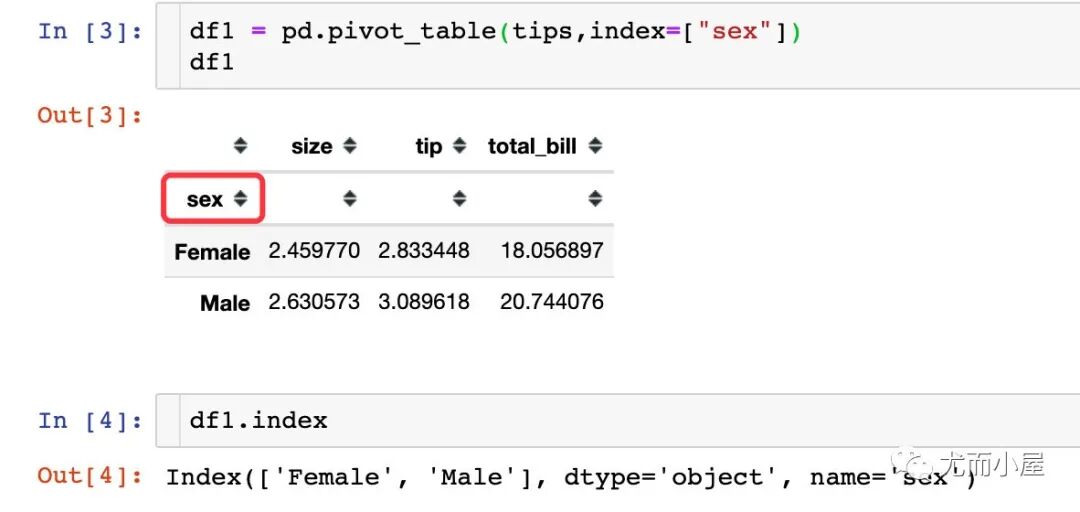
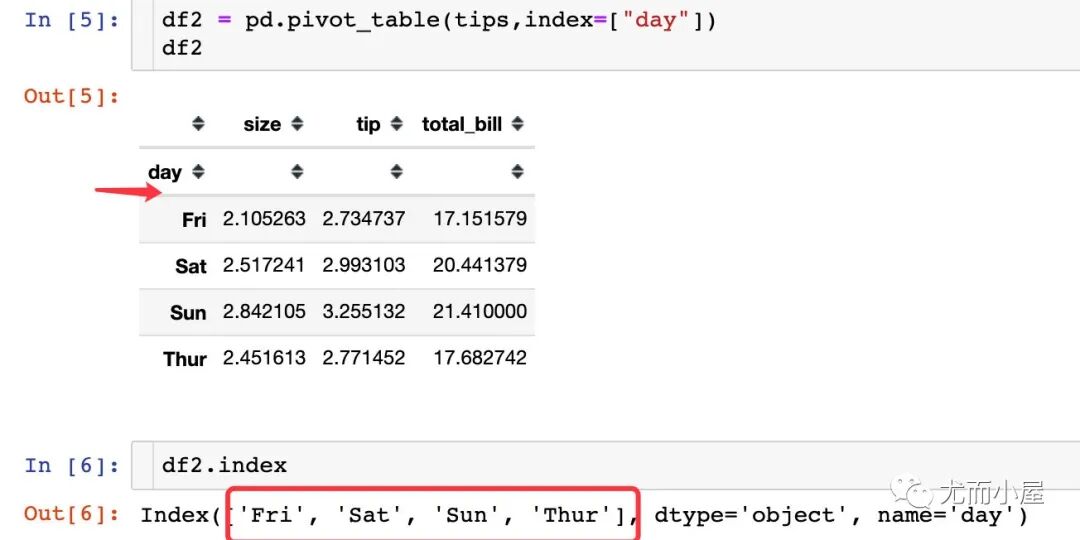
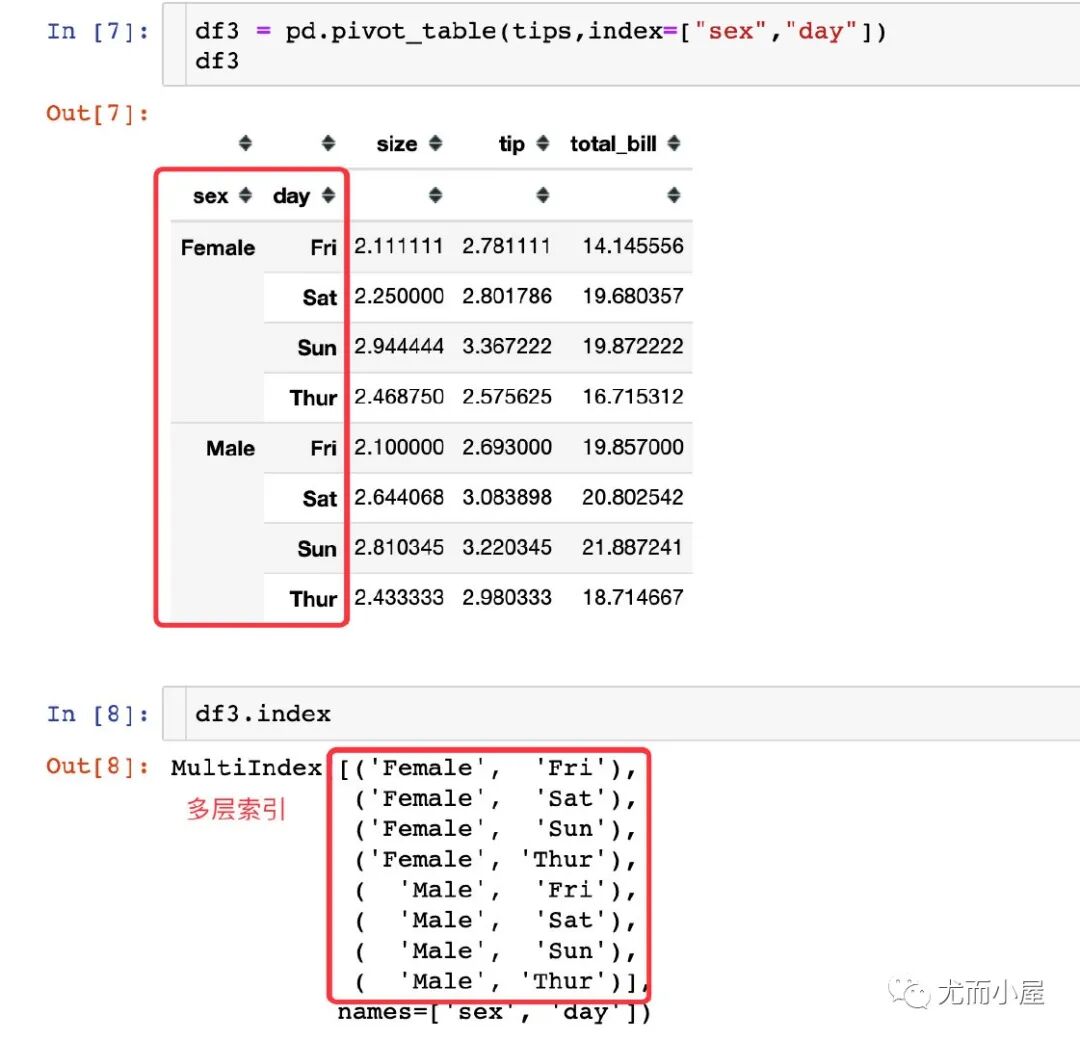
index表示的是我们生成透视表指定的行索引
1、单层索引
2、多层行索引
4.2参数values
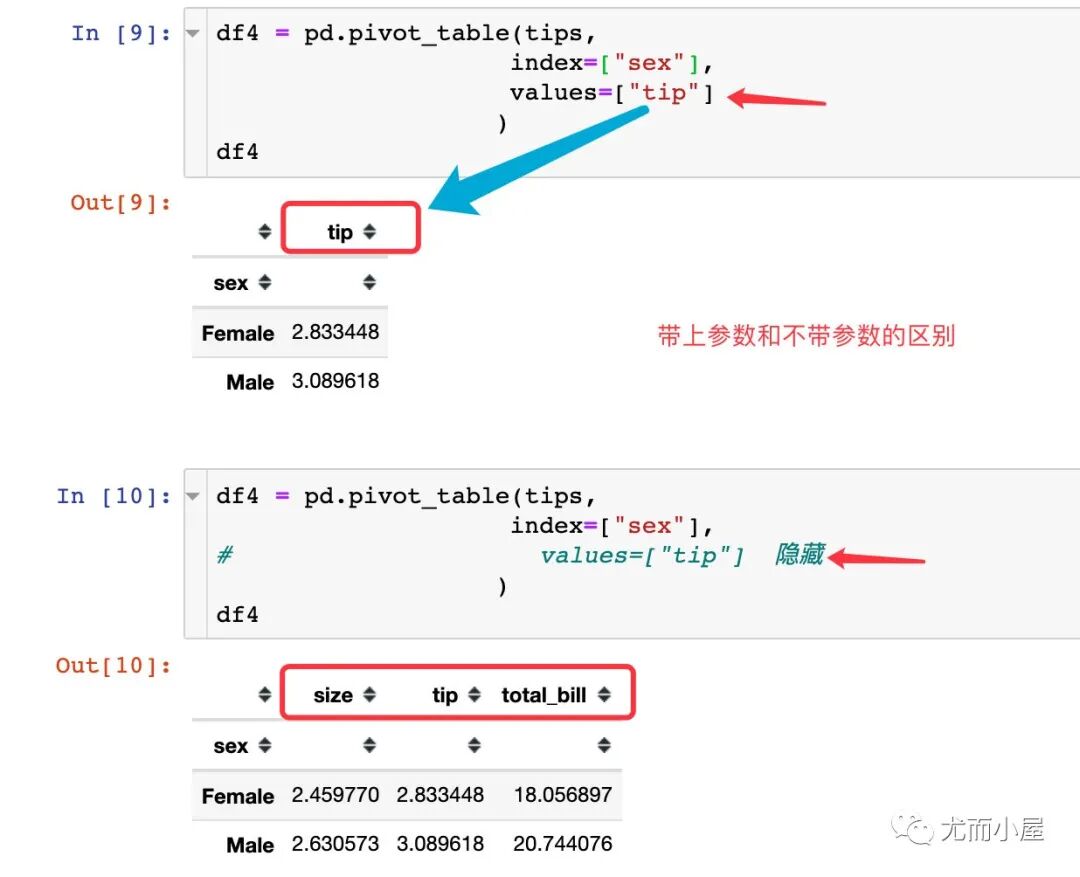
在上面index参数的使用中,我们没有指定values参数,pandas会默认将全部的数值型数据进行透视表的计算,现在指定参数计算的数据:
4.3参数columns
columns是一个显示列属性信息的参数
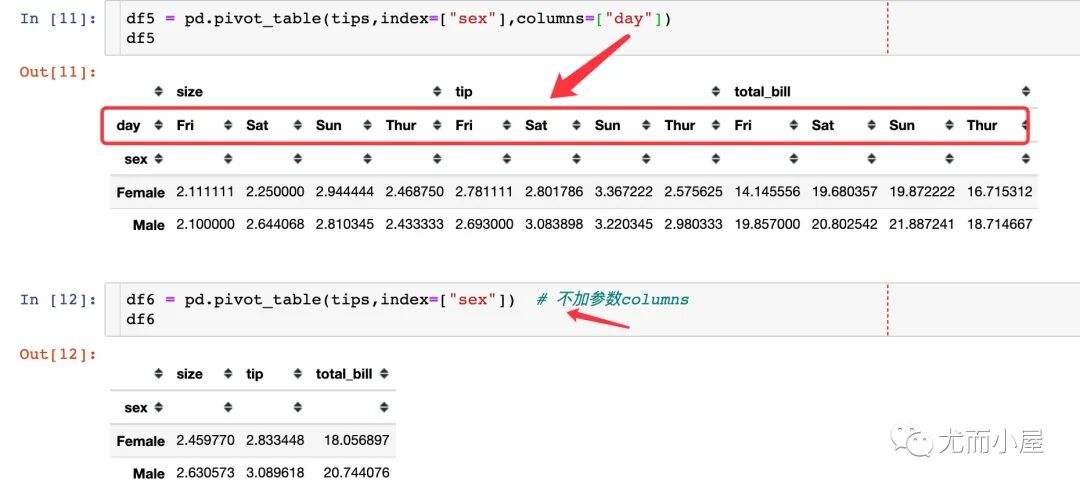
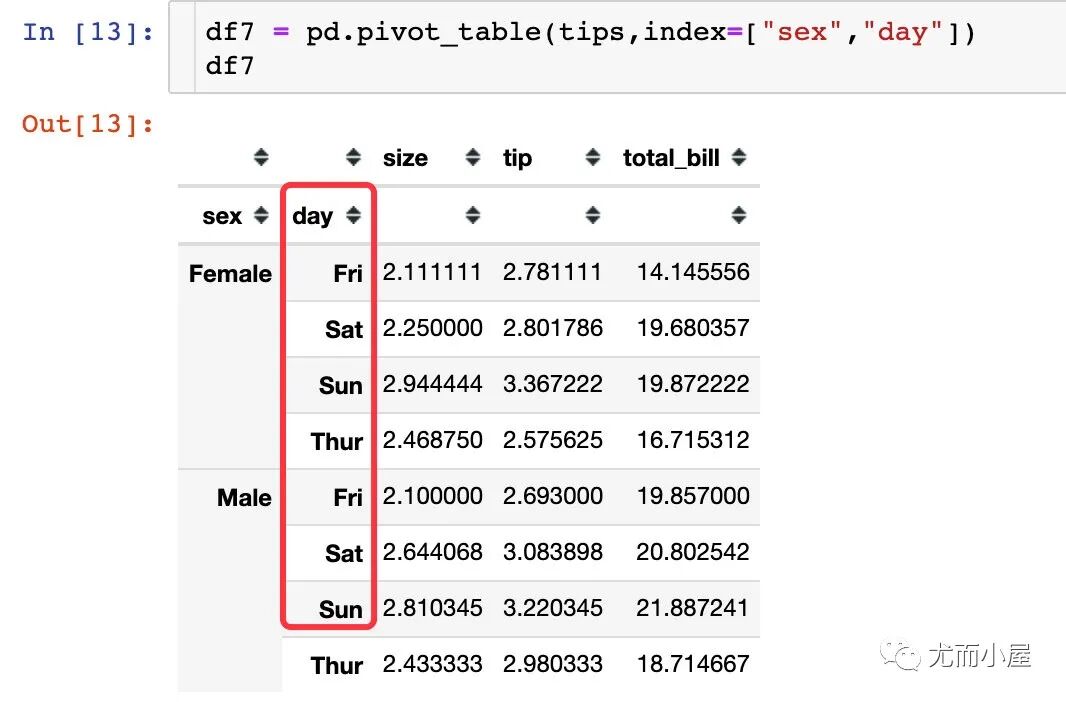
如果我们将day放在index参数中,会是什么样子呢?
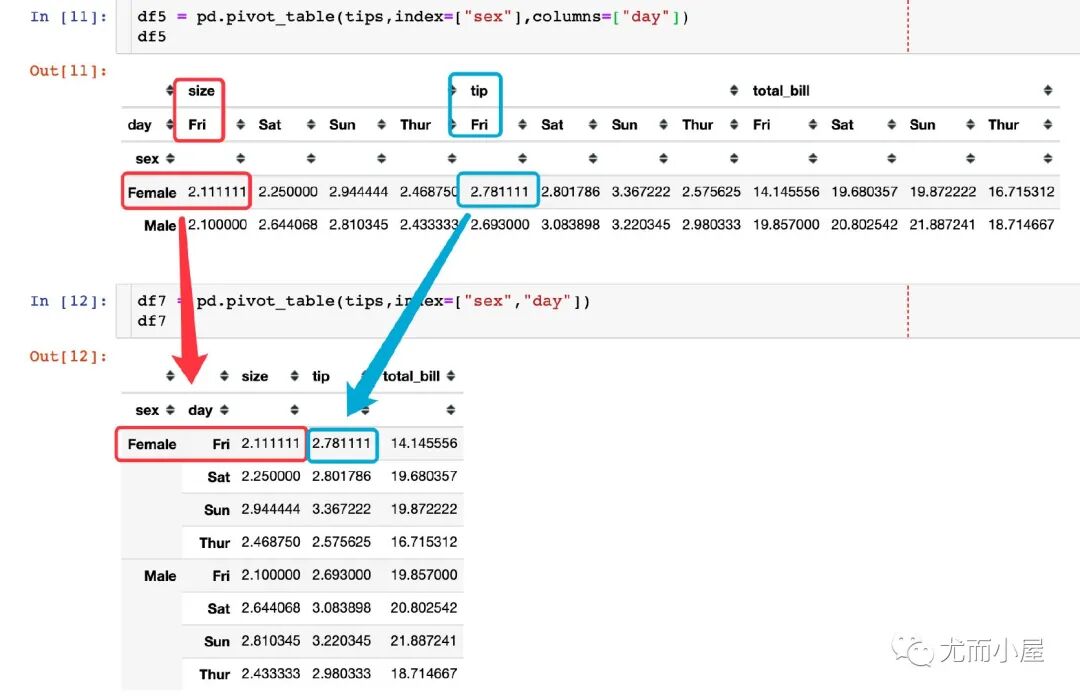
相当于是:将上面的宽表格式转成了下面的长表格式
再对比下两种不同的形式:
4.4参数aggfunc
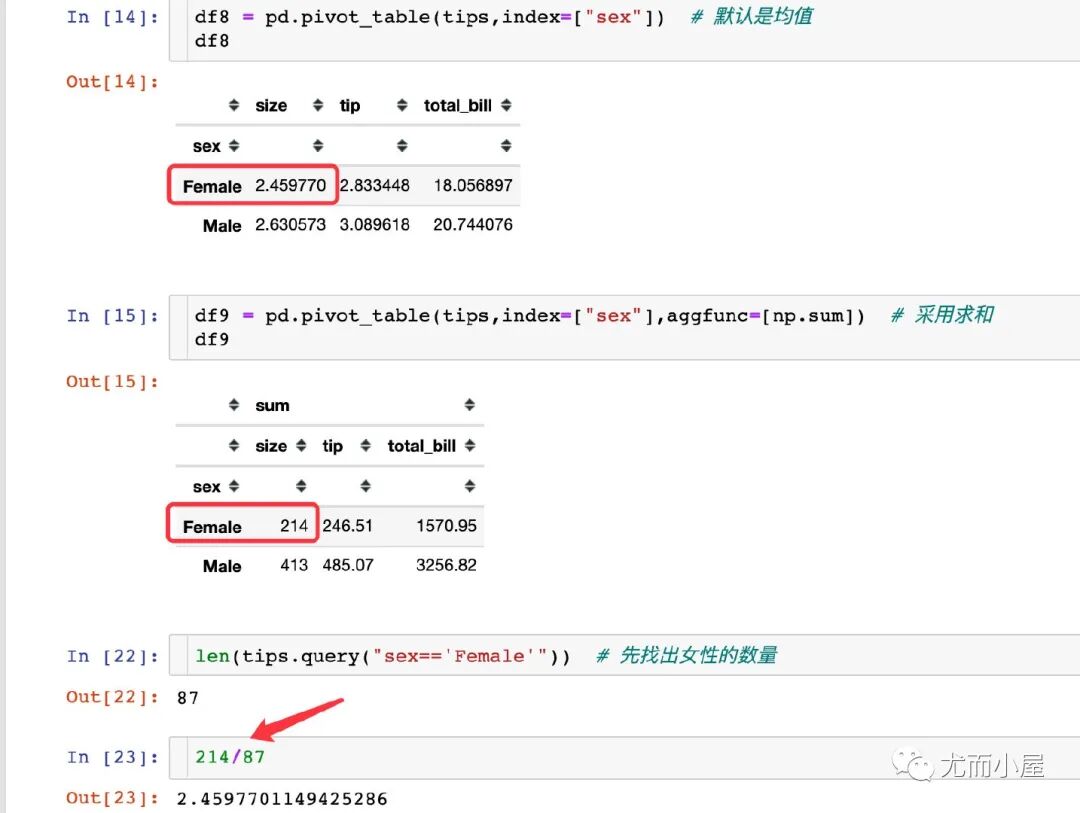
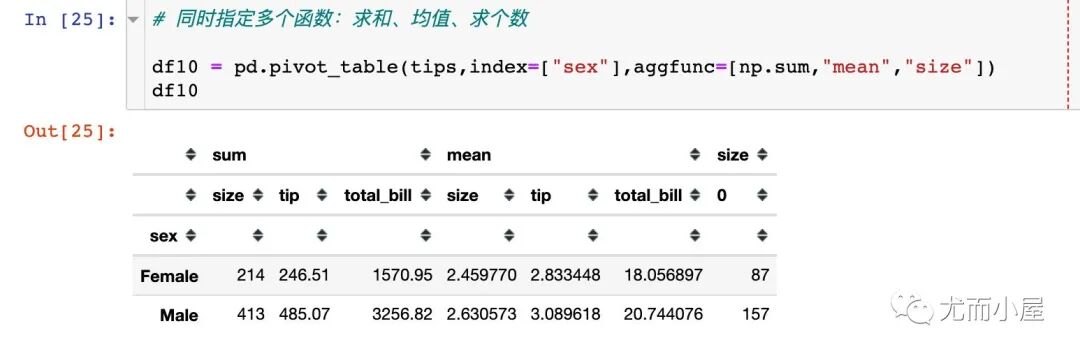
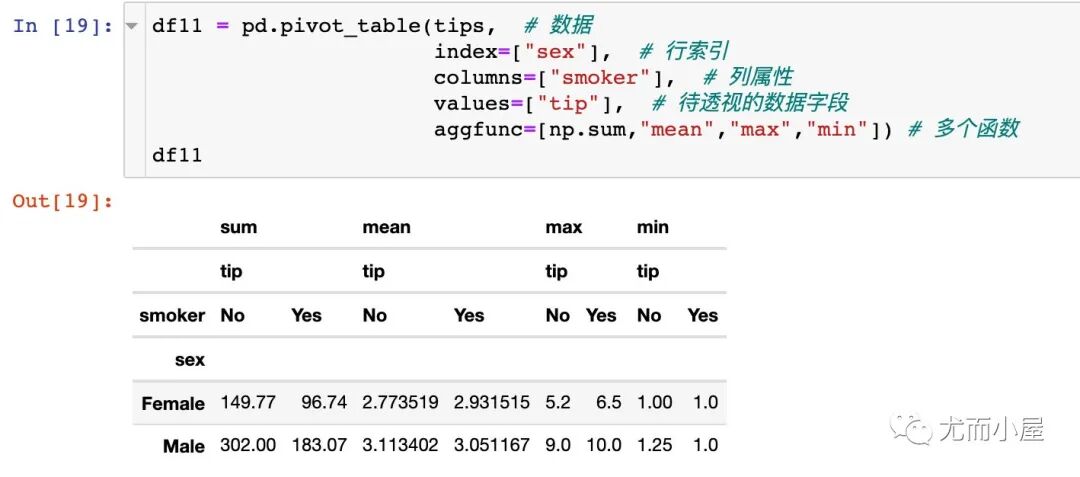
aggfunc是一个很灵活的参数,它是用来指定我们汇总想用哪种函数,默认是均值mean,我们也可以使用求和sum、最值max等。多个函数需要放在一个列表中。
我们将默认求平均mean的情况与求和的情况进行对比:
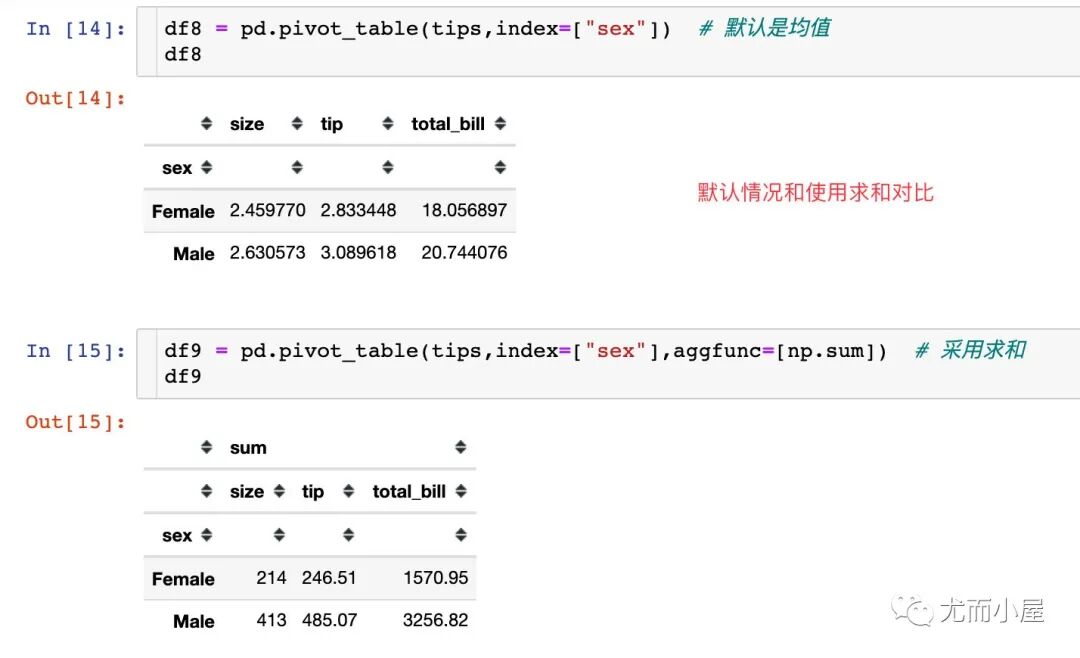
均值和sum求和之间的关系:
我们可以在aggfunc函数中指定多个函数,将这些函数放在同一个列表中:
再看一个例子:
4.5参数margins、margins_name
这两个参数的作用是对透视表中的分组数据进行汇总显示。需要注意的是:只有margins=True,参数margins_name的设置才会生效。
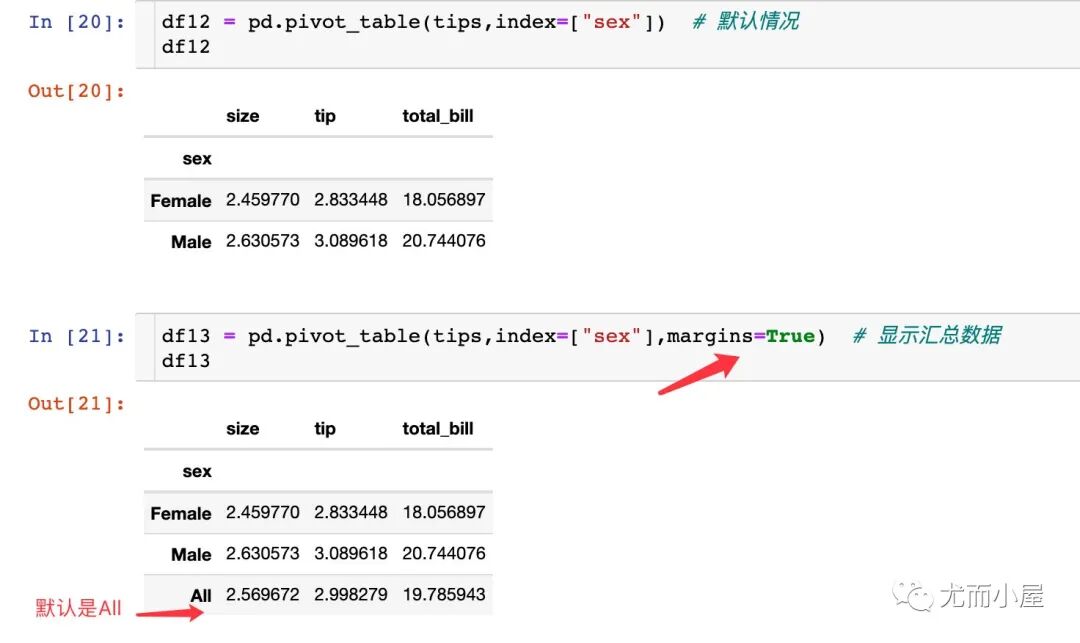
修改汇总显示的名字:
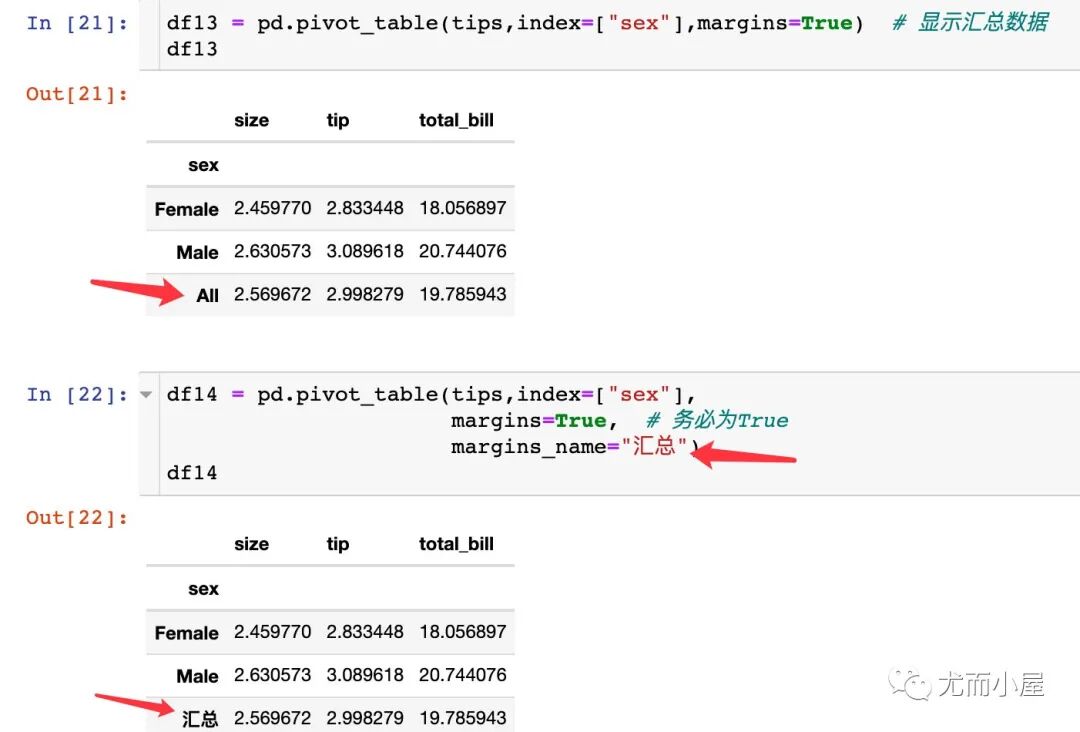
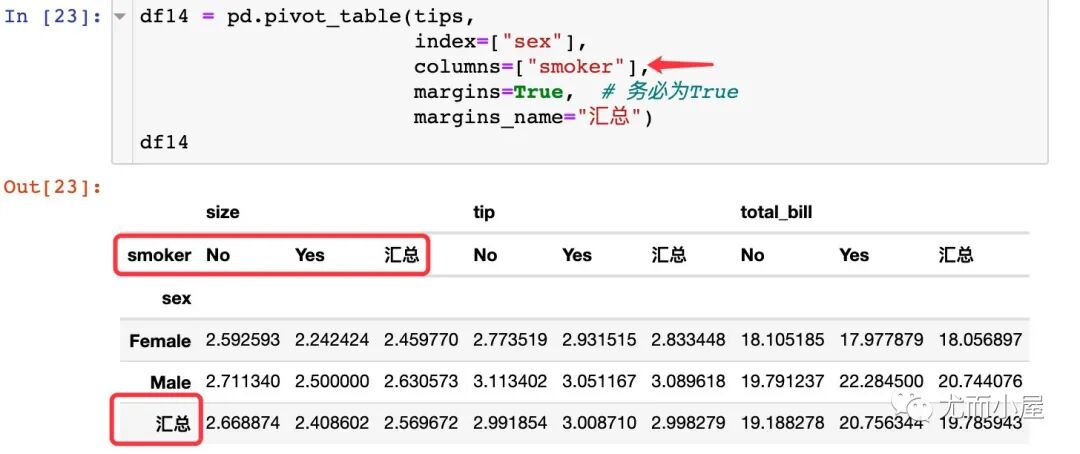
如果有列字段,也会显示汇总的数据:
五、交叉表crosstab
交叉表可以理解成一种特殊的透视表,专门用于计算分组的频率。
5.1参数
交叉表中每个参数的解释,很多还是和透视表相同的:
pandas.crosstab(index, # 行索引,必须是数组结构数据,或者Series,或者是二者的列表形式
                columns, # 列字段;数据要求同上
                values=None,  # 待透视的数据
                rownames=None,  # 行列名字
                colnames=None,
                aggfunc=None,  # 透视的函数
                margins=False,  # 汇总及名称设置
                margins_name='All',
                dropna=True, # 舍弃缺失值
                normalize=False  # 数据归一化;可以是布尔值、all、index、columns、或者{0,1}
               )
对最后一个参数的解释:如何选择归一化的标准
- If passed ‘all’ or True, will normalize over all values:使用all,对全部的数值型数据归一化
- If passed ‘index’ will normalize over each row:使用index,仅在行上归一化
- If passed ‘columns’ will normalize over each column:使用columns,仅在列上归一化
- If margins is True, will also normalize margin values:如果margins=True,总计值也会参与归一化
5.2参数使用
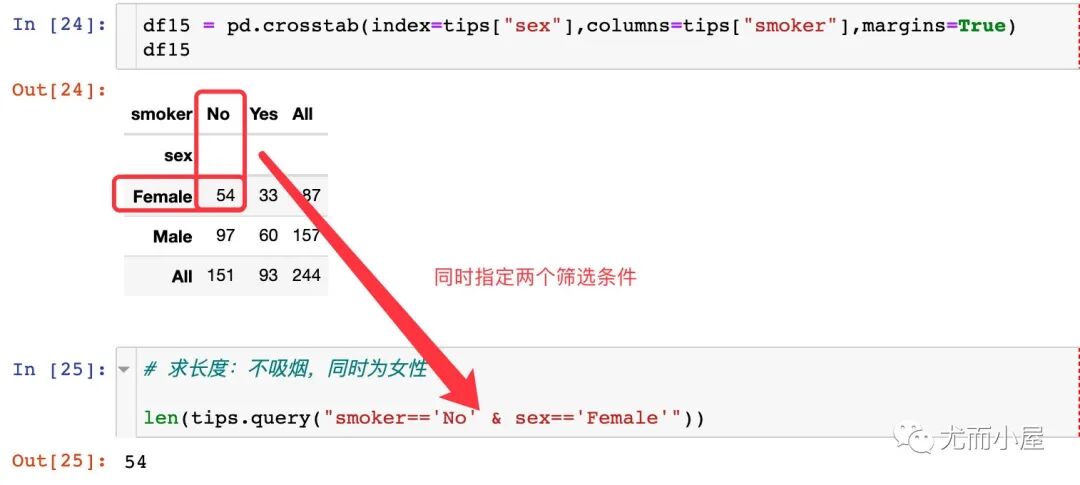
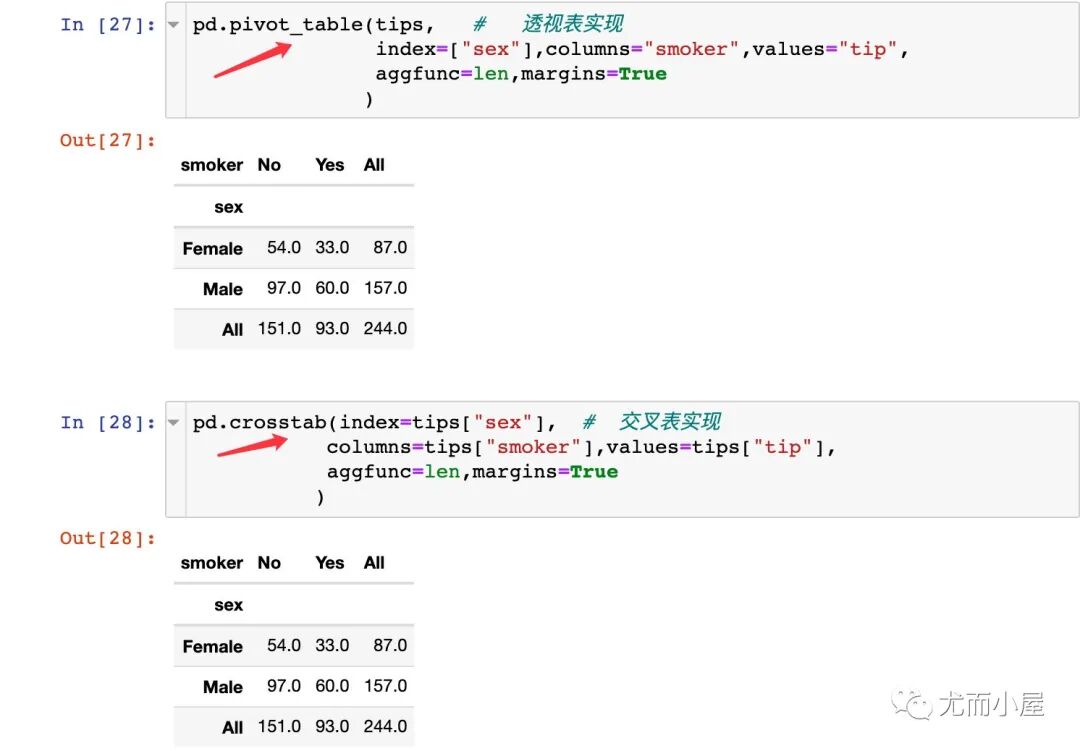
当然,有时候透视表和交叉表是可以实现相同的功能:
六、groupby实现
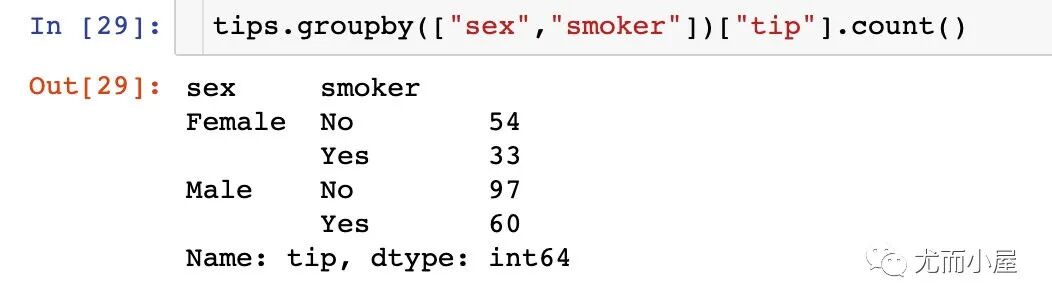
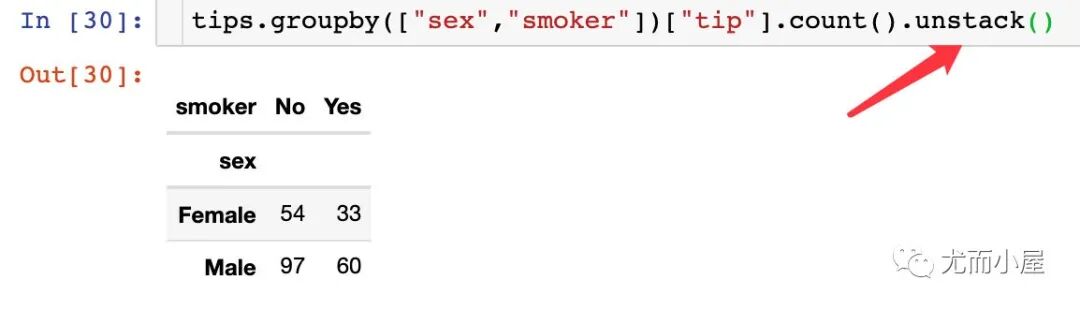
其实透视表或者交叉表的本质还是分组汇总统计结果,我们也可以利用groupby来实现:
1、先分组统计
2、轴旋转unstack
上面的结果格式上不是很友好,使用的是多层次索引,我们使用轴旋转函数unstack将行转成列:
七、groupby和透视表比较
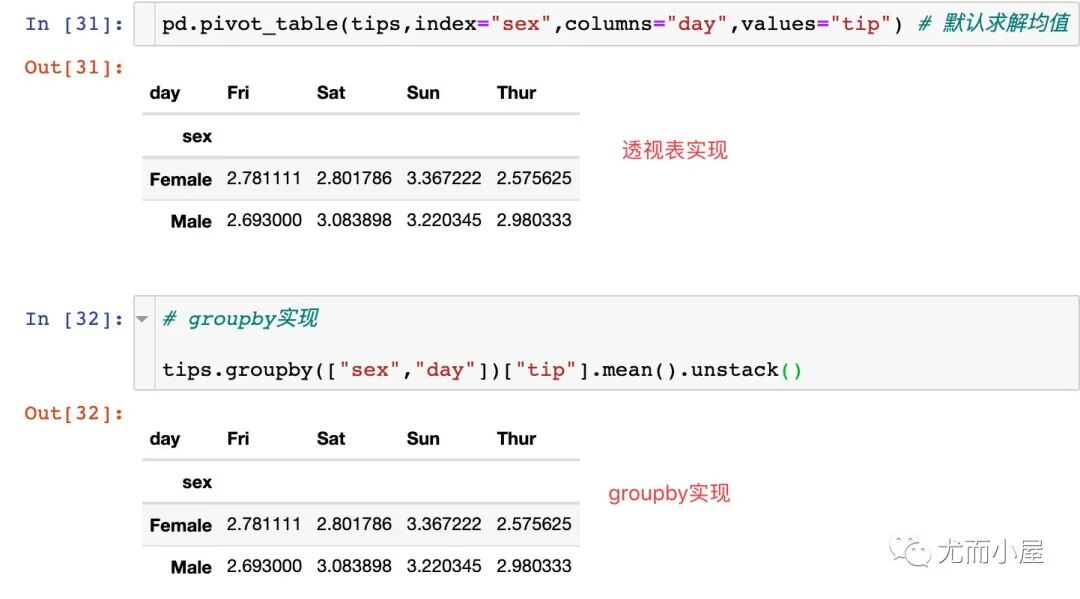
最后再用一个例子来比较下groupby和透视表:
八、备忘录
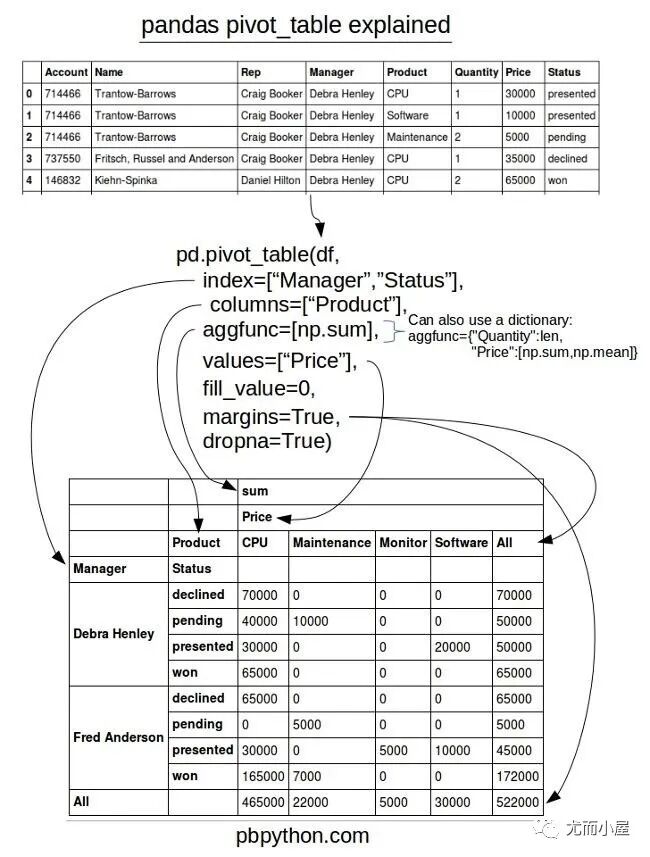
这个网上非常流行的一张图解Pandas透视表函数的图形,它利用一份简单的数据,清晰明了地讲解了pivot_table函数的每个参数的含义,保存备用!
 网络图



