很多算法工程师说,给我标注好标签,我上去一把梭就搞定了。
标注这件事是有成本的,现实生活中,无标签的数据易于获取,而有标签的数据收集起来通常很困难,标注也耗时和耗力。
在这种情况下,半监督学习(Semi-Supervised Learning)应运而生,一种用于解决有一些少量带标签的样本,和大量无标签的样本的场景下的算法。
伪标签学习(pseudo learning),算是半监督学习算法里面一个strong baseline吧。
这也是我们前面提到的少有的在很多数据集上通用的刷分方法。
所有数据集上给神经网络刷分的通用方法
其原理用一句话说,用少量的有标注数据训练模型,推导出无标注数据的近似标签,或者软标签。加回去训练就行。
像不像武当纵云梯,左脚踩右脚。
听起来挺离谱的,我们把步骤用伪代码实现一下。
model1.fit(train_set,label,  val=validation_set) #step1
pseudo_label=model.pridict(test_set)  #step2
new_label = concat(pseudo_label, label) #step3
new_train_set =  concat(test_set, train_set)  #step3
model2.fit(new_train_set, new_label,   val=validation_set) #step4
final_predict = model2.predict(test_set) #step5
用网上一个经典的图来说就是。
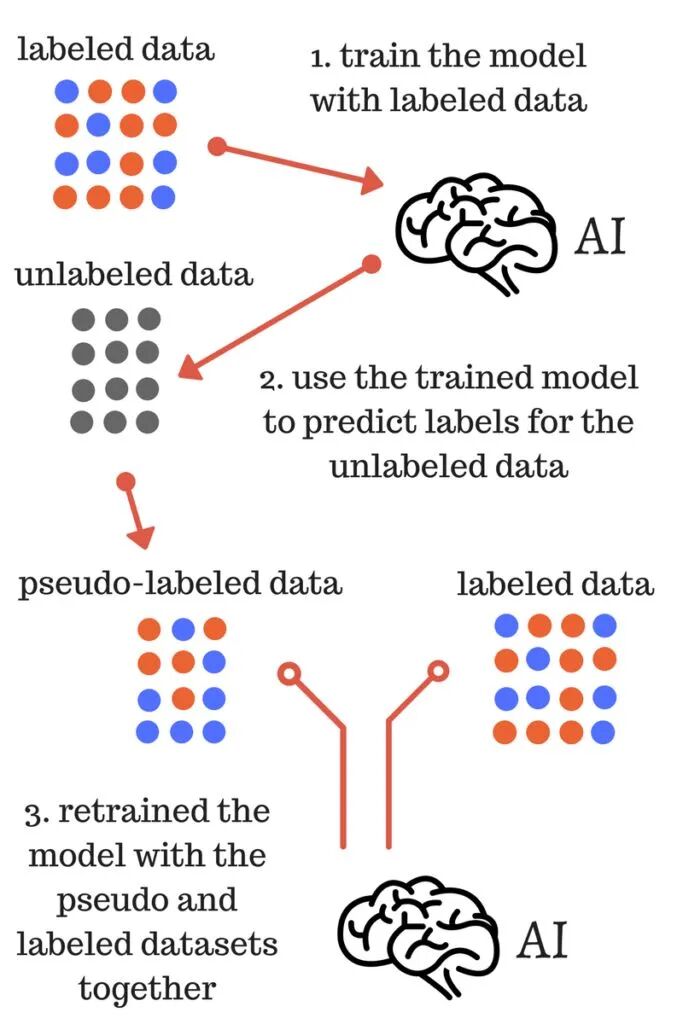
具体的步骤可以对应着伪代码中的注释
step1&2:将有标签部分数据分为两份:train_set&validation_set,并训练出最优的model1
step3:用model1对未知标签数据(test_set)进行预测,给出伪标签结果pseudo-labeled
step4:将train_set和pseudo-labeled 融合作为新的new_train_set,训练出最优的model2
step5:再用model2对未知标签数据(test_set)进行预测,验证还是用之前的validation_set,得到最终的final result label
注意一个细节,验证集validation_set从头到尾都没有参与到训练之中,这是为了防止leak。
-
- 机器学习交流qq群955171419,加入微信群请扫码:



