近年来,深度学习模型在量化选股中的应用逐渐增多。相比传统线性因子模型,深度学习模型可以同时处理多维度输入变量,并通过非线性结构捕捉变量之间的复杂关系。从研究角度看,这为量价数据、基本面数据、分析师预期、文本信息等多源数据的联合建模提供了更灵活的工具。
不过,在实际研究中,一个值得重视的现象是:端到端训练得到的深度学习因子,往往并不完全是新的独立Alpha。许多模型在回测初期表现较好,但经过Barra风格归因后,会发现其因子暴露集中在低波动、小市值、短期反转、低流动性等方向。进一步对因子进行行业和风格中性化后,原本较高的RankIC或分组收益可能明显下降,甚至失去稳定性。
这说明模型表面上学习到了复杂的时序关系和非线性特征,实际上可能只是在用更复杂的方式复制已有风格风险。问题的关键不在于深度学习模型是否足够复杂,而在于模型可能通过“风格捷径”降低损失,优先学习历史上最容易解释收益差异、信噪比最高的部分。
今年以来,市场阶段性切换高成长、高Beta、高动量风格,过去几年表现良好的传统深度学习因子普遍表现一般甚至出现方向反转,以中证500为代表的宽基指数在今年通过量化指增方式获取超额收益的难度明显增加。
在上述背景下,有必要探讨如何构建更稳定的深度学习因子。更稳定意味着超额收益靠的不是、至少不只是单一风格所带来的阶段性收益,而是能够穿越市场风格的纯Alpha。
本文从理论出发,结合实际经验,构建了更稳定的深度学习因子StableAlpha。
以下为理论探讨。从实际经验来看,相关针对性改进并不一定有效。但理论具有参考、指引意义,结合数据、模型、损失函数、标签等做细微调优,寻找最佳训练范式。
(一)标签
深度学习选股模型通常以未来收益率作为训练标签,例如未来5日、20日收益,或者未来一期的截面排名。这个标签看似直接,但它本身并不是纯Alpha,而是混合了市场收益、行业收益、风格收益和个股特异收益。
从横截面角度看,个股未来收益可以拆分为多个部分:一部分来自市场和行业,一部分来自市值、Beta、波动率、动量、流动性等风格暴露,还有一部分才是难以被常见风险因子解释的残差收益。
在不少历史阶段中,小市值、低流动性、短期反转、低波动等风格本身就具有较强的横截面收益解释力。对于神经网络而言,这些风格信号不仅稳定存在于训练样本中,而且比真正的个股特异Alpha更容易被捕捉。因此,模型会自然地把这些风格暴露作为主要预测依据。
这并不意味着模型“犯错”了。相反,从优化目标看,它是在非常有效地完成原始任务:预测未来收益。但对于量化投资而言,仅仅预测原始收益并不足够。我们更关心的是,在剔除常见风险暴露之后,模型是否仍能提供稳定、可交易、可解释的超额收益。
当模型标签设置为未来1日、3日、5日、20日等不同期限收益时,模型学习到的风格特征也会有所差异。从实际经验来看,1~3天这类较短周期标签并不一定主要体现反转,反而更容易带有短期动量特征,例如近期价格强势、成交放大、资金惯性延续等信号;而当预测周期拉长至5日、20日时,反转和流动性相关信号往往会更加突出。
这一现象可能与不同期限下收益来源的差异有关。短周期价格变化中,资金流入、事件冲击、涨跌停延续和盘中强势收盘等因素更容易形成趋势延续;而在更长一些的预测窗口中,前期价格冲击逐渐被消化,短期涨跌幅较大的个股更容易出现均值回归。模型因此可能在5日、20日标签下更倾向于买入前期调整较多、成交不活跃、价格存在修复空间的股票。
(二)权重
端到端模型常见的训练方式是将每只股票过去一段窗口期的数据视作一条样本,并对所有样本赋予相同权重。这样做实现简单,也有利于提升样本数量,但会带来一个隐含问题:股票数量最多的群体,会在训练中拥有更高的话语权。
以全市场股票池为例,大市值龙头股票数量有限,而中小市值和微盘股票数量更多。如果训练样本完全等权,模型参数更新过程中,小市值股票的样本贡献会显著放大。与此同时,小市值股票的收益弹性更强、截面离散度更高,极端收益和短期反转现象也更常见。为了降低整体损失函数,模型很容易优先适配这部分样本。
因此,即使输入数据中没有显式提供市值变量,模型也可能通过成交金额、换手率、价格波动、历史收益形态等代理变量间接识别小市值股票,导致最终形成的因子在Barra归因中表现出明显的小市值暴露。
这种暴露在回测中可能带来较高收益,但其长期稳定性和实盘容量受限。小市值风格往往受市场制度、风险偏好、流动性环境和监管政策影响较大。一旦市场环境发生变化,过去有效的小市值暴露可能快速衰减,甚至反向拖累组合表现。
(三)数据
深度学习模型常用的输入数据包括开盘价、最高价、最低价、收盘价、成交量、成交金额、技术指标等。表面上看,这些是标准的量价特征;但从风险模型角度看,它们也包含了大量风格代理信息。
例如,过去一段时间的收益波动、振幅和回撤可以帮助模型识别低波动或高波动股票;成交额、换手率和价格冲击可以帮助模型识别流动性水平;短期累计涨跌幅可以帮助模型识别反转或动量特征;长期成交活跃度和价格水平则可能间接反映股票市值和投资者结构。
这意味着,网络并不需要显式读取风格因子,也可以从原始量价数据中还原出许多风格信息。模型越复杂,识别这些代理变量的能力可能越强。
(四)长期有效性
小市值、低波动、反转和低流动性并不是完全无效的风险来源。在某些市场阶段,它们确实能够带来较好的收益。但问题在于,这些收益具有明显的周期性和环境依赖,不能简单视作稳定的个股Alpha。
小市值收益通常受到市场风险偏好、资金风格、退市制度、并购重组环境和投资者结构影响。低波动策略在风险偏好下降时可能表现较好,但在强势成长或高Beta行情中可能落后。短期反转收益依赖交易执行效率,拥挤后容易快速衰减。低流动性收益则受到容量和成本限制,资金规模扩大后更难实现。
更重要的是,当大量模型使用相似的数据、相似的标签和相似的训练框架时,它们可能学到相近的风格偏好,形成策略拥挤。一旦市场环境变化,相关模型可能在同一方向上同时减仓或调仓,导致风格踩踏和收益回撤。
(一)设定
数据范围:沪深全市场
数据类型:多频量价数据、风格数据
训练标签:未来t+1日~t+21日vwap收益率
训练/验证集:2008.01.01~2019.12.31
测试集:2020.01.01~2026.07.17
训练方式:单次训练,无滚动
回测方式:t+1日vwap买入,t+1+n日vwap卖出
(二)与Barra风格因子相关性
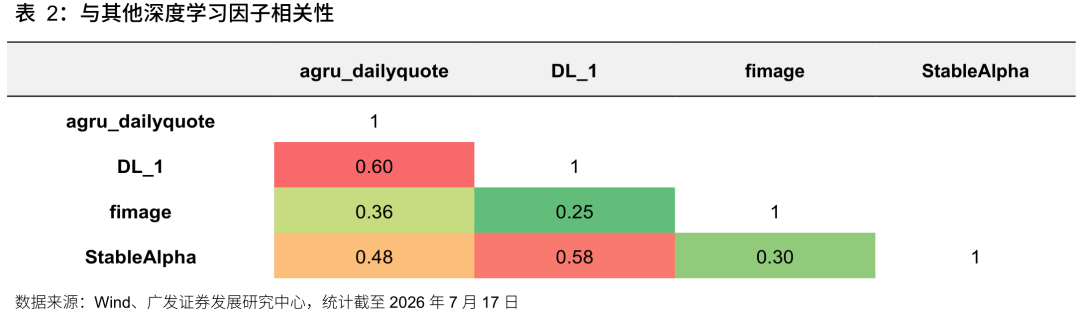
(三)与其他深度学习因子相关性
(四)月度 RankIC 指标
(五)周度 RankIC 指标
(六)指数增强表现



