你是否也有这样的困扰?"我的模型在训练集上100分,测试集上却只有60分?""我的神经网络训练了500轮还是不收敛?"
别慌!这些问题的根源往往在于两个关键技术:正则化和归一化。正则化就像严格的老师,防止学生死记硬背;归一化则是标准化的教材,让学习更高效。
正则化(Regularization)是什么?
正则化就像一个严格的老师,防止学生过度背书。
正则化的目的是
通过引入额外的约束或惩罚项来限制模型的复杂度,从而提高模型在未知数据上的泛化能力。
过拟合的学生不仅记住了知识点,连教材上的错别字、页码都背下来了;正则化后的学生只会记住核心知识,能举一反三。
如何实现正则化?正则化是通过重新定义损失函数来实现的。新的损失函数由两部分组成:原始的预测损失和一个正则化项。
正则化通过给损失函数"加料",在原有的预测误差基础上,再添加一个基于模型参数计算得出的惩罚项。
原来的损失函数,只看考试成绩;正则化后的损失函数,看考试成绩 + 惩罚项(防止死记硬背)。
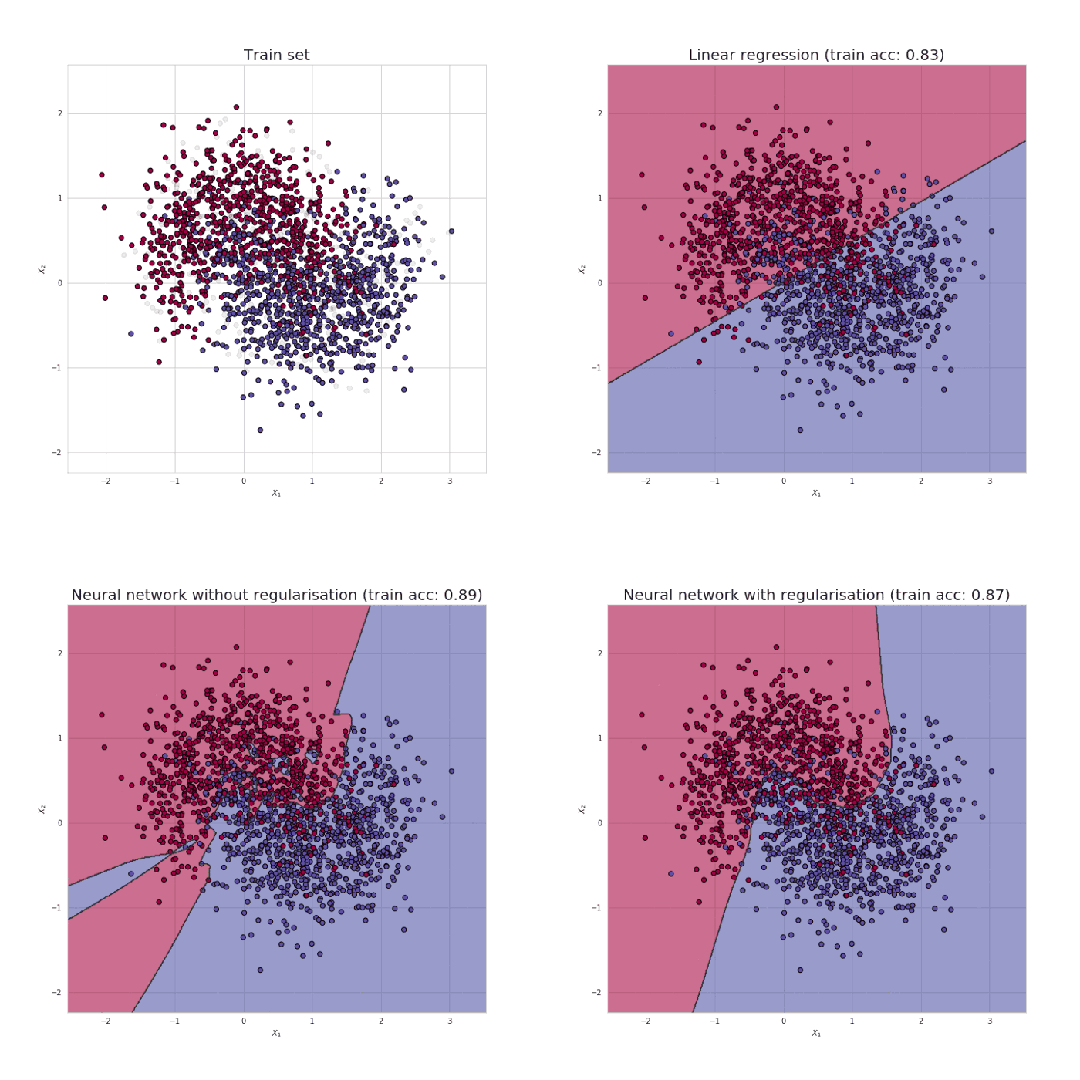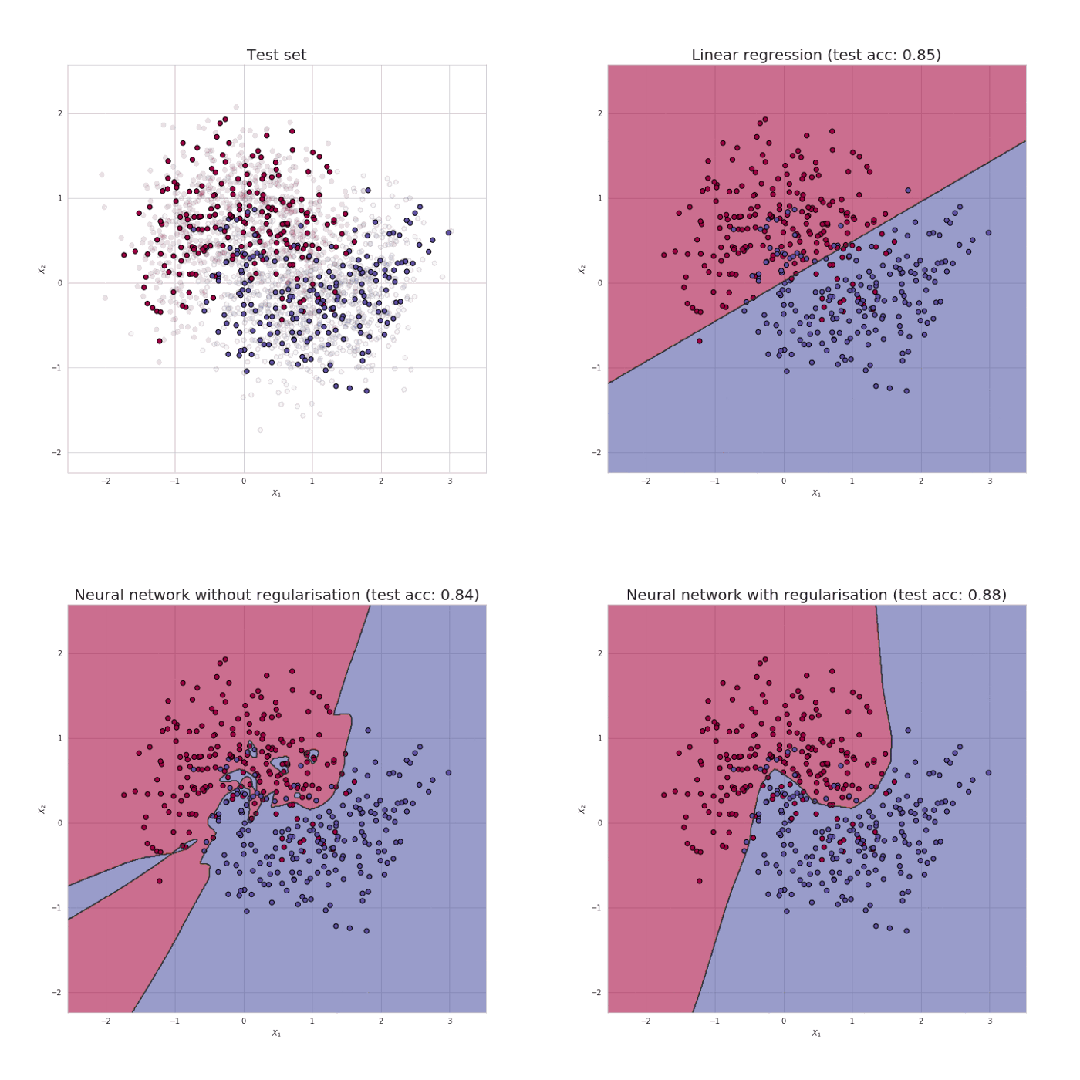
L1正则化和L2正则化是最主流的两种正则化技术,前者通过引入权重绝对值的约束来产生稀疏权重(许多权重为零),后者则通过权重平方和的惩罚来控制参数规模(保持权重值较小)。
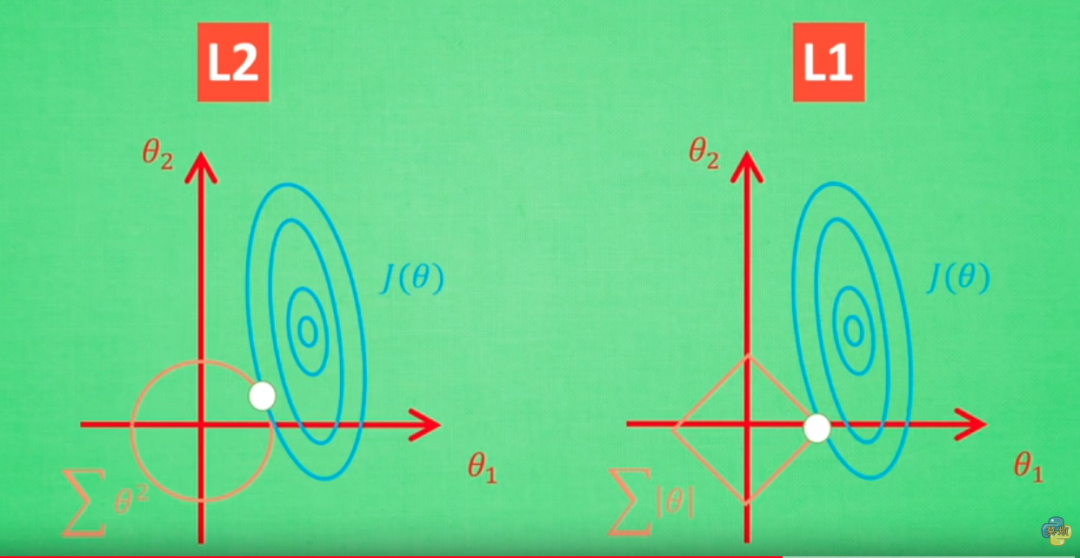
L1正则化(Lasso): "断舍离大师"
L1正则化在损失函数L中添加L1正则项,即模型参数绝对值之和作为惩罚项
喜欢把不重要的权重直接变成0,这样倾向于产生稀疏权重矩阵,即部分特征权重为零,有助于特征选择。
def l1_regularization(model, lambda_l1): l1_loss = 0 for param in model.parameters(): l1_loss += torch.norm(param, p=1) # 绝对值之和 return lambda_l1 * l1_loss
loss = criterion(outputs, labels) + l1_regularization(model, 0.001)
L2正则化(Ridge): "均衡发展者"
L2正则化则在损失函数L中添加L2正则项
,即模型参数平方和作为惩罚项。
让所有权重都保持在合理范围内,这样倾向于使模型权重均匀分布,有助于防止模型过于复杂,减少过拟合。
def l2_regularization(model, lambda_l2): l2_reg = torch.tensor(0.0) for param in model.parameters(): l2_reg += torch.norm(param, p=2) # 平方和 return lambda_l2 * l2_reg
loss = criterion(outputs, labels) + l2_regularization(model, 0.001)
归一化(Normalization)是什么?
归一化就像给所有数据穿上统一的校服,让它们在同一个"频道"上交流。
小明的身高:175cm,小红的体重:50kg,小李的年龄:20岁,直接比较毫无意义!归一化后,它们都变成了-1到1之间的数字,就能公平比较了。
这样当模型面对来自不同量纲的特征数据时,归一化能够将它们统一转换到相同的数值范围内,比如标准正态分布(均值0,标准差1)。通过这种统一化处理,让神经网络能够更均衡地学习各个特征的重要性。
归一化的过程是什么?
三步法把不同尺度的数据调整到相同标准
- 测量数据范围:找出最大值、最小值、平均值等
常用的归一化有哪些?
主要包括批量归一化(BN)、层归一化(LN)、实例归一化(IN)和组归一化(GN
)
批量归一化(Batch Normalization, BN):"班级统一标准"
看这个班级,这一批学生的平均分和分数分布,把所有分数调整到统一标准(平均0,标准差1)。最适合:图像处理任务。nn.Sequential( nn.Conv2d(3, 64, 3), nn.BatchNorm2d(64), nn.ReLU())
层归一化(Layer Normalization, LN):"个人标准化"
不看其他学生,只看自己各科成绩,把自己的各科成绩标准化。最适合: 文本处理、Transformer模型。class TransformerLayer(nn.Module): def __init__(self): super().__init__() self.ln1 = nn.LayerNorm(512) self.ln2 = nn.LayerNorm(512)
实例归一化(Instance Normalization, IN):"独立个体标准"
每个样本完全独立处理,适合每个样本都有独特风格的任务。最适合:
图像风格迁移、艺术生成。
style_transfer = nn.Sequential( nn.Conv2d(3, 128, 3), nn.InstanceNorm2d(128), nn.AdaptiveAvgPool2d(1))
组归一化(Group Normalization, GN):“小组标准化"
把特征分成几个小组,每个小组内部标准化。最适合: 医学图像分割、小batch训练。nn.Sequential( nn.Conv2d(64, 128, 3), nn.GroupNorm(4, 128), nn.LeakyReLU())



