

龙哥推荐理由:
这篇论文简直是对深度学习"玄学"的当头一棒!用最简单的聚类算法,居然在LiDAR全景分割任务上吊打了一众需要大量标注数据和GPU训练的深度学习模型。这不仅大幅降低了自动驾驶技术的开发门槛,更让人重新思考:在某些领域,传统算法是否被我们低估了?🤔
原论文信息如下:
论文标题:
Clustering is back: Reaching state-of-the-art LiDAR instance segmentation without training
发表日期:
2025年03月
作者:
Corentin Sautier, Gilles Puy, Alexandre Boulch, Renaud Marlet, Vincent Lepetit
发表单位:
LIGM, Ecole des Ponts, Univ Gustave Eiffel, CNRS, France; Valeo.ai, France
原文链接:
https://arxiv.org/pdf/2503.13203v2
在自动驾驶领域,LiDAR点云的全景分割一直是个技术难题。传统方法需要大量的实例标注数据和复杂的深度学习模型,但今天要介绍的这项研究却反其道而行——用最简单的聚类算法,在多个标准数据集上超越了所有需要训练的方法!
更令人惊讶的是,这个方法不仅不需要任何实例标注,甚至不需要GPU,在单线程CPU上就能实时运行!😲告别实例标注!ALPINE实现无训练LiDAR全景分割新突破
ALPINE(A Light Panoptic INstance Extractor)的核心思想出奇地简单:将语义分割和传统聚类算法相结合,完全摒弃了复杂的实例分割头设计。
零实例标注需求:只需要语义分割标签,大大降低了数据标注成本
高效实时:在单线程CPU上实现实时处理
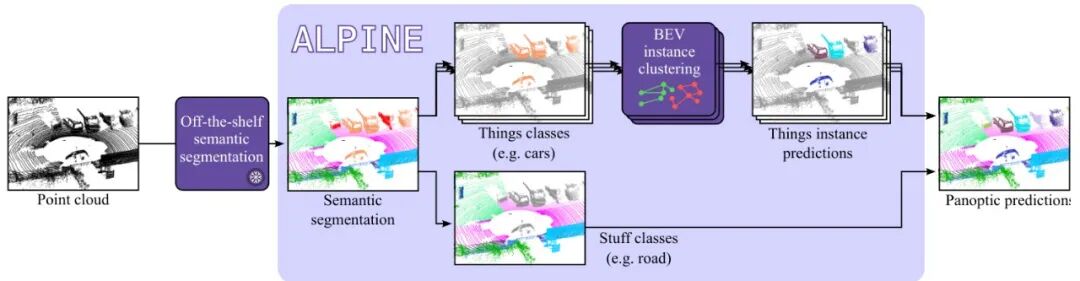
图3:ALPINE方法概述。在ALPINE中,我们取语义分割模型的输出,并在每个"物体"类别上应用聚类算法以获得实例掩码并形成全景预测
传统聚类算法为何重获新生
早期的LiDAR全景分割方法确实尝试过使用无监督聚类算法,但效果不尽如人意。为什么现在聚类算法又能重新崛起?
关键在于现代高性能语义分割网络的出现!随着语义分割精度的显著提升,为后续的聚类算法提供了更加准确的基础。
ALPINE在LESS和RBNN等经典图聚类方法的基础上进行了关键改进:
复杂度优化:将算法复杂度从O(n²)降低到O(nk log n),更好地适应大规模点云
BEV投影:利用物体在垂直方向很少堆叠的特性,在鸟瞰图空间进行处理
类别特定阈值:为每个语义类别设置独立的连接阈值
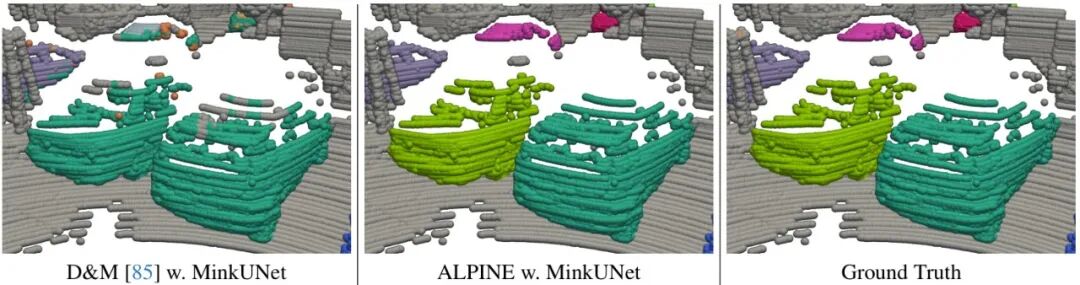
图2:在SemanticKITTI上的实例预测示例。展示了D&M和ALPINE在汽车类别上的结果对比。两种方法都是无需训练的聚类方法,并使用相同的MinkUNet获得逐点语义预测。与真实标签相比,D&M不能令人满意地分离汽车,而ALPINE能正确分割它们
ALPINE核心方法解析:从BEV投影到框分割
ALPINE的聚类过程包含四个主要步骤,让我们一步步来解析:
首先,ALPINE对每个"物体"类别进行独立处理。这意味着汽车、行人、自行车等不同类别的点云会被分开处理,避免了类别间的混淆。
BEV(Bird's Eye View,鸟瞰图)投影是ALPINE的关键创新之一。通过将3D点云投影到(x,y)平面,充分利用了现实世界中物体很少在垂直方向堆叠的特性。
这不仅简化了计算,还避免了因垂直方向点云稀疏性带来的分割问题。
对于每个点,ALPINE找到其在BEV空间中的k个最近邻(通常k=32),构建一个有向图。如果两点之间的距离超过类别特定阈值,就移除它们之间的连接。
这个步骤的复杂度是O(nk log n),相比传统方法的O(n²)有了显著优化。
最后,通过在构建的图中识别连通分量来获得聚类结果。每个连通分量对应一个不同的实例索引。图1:ALPINE聚类过程。对于给定的语义类别:a) 我们将点投影到BEV空间(图中为可视化目的进行了下采样),b) 构建k近邻图并按边长度过滤,c) 提取连通分量
为了进一步提升分割质量,ALPINE引入了框分割策略。当一个聚类不能放入该类别参考边界框时(考虑30%的容差),很可能是包含了多个实例。
此时,框分割方法会在阈值参数上进行二分搜索,递归地找到所有能放入参考边界框的最大子聚类。图4:边界框分割示例。在上面的例子中,两辆汽车停靠得很近。虽然聚类将它们合并,但它们不能放入一个汽车框内,因此该聚类被分割。在下面的例子中,相同的机制应用于公交候车亭中的两个行人。为说明目的,框以3D显示,但该机制纯粹是二维的
无需调参!基于网络搜索的尺寸参数设定
ALPINE最令人惊叹的特性之一是完全无需手动调参!所有参数都可以通过网络搜索获得,不需要任何标注数据。
对于每个语义类别,ALPINE只需要该类别物体的平均尺寸估计。这些信息可以通过简单的网络搜索获得:
这种参数化方法还解决了在不同国家训练和测试时的领域偏移问题。只需要根据目标国家的物体平均尺寸调整几个标量参数,就能实现简单的领域自适应。实验证明,使用网络搜索获得的参数与使用数据集真实统计信息获得的参数在性能上几乎没有差异。这意味着ALPINE的参数既容易设置,又有明确的意义,而且完全不需要标注!三大主流数据集实验结果全面领先
ALPINE在三大主流LiDAR数据集上的表现简直让人瞠目结舌!在SemanticKITTI、nuScenes和SemanticPOSS这三个权威基准测试中,这个无需训练的方法竟然全面超越了需要大量标注数据的深度学习模型表1:SemanticKITTI验证集上的全景分割结果。主要指标是PQ,ALPINE在使用MinkUNet语义分割时达到64.2,超越了大多数需要实例标注的方法
在SemanticKITTI数据集上,ALPINE结合不同的语义分割骨干网络都表现出色。使用MinkUNet时PQ达到64.2,使用WaffleIron-256时达到64.2,甚至超过了需要复杂训练的端到端方法PUPS。更令人惊讶的是,当使用测试时增强和模型集成时,ALPINE的PQ进一步提升到65.9,在这个竞争激烈的数据集上名列前茅。表2:nuScenes验证集上的全景分割结果。ALPINE在使用PTv3和WaffleIron-768时分别达到78.9和76.9的PQ,仅次于使用多任务训练的LidarMultiNet
nuScenes数据集上的结果同样令人印象深刻。ALPINE在使用PTv3语义分割时PQ达到78.9,仅落后于使用了目标检测和语义分割联合训练的LidarMultiNet。考虑到ALPINE完全不需要实例标注,这个成绩可以说是相当惊人。表3:SemanticPOSS验证集上的全景分割结果。ALPINE在使用PTv3时达到51.4的PQ,在该数据集上达到最先进水平
在专注于动态物体的SemanticPOSS数据集上,ALPINE同样表现出色。使用PTv3语义分割时PQ达到51.4,超越了该数据集上其他所有方法。这个结果特别有意义,因为SemanticPOSS专注于包含大量动态物体的场景,验证了ALPINE在实际复杂环境中的鲁棒性。ALPINE vs 其他实例头方法:性能与效率的双重胜利
为了全面评估ALPINE的实力,研究人员进行了一项巧妙的实验:将其他全景分割方法的语义预测提取出来,然后用ALPINE替换它们的实例分割头,在完全相同的语义基础上进行比较。表5:ALPINE与其他方法实例分割能力对比。在相同的语义预测基础上,ALPINE的实例分割性能超越了所有其他方法
结果令人震惊!在SemanticKITTI验证集上,ALPINE在相同的语义预测基础上,实例分割性能超越了所有其他方法。无论是DS-Net、Panoptic-PolarNet还是MaskPLS,当使用ALPINE作为实例分割头时,PQ指标都有所提升。
更令人难以置信的是效率对比。ALPINE在单线程CPU上就能实现实时处理,而其他方法大多需要GPU加速。从表5中的FPS数据可以看出,ALPINE的处理速度远超其他方法,这在自动驾驶等实时应用中具有巨大优势。
这项实验充分证明:实例分割并不需要复杂的设计、训练或实例标注就能达到竞争性水平。ALPINE提供了一个简单而强大的基线,未来方法必须超越它才能证明其设计的真正价值。
消融实验揭示关键模块贡献度
为了理解ALPINE各个组件的贡献,研究人员在nuScenes验证集上进行了详细的消融实验。结果清晰地展示了每个创新点的价值。表9:不同聚类组件的消融研究。BEV投影和框分割策略分别贡献了0.6和0.8个PQ点的提升,组合使用提升2.6个点
BEV投影是ALPINE的关键创新之一。实验显示,在BEV空间构建图相比在3D空间能提升0.6个PQ点。这验证了利用物体在垂直方向很少堆叠的特性确实能改善分割效果。
框分割策略同样贡献显著,单独使用能提升0.8个PQ点。当两个模块结合使用时,提升效果达到2.6个PQ点,证明了这两个设计的协同效应。
研究人员还测试了使用随距离变化的阈值策略,这是LESS方法中使用的技术。然而在ALPINE的框架下,使用基于物体典型尺寸的恒定阈值反而效果更好,这进一步证明了ALPINE参数设置的合理性。图5:邻居数量k对性能的影响。当k达到32后,性能基本稳定,说明算法对k的选择不敏感
邻居数量k的选择也被深入研究。实验发现当k达到32后,性能基本稳定,在k=32和k=64之间几乎没有差异。这说明ALPINE对超参数的选择相当鲁棒,距离过远的邻居连接会被阈值过滤掉,不会影响最终结果。聚类方法对比:ALPINE的绝对优势
为了证明ALPINE的优越性,研究人员将其与多种经典聚类方法进行了直接对比,包括专门为LiDAR设计的D&M方法以及通用的DBSCAN和HDBSCAN。表6:聚类方法在SemanticKITTI上的PQ和计算时间对比。ALPINE在精度和速度上都显著优于其他方法
结果令人震撼!ALPINE以65.5的PQ和14.4Hz的处理速度全面领先。相比之下,专门为LiDAR设计的D&M方法只有61.8的PQ和0.5Hz的速度。通用的DBSCAN和HDBSCAN表现更差,分别只有56.7和55.1的PQ。
ALPINE相比D&M有3.7个PQ点的巨大优势,如果启用框分割功能,还能再提升0.4个点。在实时性方面,ALPINE的14.4Hz远超SemanticKITTI的10Hz采集频率,意味着它完全能满足实时处理需求。
研究人员还与完全无监督的实例分割方法3DUIS和UNIT进行了对比。这些方法不依赖任何语义信息,任务更加困难。虽然它们表现不错,几乎达到了D&M的水平,但ALPINE仍然以65.9的PQ显著领先,证明了语义信息在实例分割中的重要性。表7:与无语义实例分割方法的对比。ALPINE显著优于完全不使用语义信息的方法
语义分割仍是提升关键
为了探索LiDAR全景分割的未来发展方向,研究人员设计了一个巧妙的oracle实验,分别评估了语义分割和实例分割的改进潜力。表8:nuScenes验证集上的oracle结果。语义oracle将PQ提升到96.2,而实例oracle只提升4.3个点
结果令人深思!当使用完美的语义分割(语义oracle)时,nuScenes上的PQ飙升至96.2,在SemanticKITTI上甚至达到99.0。相比之下,使用完美的实例分割(实例oracle)只能将PQ提升4.3个点。
这个发现表明,在当前的LiDAR全景分割任务中,实例分割已经相对饱和,而语义分割仍有巨大的改进空间。这也解释了为什么ALPINE能够如此成功——它充分利用了现代高性能语义分割网络的优势。
研究人员还测试了不同参数设置的影响,比较了基于网络搜索的参数和基于数据集统计的参数。结果显示两者性能几乎相同,这进一步证明了ALPINE参数设置的合理性和实用性。表10:基于统计和基于网络的参数设置对比。两种设置结果非常相似,证明ALPINE参数易于设置且不需要标注未来展望:无标注学习的潜力与挑战
ALPINE的成功为LiDAR全景分割领域带来了深刻的启示。这项研究证明,达到最先进的全景分割并不需要端到端网络或全景标注。早期将语义分割和无监督聚类结合的流水线就足够了,只要使用现代高性能语义分割网络和经过精心设计的聚类算法。
oracle实验结果强烈表明,全景标注要么不是必需的,要么没有被当前的方法充分利用。这鼓励研究社区要么更专注于语义分割,要么探索如何更好地利用实例标注。
ALPINE也存在一些局限性。由于每个类别使用单一固定阈值,当两个物体距离小于所选阈值时可能无法正确分割。随着LiDAR角分辨率的提高和点密度的增加,这个限制有望自然解决。
这项工作的实际影响是深远的:不再需要繁琐的实例标注,架构更加简化,方法可以即插即用地应用于任何语义预测,而且由于聚类算法极快,可以在自动驾驶车辆上实现高频全景分割。
研究人员已经发布了代码,可以集成到任何语义分割骨干网络中用于全景分割。这为整个社区提供了一个强大的基线,未来方法必须超越ALPINE才能证明其设计的真正价值。
![]()

📚 AI论文读得慢、抓不住重点?想要更多深度算法剖析与行业视角?
【龙哥读论文】知识星球,助你高效突破科研瓶颈,前沿研究一手掌握!
🔥 每日AI资讯速递——政策风向、技术趋势、行业动态,快速锁定关键信息!
🔥 AI前沿论文每日精拆——核心方法、实验结论、优缺点剖析、研究启发,四大维度深度解读,节省80%读论文时间!
🔥 30+细分领域精准分类——图像增强/恢复/调光、视频生成、自动驾驶、机器人、大语言模型、强化学习、Agent、3D渲染、AI医疗、图像配准、涨点神器、模型架构/训练/优化、AI金融、AI咨询、高科技岗位招聘……定向阅读,高效匹配你的研究方向!
🔥 定期论文趋势总结——分领域梳理最新成果与突破,横纵对比前沿进展,节省90%对比实验时间!
🔥 直击疑难,与大咖对话——向龙哥、行业教授、领域专家直接提问,每周优先解答,关键困惑快速突破!
🔥 AI招聘/招博信息每日速达——第一时间获取岗位与深造机会,快人一步,抢占先机!
📌 加入【龙哥读论文】,一起站上AI研究与创新的最前沿!
扫描上方二维码领180元券,用后仅
79元/年(原价259元),
仅25张,限期两周发放,超过马上失效!赶快
扫描上方二维码加入吧!,从此告别“论文焦虑”,专注核心研究!!!
欢迎加入龙哥读论文粉丝群,添加龙哥助手微信号加群:kangjinlonghelper。一定要备注:研究方向+地点+学校/公司+昵称(如 图像处理+上海+清华+龙哥),根据格式备注,可更快被通过且邀请进群。






