来源丨经授权转自轩辕的编程宇宙(ID:xuanyuancoding)
作者丨轩辕之风
大家好,我是轩辕。
最近 GitHub 上有个叫 REA 的项目特别火,今年 4 月 14 号才创建,到现在不到半年,star 已经 4.8 万了。
全名叫做 Reverse Engineer Anything,就是"逆向任何东西"。
它干的事情说起来挺简单:你把一个没有源码的程序交给 AI 智能体,让它自己去研究这个程序是怎么工作的,研究明白了,还能照着给你写一个类似的。
不出所料,一堆根本没干过逆向的人又在喊天塌了地陷了。
今天就来聊聊它是干什么的,怎么工作的,怎么用,最后说说我对逆向行业和软件行业的一些看法。
REA 到底是什么
REA 本质上是一个 MCP 服务器,再加一套命令行。
MCP 就是让 AI 智能体调用外部工具的接口,Claude Code、Codex、Cursor、Gemini CLI 这些都支持。
REA 做的事情,就是把一大堆逆向工具包装成智能体能直接调用的工具。
这样你就不用自己去学习使用那些专门的逆向工具了,直接跟智能体说话就行。
它能分析的东西挺多的,我挑几类主要的讲讲。
1. 原生二进制
就是 exe、Mach-O、ELF 这类编译好的程序。
能拿到伪代码、汇编、字符串、符号,还有函数之间的调用和引用关系。
底层需要装 Hopper、Ghidra、IDA 里的一个,REA 自己并不造反编译器。
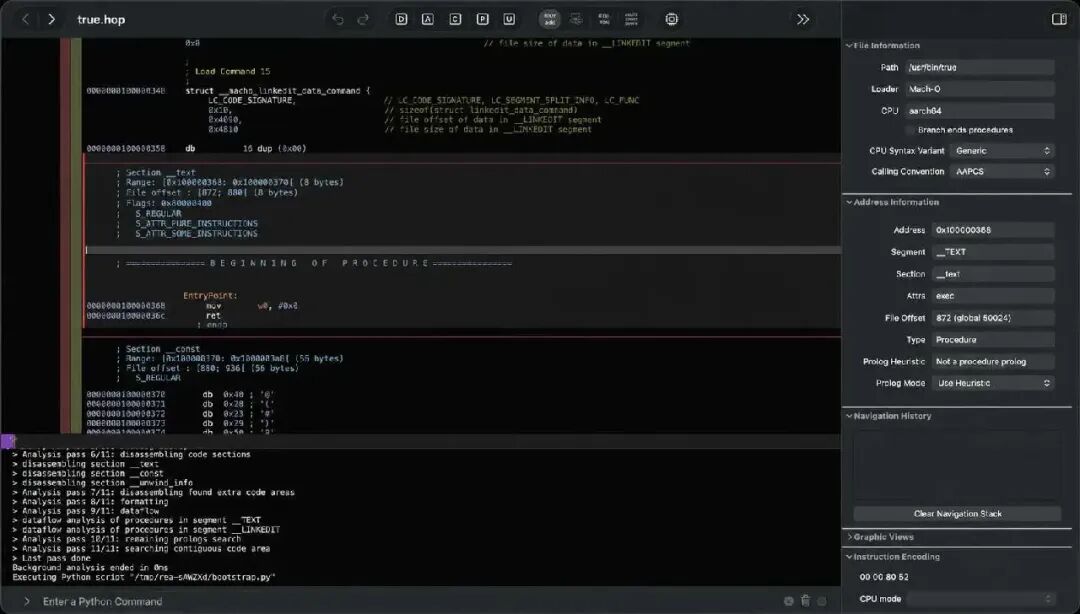
这是官方放出来的截图,REA 在 Hopper 里分析 macOS 的 /usr/bin/true。
你看底部那几行,它在 Hopper 里跑了一个
bootstrap.py,REA 就是靠这种方式去驱动 Hopper 的。
2. JavaScript 和 Electron 应用
能还原出模块、导入关系、source map、路由、IPC 通信,还有原生插件之间的关系。
只要装了 Node.js 就能跑,不需要任何逆向引擎,所以这是上手门槛最低的一项。
3. 网站
页面结构、脚本、网络请求,还可以截图,需要一个 Chrome 系的浏览器。
4. Android APK、.NET 程序集、固件
APK 需要装 JADX 和 JDK,能看清单文件、类和反编译后的方法。
.NET 是纯静态分析,什么都不用装。
固件靠 Binwalk 或者 Unblob 来拆。
除此之外还有以太坊的 EVM 字节码、进程行为捕获等等,官方的支持列表很长。
我把它的命令行帮助看了一遍,命令多得一屏根本翻不完,光 inspect- 开头的就有一长串。
它是怎么工作的
整个流程画出来是这样的。
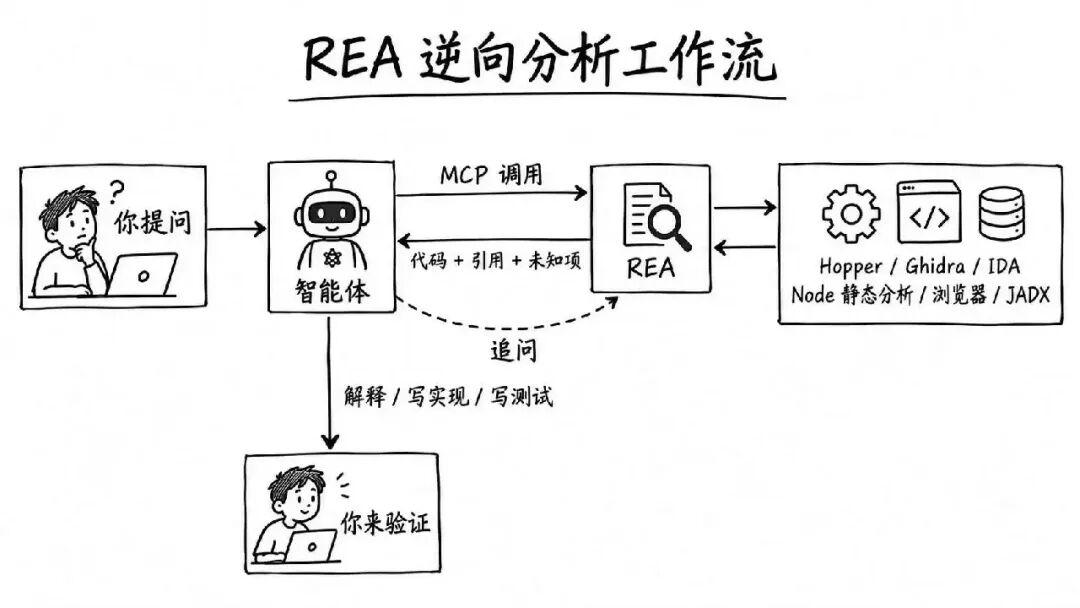
需要说明的是,REA 自己是不做推理的。
真正在思考的是你的智能体,比如该看哪个函数、下一步查什么、最后得出什么结论。
REA 只管按智能体的要求,去调 Hopper、Ghidra 这些工具,再把结果拿回来。
我翻了一下它的架构图,最上面是命令行和 MCP 两个入口,共用同一套逻辑。
中间是各种适配器。Hopper 那边是一个跑在 Hopper 里面的 Python 脚本,Ghidra 是一个打包好的 Java 无头脚本,IDA 则是通过外部的 ida-pro-mcp 接进来的。
最底下还有一层纯函数,专门处理证据和对比,不带任何副作用。
光看流程图可能还是有点抽象,我拿官网上的一个例子,带大家看看一次完整的调查是怎么走下来的。
1996 年有个 Windows 游戏叫 DX-Ball,就是打砖块。球打中砖块的时候,声音会根据砖块的位置,在左右声道之间偏一下。
有人想知道,这个偏移值到底是怎么算出来的。
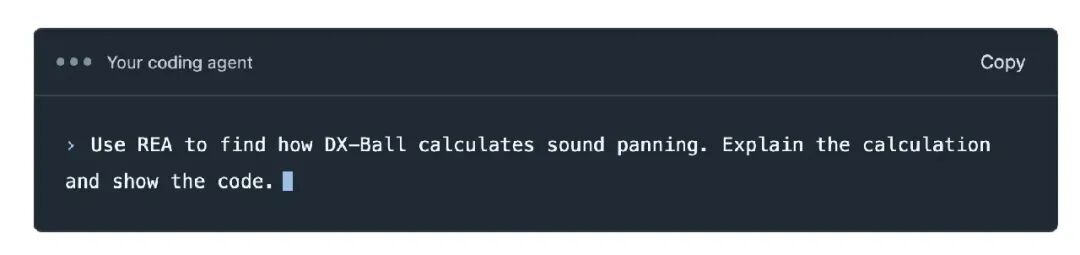
研究者问智能体的话很朴素:用 REA 查一下 DX-Ball 怎么计算声音平衡,解释一下算法,把代码给我。
智能体先找到那个函数,看反编译出来的伪代码,结果整个函数只剩一个孤零零的 __ftol() 调用,输入参数没了。
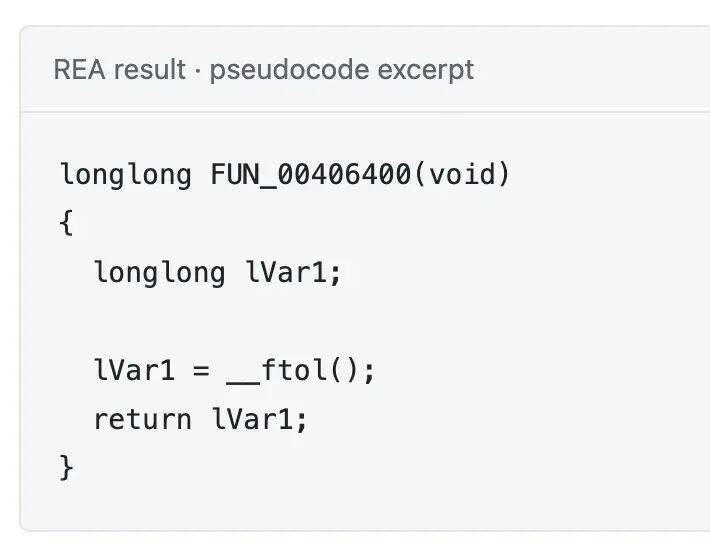
这种情况老逆向应该都见过,反编译器没还原出来,就得回头去看汇编。
然后它去看汇编,发现有一条
FILD 指令,原来输入是从栈上读进来的整数参数,只是反编译器把它丢了。
接着它往回追,找到调用这个函数的地方,发现传进来的是砖块的横坐标,算法是 20 + 30 × 列号。
函数里还乘了一个常数,减了一个常数,再乘一个缩放系数。
这些数都放在内存里,智能体通过 REA 把对应地址的字节读出来,解码成浮点数,分别是 1.5625、500.0,还有一个运行时才确定的缩放值。
最后它把这些拼在一起,写成一个 C 函数:把屏幕上 0 到 640 的横坐标,映射成 -500 到 500 的声道平衡值。
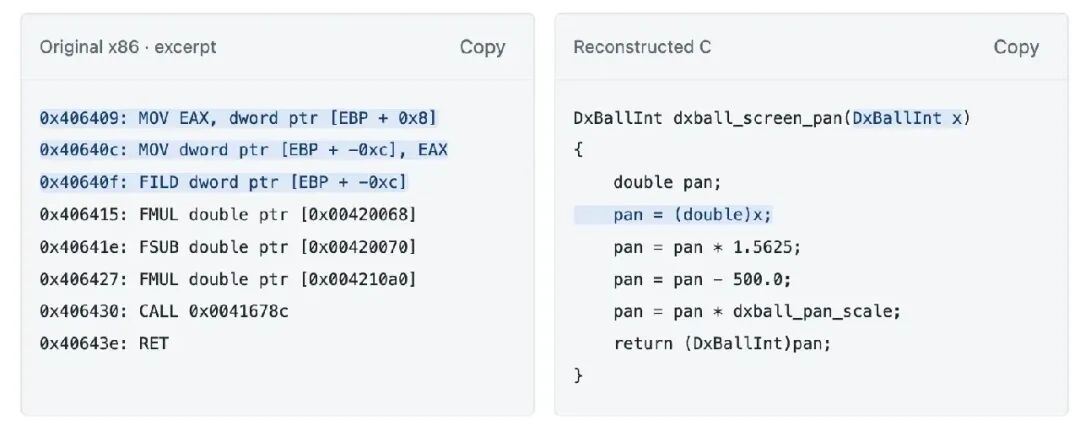
这套流程里的每一步单拎出来都不难。
麻烦的是得来回切换,反复查,还得一直记着上一步看到了什么。
而这种活,恰好是智能体干起来最顺手的。
怎么用
安装只要一行命令,前提是电脑上有 Node.js,版本要 22.19 以上,或者 24.11 以上,或者 26 以上。
npx rea-agents setup
它会让你选要接入哪些智能体,然后把准备做的改动列出来,你确认了才会动手。
改动包括注册 REA 的 MCP 服务器,装上配套的工作流指令,原来的配置会先备份。
支持 Claude Code、Codex、Cursor、Gemini CLI、Grok Build 这些。
装完重启一下智能体,就可以直接用大白话问了。
如果只想在终端里玩,可以拿一个解压好的 Electron 应用目录,或者 asar 包试试:
npx -y rea-agents@latest analyze-javascript-application /absolute/path/to/app --json
想长期用的话,就全局装一下:
npm install --global rea-agents
rea --help
升级用 rea update。官方也提醒了,这个项目更新太快,遇到 bug 先升级再说。
有几个坑我提前说一下。
分析原生二进制之前,得先把 Hopper、Ghidra、IDA 其中一个配好。
setup 可以在你同意之后帮你装 Hopper,Ghidra 和 IDA 就用你自己装好的。
macOS 上第一次启动 Hopper 会弹个窗,让你选试用模式还是输入许可证。
遇到大一点的二进制,Ghidra 启动会比较慢,可以把 REA_GHIDRA_STARTUP_TIMEOUT_MS 这个超时调大。
都配好之后,跑一下 rea doctor,可以检查环境有没有问题。
还有隐私的问题。
REA 的分析是在本地跑的,不会把你的目标程序传到哪里去。
但你的智能体会拿到分析结果,这些结果会发给背后的模型服务商,他们怎么处理数据,要看各家自己的政策。
官方放的几个案例
官方放了好几个案例,我挑三个讲讲,大概按厉害程度排的。
1. Notion:追踪剪贴板
Notion 是个 Electron 应用,复制一段内容的时候,富文本格式是怎么保存的?
REA 先找到渲染进程里调用剪贴板的 API,顺着预加载脚本,一路追到 IPC 通信,最后到主进程里。
JavaScript 本来就是明文打包的,所以这个案例整体比较轻松。
2. Aegis Authenticator:验证码怎么算出来的
这是一个安卓上的两步验证 App。
案例里让智能体去追踪生成六位验证码的方法,找到规则之后,还拨了一个演示用的时钟,直观地看到验证码为什么每 30 秒变一次。
3. DX-Ball:63 个字节一个不差
就是前面那个打砖块。
智能体还原出 C 函数之后,官方又做了两层验证。
第一层,拿原版的 x86 函数和还原出来的 C 版本比,0 到 640 的每个位置,配上五种缩放系数,一共 3205 个测试用例,结果全部一致。
第二层我觉得更狠。用当年的 VC 4.0 编译器把还原出来的 C 代码重新编译一遍,生成的 63 个字节机器码,和原程序里的完全一样。
这已经不是"看起来差不多"了,是真的还原到了编译器输出的级别。
另外还有个 CTF 的案例,DownUnderCTF 的一道验 flag 的题,REA 找到校验函数,把里面一堆掩码和求和翻译成了方程。
对逆向行业的冲击
先说逆向这一行。
我觉得最先被冲击的,是入门那一层。
追调用链、读常量、把汇编翻成 C,这些最费时间的活,现在智能体都能干了。
CTF 里的逆向题,还原一个小算法,这些以前是新手练手、攒经验的地方,上面 DownUnderCTF 那个案例就是个例子。
但我不觉得老手会因此被替代。
智能体说得对不对,终归得有人来判断。
你看 DX-Ball 那个案例,最值钱的其实不是还原出了代码,而是后面的验证,3205 个测试用例加字节级的比对,那是人设计出来的。
以后逆向工程师的活,可能更多是设计验证、审核结论,而不是自己一行一行翻汇编。
攻防这边也在变。
今年 5 月底 arXiv 上有篇论文,专门研究怎么攻击用大模型做逆向分析的系统,目标就是 GhidraMCP 这一类工具。
做法是往反编译出来的代码里,塞一些多余的字符串变量赋值,用遗传算法生成提示词,把隐蔽的指令混进去,让大模型的分析被带偏。
程序本身的功能一点不受影响。
以前恶意软件对付的是人类逆向工程师,以后还得考虑怎么对付智能体。
反过来,往二进制里"下毒"骗智能体,大概也会变成一门新的手艺。
对软件行业的冲击
我觉得对软件行业的影响,比对逆向行业本身还要大。
REA 的 README 里有那么一句:看到喜欢的功能,弄明白它怎么实现的,再给自己的项目做一个。
换个角度想,意思就是别人家的功能,复刻起来会比以前容易很多。
尤其是 Electron 应用。
asar 其实就是个归档文件,没加密,Notion 那个案例就是从渲染进程一路追到主进程的。
现在很多桌面软件都是 Electron 做的,像我们常用的Claude Code、ChatGPT Agent都是。
未来,软件想要防破解、防止被复刻的难度越来越大了。
最后还想说几句
聊了这么多,也得说说我的保留意见。
官方展示的案例,都是项目方自己挑的。
DX-Ball 那个函数才 63 个字节。
真实的商业软件动辄几百万行代码,还有加壳、混淆、反调试,REA 能不能啃得动,我没测过,官方案例里也没展示。
所以别看 star 多就觉得它无所不能,star 多只能说明热闹。
这两天也看到有人在喊,逆向行业要完了,软件行业要完了。
我觉得大可不必。
REA 现在的能力,主要还是静态分析,靠 Hopper、Ghidra、IDA 把代码读出来,再交给智能体去分析。
WinDbg、x64dbg、GDB 这些实时调试器,目前还没有支持,而这也是逆向分析中难度最大的部分。
GDB 倒是出现过,但只是在分析已经记录下来的 Linux 崩溃转储时可选用,没法挂到一个正在运行的程序上下断点、单步。
它有运行时捕获,抓的是终端输出、交互过程、文件系统变化这类行为层面的东西,跟盯着寄存器和内存一步步跟是两回事。
可真实的逆向工作,很多时候离不开动态调试。
脱壳、绕反调试、跟踪运行时才生成的密钥、分析只在内存里解开的代码,都得靠调试器。
加了壳的程序,只做静态分析,看到的基本就是一堆壳代码。
这些恰好是现在的 REA 最弱的地方,也是逆向里最考功夫的部分。
当然,看他们的规划图,后面也会把调试器接进来。
不过实时调试要处理断点、反调试对抗、状态同步,比读静态代码麻烦得多,消耗的token量也不是一个量级。
尤其是处理LLVM、VMP等领域的逆向,难度会更大,它可以成为一个加速的工具,但想要完全取代逆向工程师现阶段还做不到。
好了,今天就分享到这里。
如果觉得还不错的话,求个点赞。
1、17年前的刷机神机,今天终于把苹果iOS也装上了
2、Linux之父坚持用ECC:电脑稳定性不能只看CPU
3、VS Code 再次倒戈!正式切到 Vite+!
4、正则做不到的事,它在1962年就做到了——用32KB
5、如果没有70年代,这些计算机技术可能不会存在