每个程序员都用过 git clone。敲下回车,几秒钟后,一个完整的代码仓库就躺在硬盘上了。
但数据库呢?
想给测试环境搞一份生产数据的副本?传统方案是 pg_dump + pg_restore。一个 100GB 的库,喝杯咖啡回来可能还没完。想做并行测试?再等一轮。想给 AI Agent 一个可以随便折腾的沙盒?那得准备好足够的磁盘和耐心。
最近一堆数据库公司都在卷 "Git for Data",理由是:有了数据版本控制,Agent 就可以放心在数据库里乱搞,坏了随时回滚。
但这玩意,PostgreSQL 其实早就有了。
只不过 PostgreSQL 18 把它提升到了一个新阶段:一个 100GB 的数据库,克隆时间从"分钟级"变成了 200 毫秒。不是快了一点,是快了几百倍。更神奇的是,克隆完的数据库不占用额外存储空间。1TB、10TB 的库?一样是 200 毫秒,一样零额外开销。
这不是魔法,是写时复制(Copy-on-Write) 技术终于被 PostgreSQL 原生支持了。 今天我们就来聊聊这个特性,以及它对整个"数据版本控制"生态意味着什么。
写时复制:为什么能这么快?
PostgreSQL 18 新增了一个参数 file_copy_method,可选值为 copy(传统字节拷贝)和 clone(基于 reflink 的瞬间克隆)。
设置 file_copy_method = clone 后执行:
CREATE DATABASE db_clone TEMPLATE db STRATEGY FILE_COPY;
PostgreSQL 会调用操作系统的 reflink 接口。Linux 上是 FICLONE ioctl,macOS 上是 copyfile()。
关键来了:文件系统不会真的复制数据。
它只是创建一组新的元数据指针,指向相同的物理磁盘块。就像你在文件管理器里创建了一个"快捷方式",但这个快捷方式可以独立修改。
没有数据移动,只有元数据操作。 所以无论数据库是 1GB 还是 1TB,克隆时间都是常数级的 —— 在现代 NVMe SSD 上,老冯测试 120GB 的库复制大约 200 毫秒。797G 的数据复制大概 569 毫秒左右。
写时复制:为什么不占空间?
克隆后,源库和新库共享所有物理存储。当任意一方修改某个数据页时,文件系统才会把这个页复制出来单独存储:
这意味着:存储开销 = 实际变更量,而不是完整副本。
你可以同时跑 10 个克隆库做并行测试,只要它们不大量写入,存储几乎不增长。对测试环境来说,这是巨大的福音。
不过,不是所有文件系统都支持 reflink。好消息是,大多数现代 Linux 发行版已经默认启用:
如果你用的是 EL 8/9/10、Debian 11/12/13、Ubuntu 20.04/22.04/24.04 等主流发行版,默认的 XFS 都已经支持并启用 reflink。
还在用 CentOS 7.9 和 ext4?那确实就没办法了,早点升级吧。
关键限制:模板库不能有连接
这个功能虽然好,有一个绕不开的限制:克隆时,模板数据库不能有任何活动连接。 原因很直接:PostgreSQL 需要确保克隆时数据处于一致状态。如果有连接在跑,可能产生写入,数据就不一致了。
这个限制其实一直都有。以前它很致命 —— 你不可能让生产库停机几分钟等复制完成。但现在克隆只要亚秒级常数时间,这个限制的杀伤力大大降低了。 百毫秒级别的闪断,对于很多场景是可以接受的,特别是那些 AI Agent 使用的库——它们没那么娇气。这就带来了许多新鲜的可能性。
实操的话,要想实际把这个数据库克隆出来,你需要先终止所有连接,在两条紧挨着 SQL 语句里执行:
psql <-EOF
SELECT pg_terminate_backend(pid) FROM pg_stat_activity WHERE datname = 'prod';
CREATE DATABASE dev TEMPLATE prod STRATEGY FILE_COPY;
EOF
请注意,这俩语句不能分开执行,但不能放在同一个事务里执行(CREATE DATABASE 不能在事务块内运行)。 所以你需要用 psql stdin 的方式来执行,用 psql -c 会自动包事务,反而会失败。
Pigsty 中的优化
在 Pigsty 4.0 中,添加了对 PG18 这种克隆机制的支持:
比如,你已经有了一个 meta 数据库,现在想创建一个 meta_dev 的克隆库用于测试, 只需要在 pg_databases 里添加一条记录,指定 template 和 strategy: FILE_COPY 即可。 然后执行:
bin/pgsql-db pg-meta meta_dev,Pigsty 会帮你自动处理好所有细节。
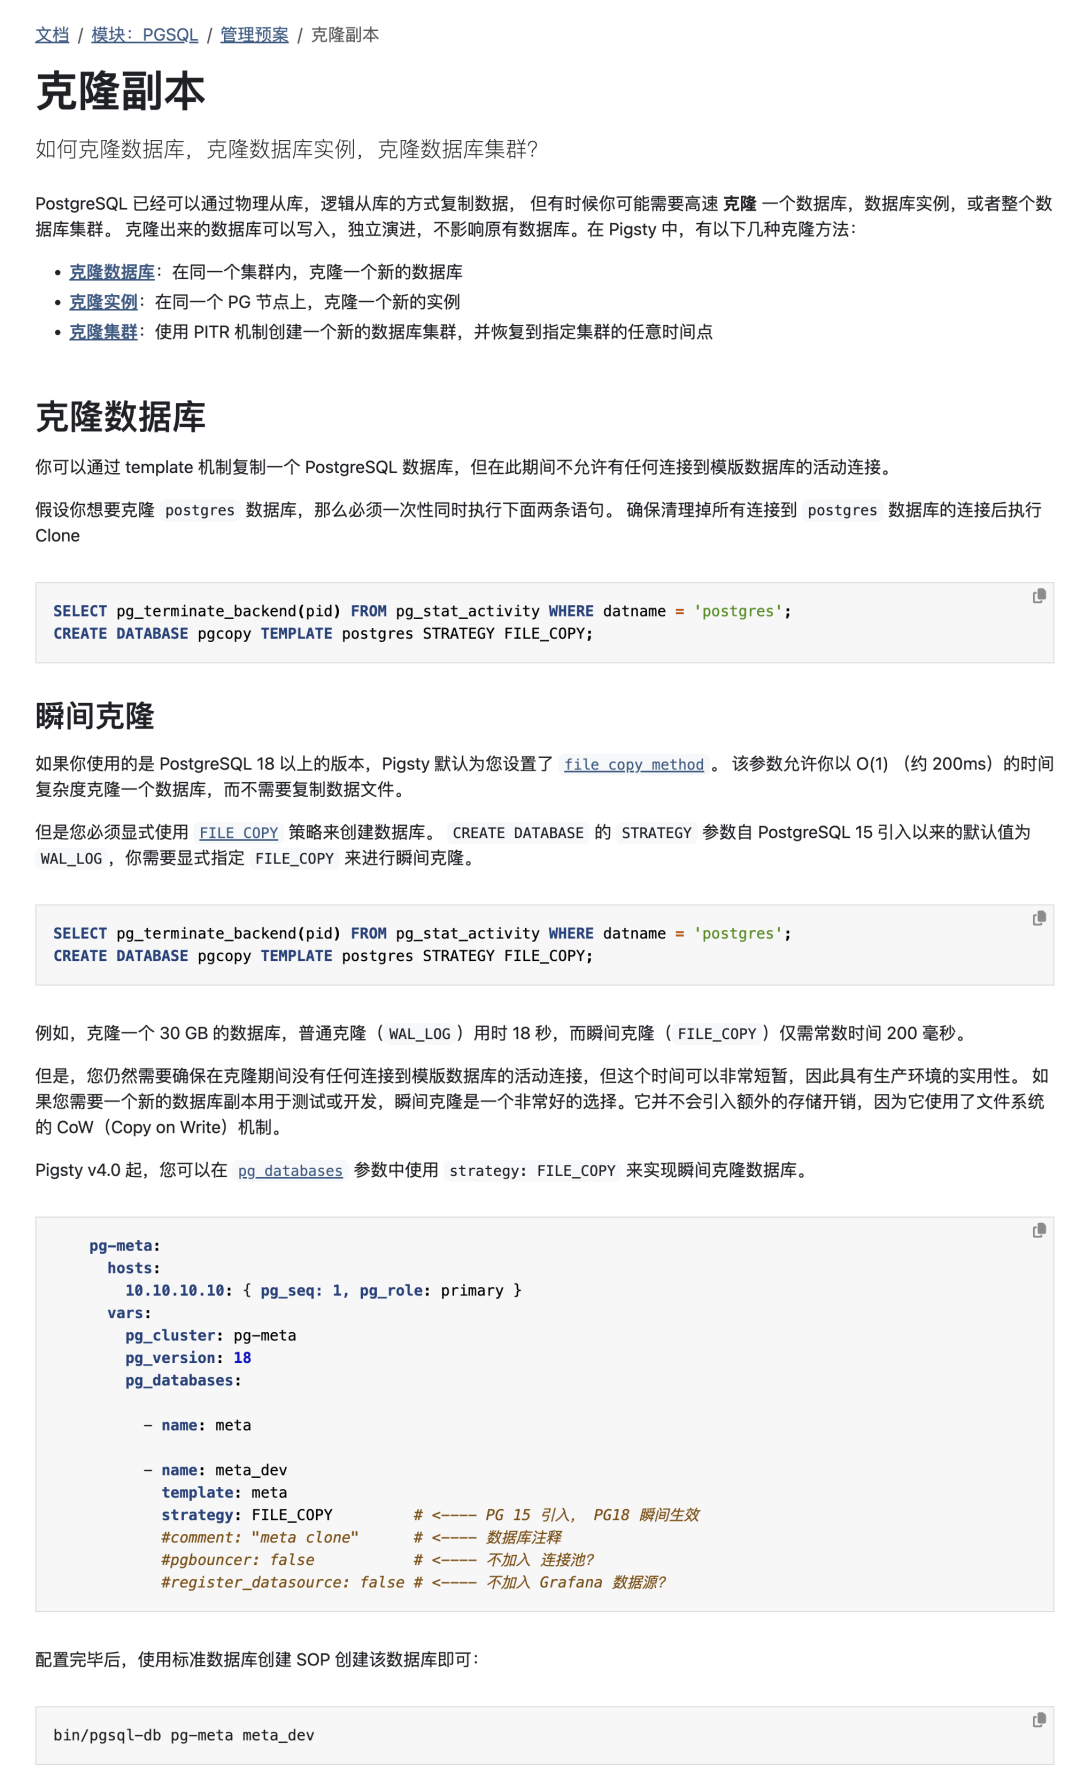
当然其实这里的细节还是不少的,比如,你要确保 file_copy_method 被正确设置为 clone 才有这个特性,这个 Pigsty 创建的集群全都已经针对 PG18+ 都配置好了。 如果你要克隆的数据库就是管理数据库 postgres 本身怎么办 (克隆的时候不允许连接)。再比如,克隆数据库之前要先终止所有连接,这些都帮你自动搞定了。
还有没有其他手段?
当然,即使是 200ms 的不可用时间,有时候对于比较严格的生产环境依然是不可接受的。 而且如果你的 PG 版本不是最新的 18,也没法用这个特性。
Pigsty 提供了两种更强大的克隆方式,场景稍微不太一样:
实例级克隆:pg-fork
实例级别的克隆思路和 PG18 的 CoW 类似,都需要你的文件系统支持 reflink(XFS/Btrfs/ZFS)。 之前生产环境的文件系统老冯一直都强烈推荐用 xfs,现在也是很多地方都默认,这个要求并不难满足。
用了 xfs 之后,你可以使用 cp --reflink=auto 来克隆整个 PGDATA 目录,从而克隆一个完全独立的 PostgreSQL 实例。 这个过程也是瞬间完成的,和数据库大小无关,而且克隆出来的不占用实际存储,除非你开始往里面写数据,才会触发 CoW。
postgres@vonng-aimax:/pg$ du -sh data
797G    data
postgres@vonng-aimax:/pg$ time cp -r data data2

real    0m0.586s
user    0m0.014s
sys     0m0.569s
当然,实际上细节要比这个复杂,你如果直接这么复制,大概率得到的是一个数据状态不一致的脏实例,启动不了。 所以还要配合 PostgreSQL 的原子备份 API 来确保数据一致性 —— 核心就是这一行:
psql <<EOF
CHECKPOINT;
SELECT pg_backup_start('pgfork', true);
\! rm -rf /pg/data2 && cp -r --reflink=auto /pg/data /pg/data2
SELECT * FROM pg_backup_stop(false);
EOF
当然实际上各种边界情况要复杂一些,比如克隆出来的实例如果你要拉起来,不能挤占原来实例的端口, 不能写脏原来生产实例的日志/WAL归档,诸如此类细节。所以 Pigsty v4 就提供了一个傻瓜式的克隆脚本 pg-fork 来解决这个问题。
pg-fork 1 # 克隆一个 1 号实例,/pg/data1 ,监听 15432 端口
实例级别克隆的好处是,克隆出来的是一个完全独立的 PostgreSQL 实例,同样不占用额外存储空间,同样是瞬间完成的。 但是它不需要你关闭原始模板数据库的连接,所以不会影响生产环境的可用性。 最多就是拉起来的时候吃掉点内存,但这种时候你就发现 PG 的双缓冲其实也有好处了。 默认配置 25% 的 Sharedbuffer,你可以很轻松的再拉起一两个实例。
更妙的是,这种克隆出来的实例,还可以通过 pg-pitr 脚本,利用基于 pgBackRest 的备份,做时间点恢复(PITR)。 而且这个时间点恢复也是增量进行的,所以速度也很快。
这种机制最直接的应用场景就是,误删数据了,但是删的又不多,不至于全库回档。 那么这种情况下,就可以使用 pg-fork 脚本,瞬间克隆出一个和生产库一模一样的副本, 然后原地 pg-pitr 增量回滚到几分钟前,拉起来,把误删的数据查出来再写回去。
集群级别的克隆
当然,还有一种集群层面的克隆,利用的技术也是类似的,通过使用一个集中式的备份仓库,你可以从任意一个集群的备份中恢复到备份保留期限内的任意时间点。
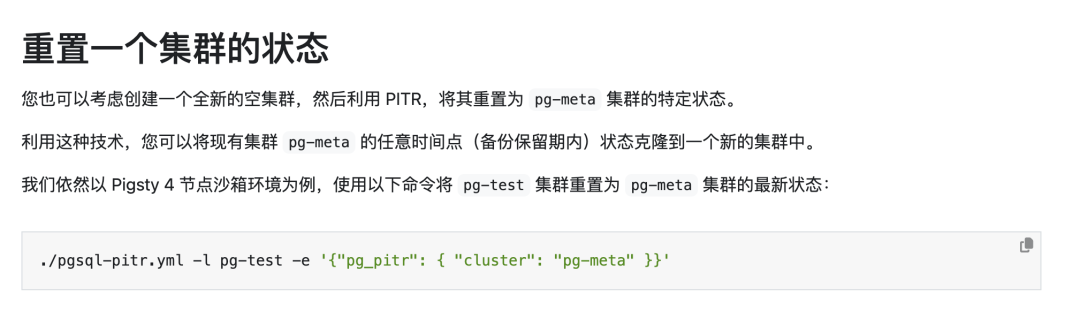
这种方式的集群克隆不用消耗原本生产集群的任何资源,云上的各种 “PITR” 其实就是这种方式,给你拉起一套新的集群,恢复到指定时间点。 但是这种方式的速度就慢多了,毕竟要把数据从备份仓库里拉出来,恢复到新的集群上,时间和数据量成正比。
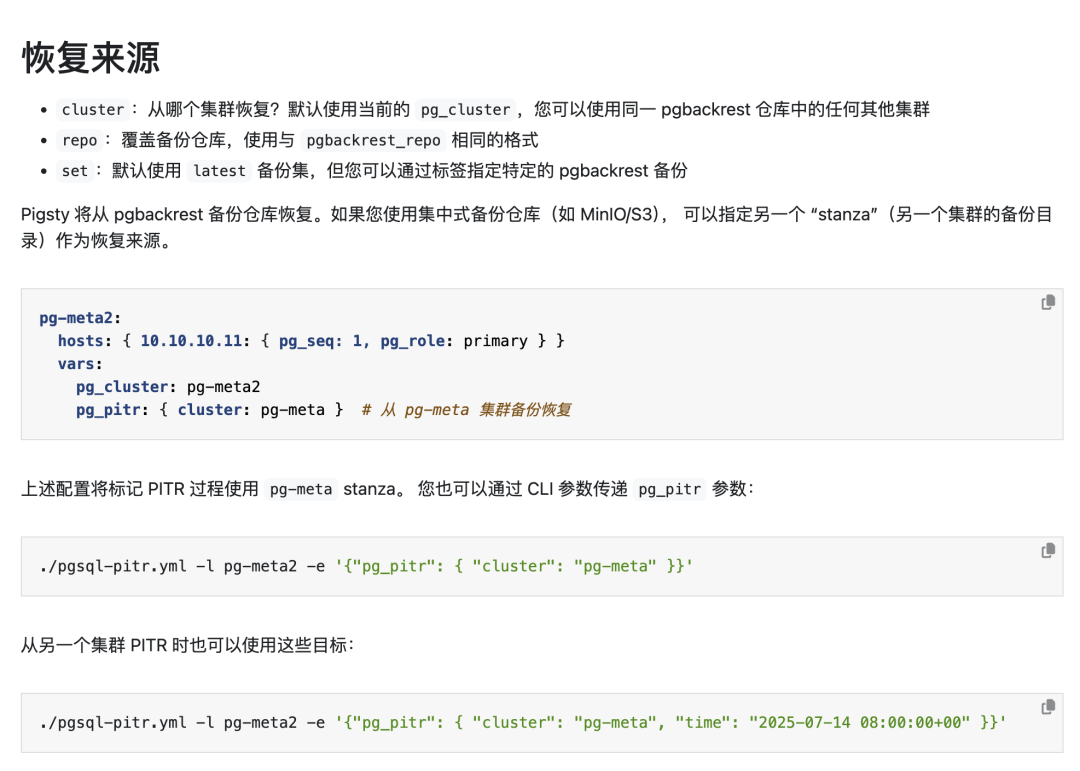
这种方式是最传统的 PITR ,因为没有那种 “瞬间克隆” 的效果,就不展开介绍了。
应用场景
三种克隆方式,各有适用场景,也很好理解,连接串五要素里面,去掉用户名和密码, 有三个要素可以修改:
修改数据库名,就是 Database 克隆
修改端口号,就是实例级克隆
修改主机IP,就是集群级克隆
虽然已经有了 pg-fork 这种实例级的 “瞬间克隆” 技术,而且没有数据库模版克隆要求几百毫秒停机时间的限制。 但这种操作要求你必须拥有数据库服务器的文件系统访问权限。而且你克隆出来的实例也仅限于在同一台机器上运行 —— 从库上是没有的。
而数据库克隆有一个独特的优点,就是这个操作是 “完全在数据库客户端连接” 内完成的,也就是可以通过纯 SQL 来完成,不需要服务器访问权限。 这就意味着,你可以在任何能连接到数据库的地方,执行这个克隆操作,唯一的代价就是 200ms 左右的断连时间。
这就打开了一扇新的大门:
AI Agent 场景:给 Agent 只开一个数据库连接的权限,每次需要"乱搞"的时候,让它自己克隆一个沙盒出来。搞烂了就 DROP,没有任何代价。10 个 Agent 并行跑,存储开销几乎为零。
CI/CD 场景:以前数据库发布胆战心惊。现在用极低成本克隆出一堆测试库跑集成测试,DDL 迁移在真实数据上验证完再上生产,心里有底多了。
开发环境:每个开发者一个完整的数据库副本,数据和生产一模一样,存储成本趋近于零。改坏了?重新克隆一个,200 毫秒的事。
写在最后
"Git for Data" 这个概念被吹了好几年,各种创业公司融了不少钱。但 PostgreSQL 用一个简单直接的方式给出了自己的答案: 不需要额外的中间层,不需要复杂的架构,利用现代文件系统已有的能力,在数据库内核层面原生支持。
几百毫秒,没有额外存储,一条 SQL 搞定。
有时候,最好的方案就是最简单的方案。
如何快速上手学习 PostgreSQL?
2025 数据库世界年度回顾
国产数据库:我已经过了痛心疾首的阶段
Claude Code 免翻上手指南
2025 年度数据世界总结:石破天与Andy Pavlo对谈录
Agent的数字躯体:一场不在内核的数据库革命
MySQL:互联网行业的服从测试
Victoria:吊打业界的可观测性全家桶来了



