我们气象人在做数值模拟的时候,其实都有一套“祖传调参手艺”。比如降水空报一多,第一反应不是怀疑人生,而是怀疑对流参数化是不是太容易触发;要是整体降水偏弱,那就会琢磨,是不是凝结效率太低,水汽还没来得及下就被“憋回去了”。
再比如,有时候低层水汽怎么都攒不住,画个空间场一看,几乎连起伏都没有,本该存在的高值区和结构明显被削弱,甚至直接“消失”了。这时候,多半会去怀疑边界层混合是不是开大了。总之,这些年下来,大家多少都有点“看图识参数”的本事,甚至有时候只看一眼偏差,就能大概猜到是哪一块出了问题。
但问题一旦换成深度学习模型,画风就有点不一样了。evaluation一跑,一堆指标扑面而来:MAE、RMSE、bias,看起来挺热闹,甚至有点“数据很充分”的错觉。但你要真盯着看一会儿,内心基本只剩一句话:然后呢?我到底该调哪儿?
这段时间我在做一个华东极端降水的实验,我想给模型加一点“物理约束”,让它别那么“黑匣子”。我的想法很简单:既然我们经常会因为纯数据驱动的黑箱属性而不敢相信AI的预报结果,那我给它加点物理约束,让过程更可解释一些,也许还能顺带把效果往上抬一抬。
结果第一轮跑完,现实给了我一个很典型的科研反馈:想法很好,下次别想了。
如下图的前4次实验(physic1~physic4),MSE比baseline高出一大截,bias也离0更远了,尤其是强降水,全被模型“按住了”
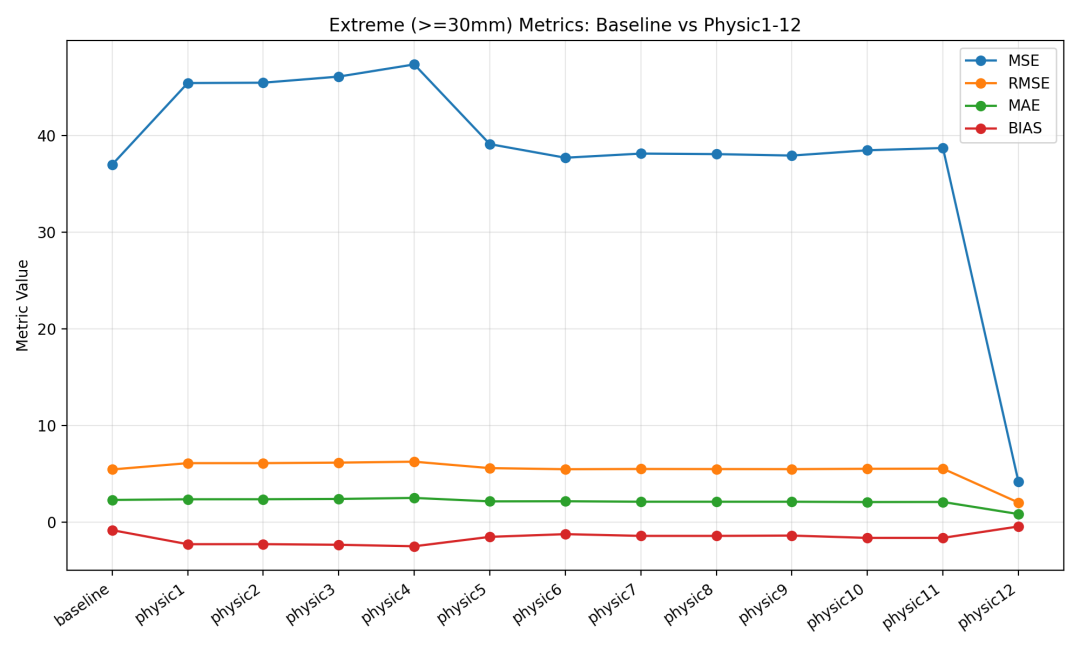
当时那个感觉,其实特别像在看一个被“过度平滑”的数值模式结果——你明明知道这里应该有强对流,但空间场就是一片温柔,雨都被“讲道理”讲没了。
所以这一步基本可以判断:问题不在模型能力,而在约束方式。物理约束被一股脑加在所有样本上,本质上就是在对整个分布做“降噪处理”,而极端降水,恰恰就是最不该被降噪的那一部分。
于是第二轮的思路就很朴素了:既然你老爱“管太多”,那我就让你少管一点。具体做法是把物理约束限制在中等降水区间(5到30毫米),对极端降水基本放手。
与此同时,我又偷偷给模型“开了点小灶”,专门加了一些针对极端样本的loss,比如限制极端bias,同时把极端样本的权重往上提了一截,意思很明确:这部分你给我好好学,别再划水了。
这一轮下来,效果明显就顺眼多了。极端降水的MAE有了改善,低估问题也没那么离谱了。那一刻的感觉,有点像你终于把某个参数化方案调到“既不炸也不闷”的那个甜点区间。
但科研这种事情,一般不会让你太早开心。新的问题很快出现了:MAE是好了,但RMSE还是不争气,总是比baseline差一点点,像极了考试总差两分上不了线的感觉。
这说明什么?说明模型整体更稳了,但总有那么几个点,误差特别大,在那儿“拖后腿”。这在气象里其实也不陌生,就像你大多数时候预报都不错,但偶尔一次强对流没抓住,直接把评分打回原形。
于是我又开始折腾第三轮。这次的思路很直接:既然是“个别点太离谱”,那就让模型对这些大误差更敏感一点。于是引入了类似Huber loss这样的机制,让模型在面对大误差时“多疼一点”。
同时继续提高极端样本的权重,相当于不断在模型耳边提醒:重点是这个,重点是这个,别老看平均值!
这一轮的结果也挺有意思:MAE继续优化,甚至到了一个比较理想的水平,但RMSE依然不肯服软。这个时候基本可以判断一件事了——再怎么调loss,可能也到头了。
换句话说,这已经不是“调参问题”,而是“思路问题”。
后来我干脆换了个方向,不再试图让一个模型同时搞定所有情况,而是把问题拆开来做。简单来说,就是搞了个“分工合作”:一部分模型负责普通降水,另一部分专门盯极端降水。
这个思路其实非常符合气象直觉。毕竟我们都知道,极端天气从来就不是普通天气的“加大版”,而是另一套机制在主导。你非要让一个模型同时学两种东西,它不崩才怪。
分开之后,整个世界都安静了不少。极端降水不再被平均掉,模型也不需要在不同尺度之间反复横跳,很多之前死活压不下去的误差,也开始慢慢收敛了。
回头看这一圈“折腾史”,其实挺有意思的。表面上是在调深度学习模型,实际上走的路径,跟我们调数值模式几乎一模一样:先看现象,再猜机制,然后一点点试,一点点修。
所以有时候,深度学习之所以让人觉得“玄”,并不是它真的玄,而是我们一开始没找到一个合适的理解方式。一旦你把它放回到“气象调参”的语境里,很多东西反而变得顺理成章。
当然,也必须承认,这一套流程确实挺费人。每一步都要训练、看结果、再改,多少有点“面多了加水、水多了加面”的味道。调到后面,甚至会产生一种错觉:我是在做AI,还是在养一个不太听话的模型?
不过换个角度想,这可能也是现在这个阶段的乐趣所在。我们还能清楚地看到模型是怎么一点点被“教出来”的,而不是一开始就全自动。
至于未来会不会有一天,这些调参、改结构的事情,都交给智能体自己去做,我们只需要坐在一旁点点头,甚至连头都不用点,智能体直接替我们把决定全都做了,那就是另外一个故事了。
但在那一天真正到来之前,我们可能还是要继续干这件非常“气象”的事情:
看偏差,猜原因,然后再试一次。
声明:欢迎转载、转发。气象学家公众号转载信息旨在传播交流,其内容由作者负责,不代表本号观点。文中部分图片来源于网络,如涉及内容、版权和其他问题,请联系小编(微信:qxxjgzh)处理。