刚刚,一款名为 DeepSeek Reasonix 的开源项目冲上 Hacker News 热榜!
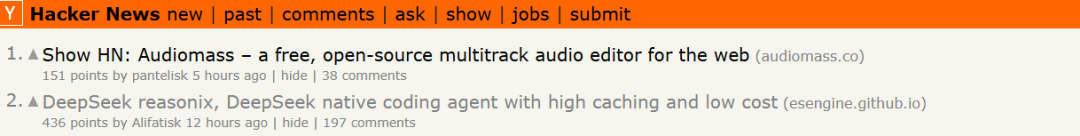
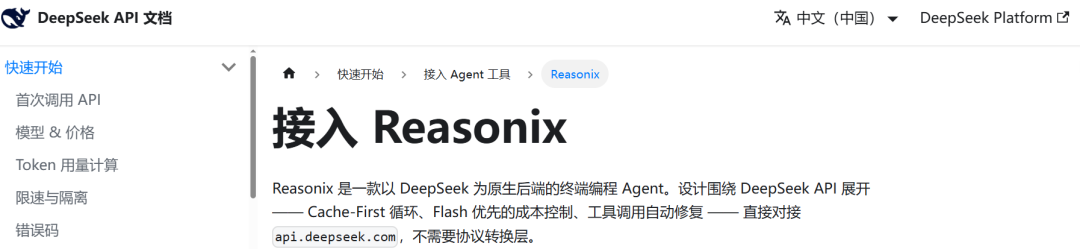
小编就去扒了一下 Reasonix 的来龙去脉:Reasonix 在4月21号出现在 Github,随后被 DeepSeek 收录官方文档。
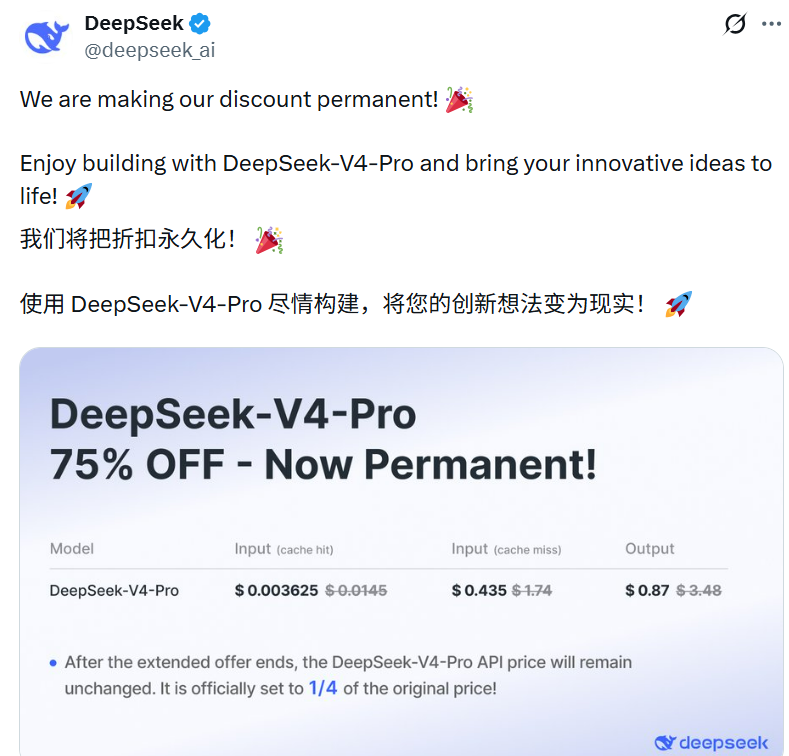
前两天 Deepseek 宣布 V4-Pro 模型API价格永久降价,围绕“低成本长上下文 Agent”的讨论被点燃。
借着这股东风,Reasonix 的热度直接暴涨。截至今天,DeepSeek‑Reasonix 在 Github 上已经获得 7 千 star。
一个专为 DeepSeek 设计的 Agent 项目,有什么亮点?
凭什么能突然爆火?
Reasonix:为 DeepSeek量身定制的省钱 Agent
Reasonix 是什么?
官方博客里的描述:“
一款基于 DeepSeek 的原生 AI 编码代理,围绕前缀缓存稳定性进行设计。”
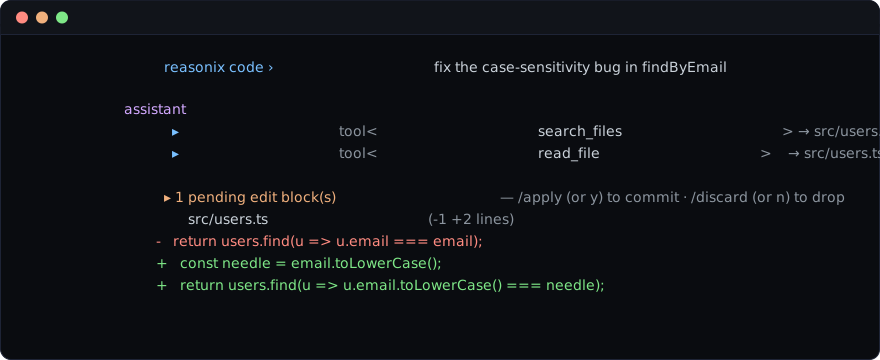
简单来说 Reasonix 是一款“DeepSeek 原生”的省钱终端 Agent。
为什么不用 Claude Code,Reasonix 却火了 ?
如果只是模型便宜,大家直接用 OpenCode 或 Claude Code 连 DeepSeek API 就行了,为什么偏偏是 Reasonix 火了?
正如 Hacker News 网友热议的那样,Reasonix 戳中了一个痛点:Prefix Cache(前缀缓存)的命中率。
DeepSeek 提供了极其夸张的缓存折扣(命中缓存的输入 Token 价格低至 $0.003625/百万)。这意味着如果你的上下文在多轮对话中保持不变,几乎是在白嫖算力。
然而,像 OpenCode 或其他通用 Agent 的架构,为了通用性,往往会在每一轮对话的系统提示词里动态注入一些新信息(比如:当前时间戳、当前 Git 分支名、最新文件列表等)。
只要前缀里变了一个 Token,整个模型的 KV 缓存就会失效,下一轮又得全量重新计算。
Reasonix 是“缓存优先”的设计。它在工程上严格保证了 Prompt 前缀的绝对稳定,绝不乱塞动态信息。
加上它内置了 Flash 与 Pro 模型的双模智能切换(平时用极其廉价的 Flash 跑日常迭代,遇到难关输入 /pro 一键武装 Pro 模型),在终端里简直是省钱利器。
4.35 亿 Token 仅花 12 刀!揭秘 Reasonix 三大支柱
根据博客,DeepSeek‑Reasonix 有三大支柱:
第一支柱:缓存优先循环
DeepSeek 将缓存输入计入未命中率的约 10%。自动前缀缓存仅在与前一个请求的字节前缀完全匹配时才会激活。大多数代理循环会在每次迭代中重新排序、重写或注入新的时间戳——实际缓存命中率:3% 到 20%。
解决方案:将上下文划分为三个区域。
┌─────────────────────────────────────────┐
│ IMMUTABLE PREFIX                        │ ← fixed for session
│   system + tool_specs + few_shots        │   cache hit candidate
├─────────────────────────────────────────┤
│ APPEND-ONLY LOG                         │ ← grows monotonically
│   [assistant₁][tool₁][assistant₂]...    │   preserves prefix of prior turns
├─────────────────────────────────────────┤
│ VOLATILE SCRATCH                        │ ← reset each turn
│   R1 thought, transient plan state      │   never sent upstream
└─────────────────────────────────────────┘
不可变前缀:会话期间固定不变(包含系统提示词、工具声明、Few-shots 示例),是缓存命中的核心。
仅追加日志:保存历史对话轮次,严格保留先前轮次的前缀。
易失性草稿:每轮重置(如 R1 的思考过程、临时的计划状态),绝不发送给上游模型,从而避免污染后续的缓存。
并行工具调度:支持声明 parallelSafe?: boolean 的工具并发执行,在保证效率的同时,通过串行屏障(Serial Barrier)确保数据的读写顺序和模型看到的历史一致。
第二支柱——工具呼叫维修
问题:DeepSeek 在实际使用中存在一些特定的失效模式:工具调用的 JSON 错误地遗留在标签内部,未输出到最终消息中;当参数架构包含超过 10 个参数或存在深度嵌套时,参数容易丢失;连续多轮用完全相同的参数调用同一个工具;由于达到 max_tokens 导致 JSON 在中间被截断。
解决方案:通过四个阶段的管道进行自动修复。
Flatten:自动检测复杂 Schema,将其转换为“点号标记法”(dot-notation)展示给模型,在调用前再重新组装。
Scavenge:利用正则表达式和 JSON 解析器,强行从 reasoning_content(思考内容)中捞出模型忘记正常发射的工具调用。
Truncation:检测未闭合的 JSON,通过补全右括号或请求续写来修复。
Storm:在滑动窗口内如果出现完全相同的(工具, 参数)元组,则直接抑制该调用,并注入一轮反思。
第三支柱——成本控制
问题:如果 Agent 默认一直调用最强的前沿模型(如 v4-pro,成本约为 flash 的 12 倍),且在上下文中堆积大量的全量工具结果,活跃用户每月成本可能高达 $150–$250。但实际上,大多数对话轮次不需要顶尖的推理能力,且许多工具结果往往只在当下有用。
解决方案:通过以下四个机制协同控费(无需人工微调)
分层默认(Flash 优先):默认采用 auto 预设,即“平时用 v4-flash,遇到困难轮次才自动升级到 v4-pro”;所有辅助调用(如截断修复、摘要生成)硬编码强制使用成本极低的 v4-flash。
轮次结束自动压缩:当一轮对话结束时,任何超过 3000 tokens 的工具结果都会被就地压缩。后续轮次只能看到紧凑的摘要,如果需要全量数据可以重新读取(重新读取一次的成本远低于让几万 token 滚雪球般拖累后续的每一次对话)。
/pro 单轮手动解锁:用户预测任务艰难时可输入 /pro,仅让下一轮对话强制运行在 v4-pro 上,随后自动降级,避免忘记切回而产生不必要的开销。
失败信号自动升级:实时统计当前轮次中“Flash 正在挣扎”的信号(如文件修改报错、找不到文件、触发工具修复等)。一旦信号达到阈值(如 3 次),当前轮次的剩余部分将自动升级到 v4-pro 运行,确保任务不卡死。
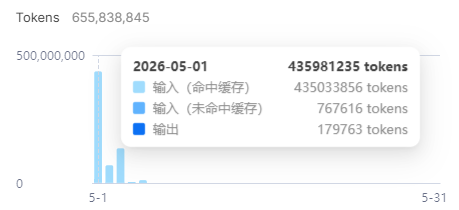
官方博客里给出了真实案例:4.35 亿个输入token, 缓存命中率 99.82% ,成本约为 12 美元,而使用 v4-flash 且不使用缓存时,相同工作负载的成本约为 61 美元。
网友:前沿模型成本飙升,它来得恰逢其时
对 Reasonix,网友的评论大多集中于功能讨论。
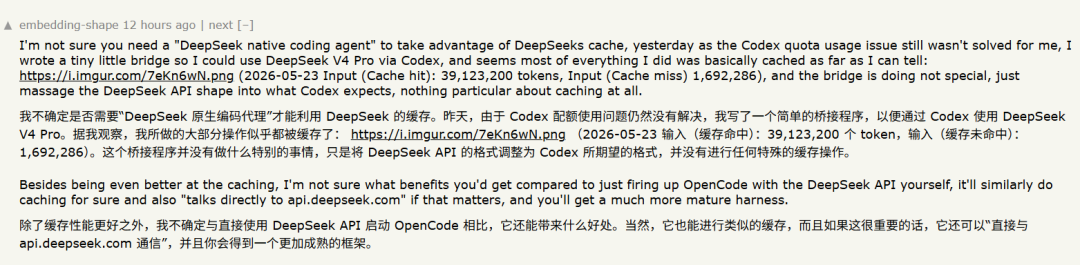
“我不确定是否需要 Reasonix 才能利用 DeepSeek 的缓存”
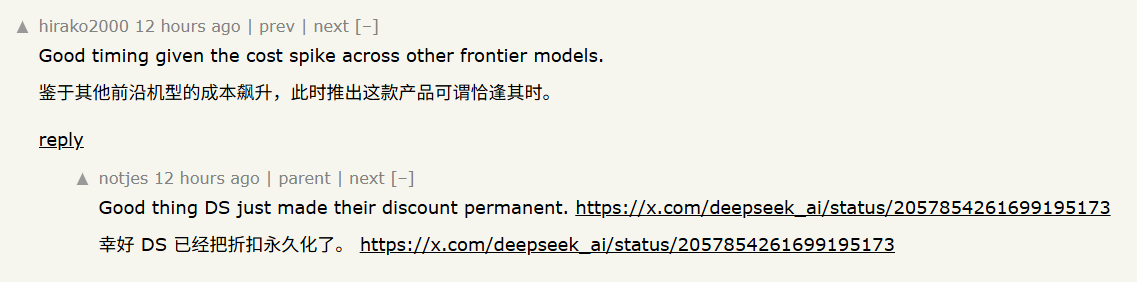
“鉴于其他前沿模型的成本飙升,此时推出这款产品可谓恰逢其时。”
还有吐槽网站页面效果的:“动画文字效果导致示例页面不断调整大小,使得下方的内容上下移动。用户体验太差了。”
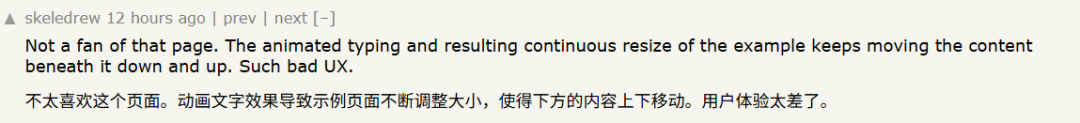
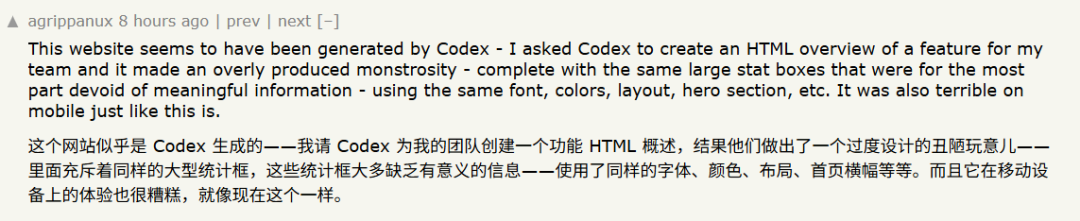
小编也觉得这个页面有点潦草。
写在最后
有网友在评论区下面玩起了梗:“计算机科学里只有两个难题,命名和缓存失效。”
而 Reasonix 的整个设计,本质上就是在解决缓存问题。
各位大佬体验过了吗?欢迎在评论区分享~
参考链接:
https://esengine.github.io/DeepSeek-Reasonix/
https://github.com/esengine/DeepSeek-Reasonix/tree/main
——好文推荐
——
“构建你的第一个AI Agent团队”指南!5步快速打造个人Agent,全自动内容Agent团队实例:30分钟内自动出稿,Agent团队高效运转的技巧
面壁智能正式开源中国首个基于国产算力平台训练的 1.58-bit 端侧高效大模型 BitCPM-CANN
Claude比你更懂你的需求?Anthropic工程师公开内部用法:用HTML作为AI规范,反而比Markdown更省Token;让“验证”成为Agent的原生特性



