Agent 会成为下一代创作者吗?
过去,人们讨论更多的是 Agent 如何写代码、调用工具、完成复杂任务;而在视频生成、AI漫剧、数字内容生产等场景中,一个新的问题正在浮现:当 Agent 开始参与创作,学习创作,它该如何理解人的审美?
与 Coding 追求正确答案不同,AIGC 创作面对的往往没有标准答案。什么样的镜头更有表现力?什么样的故事更符合创作者想表达的内容?这些判断背后,都依赖于持续的反馈与学习。
为什么要为 AIGC 重新做一套 RL 框架?
在腾讯混元高级研究员王淏楠博士看来,AIGC 的下一站,不单单是执行画图或者视频生成任务,而是参与创作。而推动这一变化的关键力量,正是强化学习。用户每一次修改分镜、筛选画面和调整剧情,都可能转化为 AIGC Agent 持续进化的训练数据,让创作过程本身成为新的数据飞轮。
7 月 2 日,在 2026 中国 AI 智能体大会上,王淏楠带来《Hunyuan UniRL:面向统一多模态模型的分布式 RL 后训练框架》主题报告,分享了腾讯混元团队对于AIGC 的最新判断:WorkFlow 让 AIGC 开始 Agent 化,RL 后训练让它有机会从反馈中学习创作。
王淏楠:大家好,我是王淏楠,来自腾讯混元多模态强化学习团队。今天分享的是我们团队最近提出的一个 RL 框架——Hunyuan UniRL。与之前几位老师的分享不同,该框架更多面向 AIGC 的 RL,而非单纯的任务完成,更多关注点在于“创意”。
Agent范式演进:从Collaboration
迈向Loop模式
我们先回顾一下 Agent 领域的发展历程。
从 2023 年底到 2024 年初,以 GPT-3.5 为代表,主流范式还是“合作模式”的早期形态,即 Chatbot。用户输入一个 Prompt,模型返回一个 Response,是 Text-in、Text-out 的单轮交互。
到 2024 至 2025 年,范式演进为多轮协作(Collaboration)。在这一阶段,用户需要在关键节点承担 Review、Comment,以及 Accept 或 Reject 的职责。
而从今年 3 月开始,我们观察到行业正在进入 Loop 或 Goal 模式。用户只需给出目标或完成条件,系统便会自动执行 Plan、Act、Observe 和 Revise 的循环。
从 Collaboration 到 Agent Loop 的演进,也伴随着从 Single Agent 到 Multi-Agent 的转变。因为在 Goal 模式下,原本需要人来完成的部分判断工作,开始由其他 Agent 接管和执行。因此,整个技术路线的演进,本质上是从 Single Model Agent System 逐步走向 Multi-Agent System。
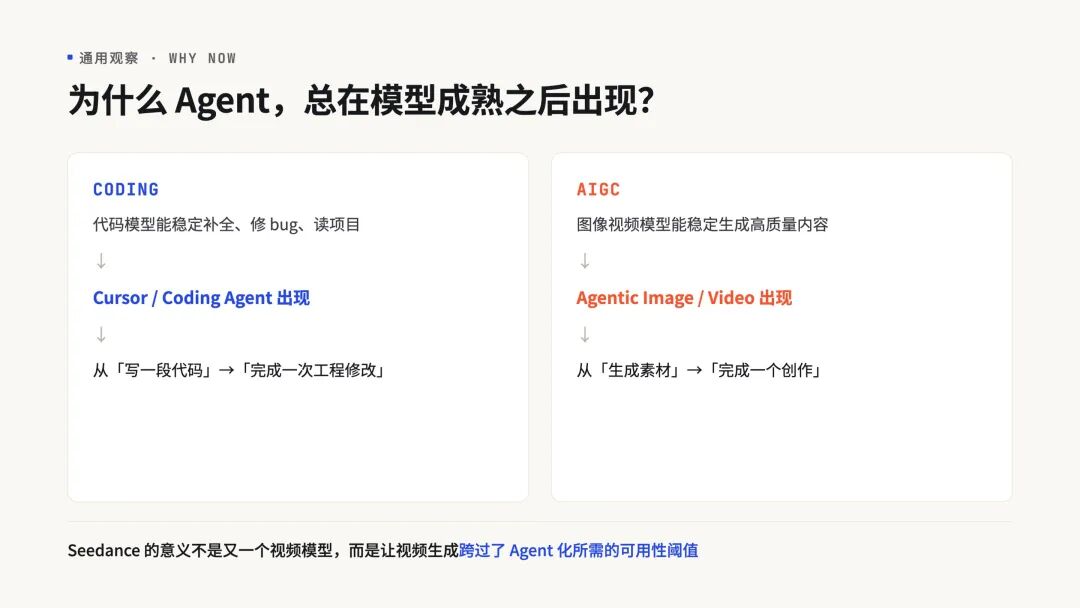
为什么 Agent 总在模型成熟之后出现?我们认为整个行业发展的核心驱动力始终是基础模型能力的提升。
每一次范式变迁,本质上都建立在底层模型能力突破的基础之上。换句话说,在 2023 年,我们很难想象今天的 Agent System;同样,在 2024 年,无论是国内还是国外,基础模型能力也远未达到能够支撑 Self-Evolving Agents 的程度。因此,直到 2026 年,Self-Evolving 技术才开始真正具备落地条件。
时代的转变一定伴随着底层技术的突破。
聚焦到 AIGC 领域,今年国外最受关注的是 GPT-Image 2,它已经从单一生图逐步走向 Agentic 生图;而国内的 Seedance,无论是视频连贯性还是真实场景生成能力,都已经提升到了新的层次。
基于这些变化,我们团队目前的判断是:视频生成的基础模型能力,已经从最初的 Chatbot 模式,逐步具备了向 Agent 化跃迁的条件。
视频生成目前仍停留在 Agent 协作阶段,中间需要大量人工介入和反馈。
它与 Coding 或订机票这类任务不同。后者通常有明确的目标和答案,而生成 PPT、视频甚至 AI 漫剧时,关键不只是“完成任务”,而是是否符合创作者的审美和表达意图。
用户会不断参与判断和选择,例如某个分镜是否合适、某种光影渲染是否符合预期,以及 Storyboard 是否符合了最初想表达的叙事逻辑,而每一次人机交互都在产生大量高价值数据。
当用户在多个方案中做出选择时,本质上就在形成 Preference Pair;对分镜提出的 Comments 是直接的用户反馈;拒绝某个镜头属于 Negative Feedback;修改规划逻辑则是 Planner Correction;而最终确认“这就是我想要的结果”,则构成了 Outcome Reward。
这些数据共同构成了一个完整的反馈闭环,也是驱动数据飞轮和 RL 循环运转的宝贵资源。
Workflow让AIGC走向Agent化,
RL让Agent学会创意
那么,如何利用这些数据,让 AIGC 从单纯的 prompt执行模式进一步走向AIGC Agent,进而完成创作?
这正是我们团队正在思考的问题:如何有效地收集、利用这些交互数据,并将其持续迭代到 RL 算法之中。
把这些多模态反馈转成 RL 后训练数据——这正是 UniRL 的主场。
我们理解的 Agent 化发展路径,大致可以分为三个阶段。
第一个阶段是单次生成,即从 Prompt Input 到 Text Output 的模式。
第二个阶段是创作编排。用户在画布中进行创作、修改、反馈和执行。
而随着这种编排过程逐渐固定和积累,其中产生的大量交互数据也开始具备被机器学习的价值。
因此,我们正在走向第三个阶段——可训练的创作闭环
。在这个阶段,人在创作过程中做出的判断、反馈和修改,被吸纳到模型训练体系中,进一步提升模型的审美和创意能力。
这也是我们目前的判断:Workflow 让 AIGC 走向 Agent 化,而 RL 则让 Agent 具备持续学习创意能力。
UniRL为Agentic AIGC
搭建通用RL基础设施
相比 Coding 场景,Creative AI 或 AIGC 的 RL 要复杂得多。
一方面,模态发生了变化。从文本生成扩展到图像生成、视频生成之后,RL 面对着更加复杂的多模态空间,这本身就显著提高了训练难度。
另一方面,视频生成还是一个更“重”的任务。它不像传输几个 Token 那样可以高效完成,而是涉及更大的数据量和更复杂的计算过程。因此,当系统需要 Scaling Up 时,不仅是模型本身的问题,还涉及通信协议和系统架构层面的挑战:如何解耦不同模块,如何设计更高效的数据传输机制使整个系统 Scaling Up。
基于这些挑战,我们提出了 UniRL,希望为 Agentic AIGC 时代构建一套通用的 RL 基础设施。
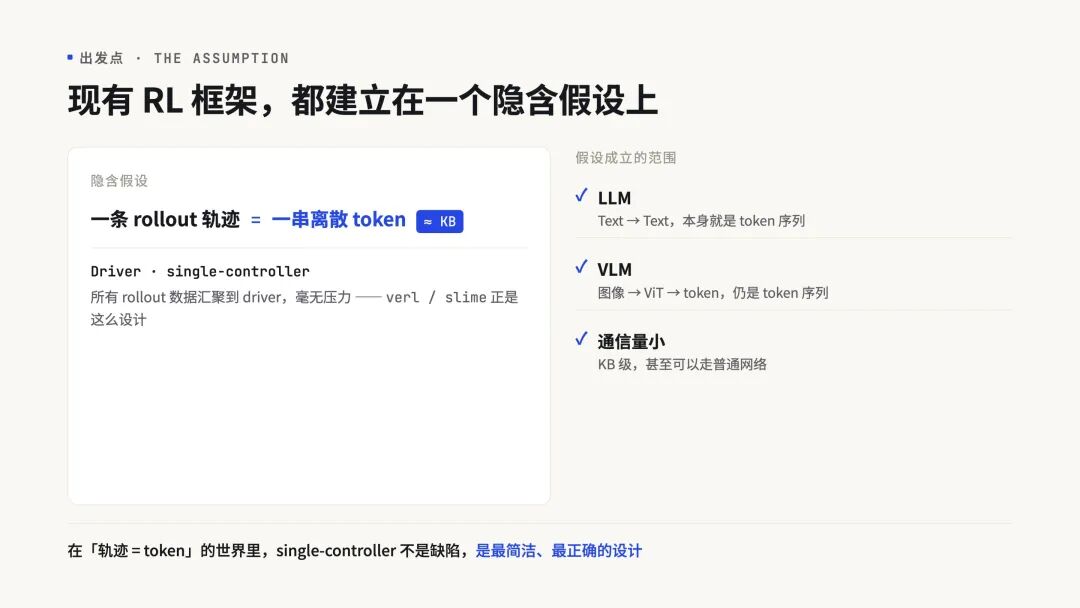
不过,每次提到我们要做 RL Infra 时,都会有人问:现在已经有很多优秀的框架,比如 veRL、Slime 等,它们都已经是产品级框架。那么,为什么还需要我们呢?
这需要回到 2024、2025 年的背景来看。当时大多数 RL Infra 都建立在一个共同的假设之上:模型最终生成的是 Token。无论是单模态还是多模态,即便输入包含图片,最终输出依然是一段文本。例如,给模型一张解析几何题,它会先理解图片内容,再生成数学答案,而不是生成新的图片。
因此,那一代 RL Infra 普遍采用 Single Controller 架构。因为传输对象是 Token,成本相对较低:多个 Worker 完成 Rollout 后生成 Token,再统一传回 Controller,由 Controller 负责调度和分发给训练端。
如何构建Agentic AIGC时代的
UniRL框架
但到了今天的 AIGC 时代,尤其是在生图、生视频等创意 Agentic RL 场景中,这个假设已经被打破了。
此时 Rollout 产生是大量图像和视频数据,无法再像过去那样,把数百个 Worker 生成的海量数据统一汇聚到一个 Driver,再由 Driver 进行集中分发。这样的架构会迅速成为系统瓶颈,并严重限制整体的 Scaling Up 能力。
这也是我们对“为什么已有这么多 RL Infra 框架,还要重新做一套系统”的回答:因为 AIGC 时代的数据形态已经发生变化,我们需要一种新的组织架构,重新定义 Rollout(生图、生视频)与训练之间的数据协作方式。
1. 算法统一
在视频和图像生成领域,目前都绕不开 Diffusion。虽然最近有不少研究机构和优秀研究者在探索 AR 生图、AR 生视频,但从实际效果来看,其生成质量距离大规模商用和产品化仍有明显差距。因此,当前的主流生成系统依然高度依赖 Diffusion 架构。
而 Diffusion 的引入,也给 RL 带来了与语言模型完全不同的挑战。
在语言模型中,训练和优化围绕 Token Probability 展开,整个概率建模过程相对自然;但 Diffusion 本质上是一个逐步降噪的过程,从当前状态扩散到下一个状态,不像语言模型那样天然存在一个明确的 logP 表达。
因此,如何构建一套统一框架,将传统 AR 模型、语言模型或 VL Model 的 RL Training 思路,与 Diffusion Model 的 RL Training 思路结合起来,算法层面是一个非常大的挑战。
另外,大多数框架很少考虑生图、生视频这种迭代式生成流程,这样的组织结构在数据管理和系统负载方面面临新的挑战。
如何把算法实现统一?我们实现的思路有一个非常有意思的比喻:
Diffusion 本质上是一个逐步降噪的过程:一张图片从随机噪声开始,经过多轮迭代,最终变成清晰图像。而我们发现,这个过程其实可以类比为 Language Model 的 Thinking 过程。
对于语言模型来说,模型会经过多步 Thinking 最终得到一个 Answer;而对于 Diffusion 来说,模型则是从噪声图像出发,经过多轮降噪,逐步逼近目标结果。每一次降噪都可以被看作一次中间推理过程,对应语言模型中的 Thinking Token;最终生成的清晰图片或视频,则对应语言模型给出的最终 Answer。
基于这样的抽象,我们首先在算法层面完成了一种统一:将 Diffusion 中的降噪过程和生成图片,映射到语言模型中的 Thinking 和 Answer。
2.Driver with MetaData
对于语言模型而言,Thinking Token 是离散的文本 Token,所占用的存储和传输成本也比较有限。
但 Diffusion 并非如此。用于训练的每一步降噪过程,都会产生一个规模庞大的 Latent Tensor。随着生成过程不断迭代,从 KB 级别的数据,一直扩展到 GB 级别。
因此,过去基于 Token 设计的通信协议和系统架构很难继续适用。我们无法再依赖 Single Controller 这样的中心化模式,把所有数据统一汇聚、统一管理、再统一分发训练。
为了解决这一问题,我们设计了一套新的 Rollout 与 Training 组织架构——Driver with MetaData。
它的核心思想是:不再让所有数据从 Rollout 直接到 Training,而是通过分布式方案,Driver 只负责传输 MetaData,例如视频对应的元信息,以及 Rollout 端与 Training 端之间的一对一映射关系,这部分只需几十个字节。真正的图像和视频数据,则由 Rollout 端与 Training 端建立传输关系。
这样一来,我们就能够充分利用 Direct RDMA 等高效通信基础设施,从而提升整个系统的 Scaling Up 能力。
3. 部署模式
我们希望这套框架不仅适用于生产环境,也能够服务于高校和研究机构的研究工作。因此,我们进一步提供了三种不同的部署模式。
在设计这套架构时,我们考量到:如果一个框架只面向工业界,最终可能只有少数几家公司能够使用;而如果只面向学校里的 Researcher 或学生,又很难让科研成果及时转换到商业部署。
所以我们设计了三种不同的部署模式,以适配从科研到产业的不同需求。
在学校或研究机构中卡数不多时,可以采用 Train-side 或 Colocate 等部署方式;而在生产环境中,当拥有数百张卡时,则可以采用 Separate 模式,例如让六十多张卡负责 Rollout,一百多张卡负责 Training,并根据实际负载动态调整资源分配。
另外也有一个非常实际的考量:很多国内企业的卡池并不是由同一种 GPU 组成的,而是混拼卡池。企业通常希望将不同任务部署到最适合的硬件上:一部分卡负责 Rollout,一部分卡负责 Training。
在这种场景下,Separate 模式就显得尤为重要,可以更高效地利用企业现有的混拼卡池,实现更符合实际生产环境的训练模式。
4. 高度解耦
我们还在尝试一种可以称为“社会学实验”或“社会学创新”的设计思路:让框架实现高度解耦。
为什么进行高度解耦?是因为我们认为未来写代码的主要参与者未必是人,我们高度解耦是希望让这套框架不是服务于人的,而是服务于 Agent。
我们希望未来能够由 Agent 持续参与框架的迭代,甚至实现 Self-Evolving。因此,代码结构必须保持足够简单和清晰。当代码库变得过于复杂时,Agent 无法准确理解现有代码库,它会在代码库里写出另一路实现,代码库无限膨胀。
这种现象已经在上一代框架中出现了。无论是 veRL 还是 Slime,在不少公司内部都衍生出了大量 Fork,最终导致仓库越来越难以维护。背后的原因在于,Cloud Code、Codex 这样的工具极大降低了写代码的成本,当写代码比管理代码更容易时,代码库就会以极快的速度膨胀,并最终超出管理能力。
因此,我们希望考虑实现框架是 Exactly for Codex 的,而不是让人去写代码。通过极致解耦的架构设计,让 Agent 能够准确理解、修改和协作开发同一套代码,而不是完全依赖人。
5. Reward Server
AIGC Agent 与 Coding Agent 的一个本质区别在于:对于 Coding Agent 来说,最终往往存在相对明确的评价标准,但 AIGC 场景并非如此。无论是图像生成、视频生成还是创意内容创作,评价标准中都包含大量审美因素,而审美本身很难被一套固定规则准确描述。
在 AIGC Agent 中,一个非常核心的问题就是 Reward 的定义。这个 Reward 可能来自审美偏好,也可能来自 OCR、Object Detection 等需要参数化定义的评价函数。不同任务、不同场景,甚至不同用户,所需要的 Reward 都可能完全不同。
因此,我们在框架中专门设计了独立的 Reward Server。它支持高并发请求、独立资源管理以及不同 Reward 环境之间的隔离。这样做的目的,是将 Reward 相关逻辑从主 RL 训练流程中解耦出来,尽量不打扰主 RL 训练的流程。
6. 效率优化
在效率优化方面,我们也做了很多工作。
在 Rollout 侧,我们兼容了目前主流的两类 Rollout Engine,包括 SGLang 和 VeOmni。同时,我们针对部分关键算子进行了改进,利用 Rollout 过程中产生的 logP 来消除 Discrepancy,通过 Importance Sampling(重要性采样)解决随机性问题。
在 Driver 侧,则采用了前面提到的 Driver with MetaData 架构,通过非线性的传输设计,使整个 AIGC RL 进行 Scaling Up。同时 Reward 系统也进行隔离,避免与主 RL 训练框架争抢算力资源。
在 Training 侧,我们支持 FSDP2 和 VeOmni 等训练框架,并结合 Expert Parallel(EP)以及当前广泛使用的 Ulysses Sequence Parallel 等设计,从而支持更大规模的训练任务。
7. Model × Algorithm 可组合
前面提到的模块化、可插拔设计,也让 Model × Algorithm 这种组合方式成为可能,通过实现 Model Bundle 来接入一个新的模型;而算法侧也可以独立开发。并且两者可以进行笛卡尔积式的随机排列组合,实现任何一个模型对应任何一个算法的 Training。
8. 核心系统能力
我们希望这套框架具备三个核心能力。
9. UniRL 总览
我们希望通过这样的架构和配置方式,进一步推动 Agentic AIGC 的发展。Agent 的目标将从单纯的任务执行,逐步走向具备审美理解和创意表达能力的创作编排。
回到整个框架的初心:我们希望解决的是 Creative Agentic RL 问题。
AIGC RL 的发展路径,最初主要集中在视频生成、图片生成模型的 RL 后训练;随后逐渐发展中间阶段的调度模型 RL;我们认为接下来的趋势是 AIGC 领域可能会进一步进入 Agentic RL 阶段,尤其是在 AI 漫剧等创意生产场景中。
我们设计这套框架是一个面向未来的布局(Plan for Future),希望在 Agentic AIGC 的需求真正爆发时,有一套开放的 RL 训练框架,能够支持这一阶段的发展。
最后做一个总结。
AIGC 从单次生成走向多步创作,Agent 化是图像视频生成自然的下一步。
推理侧 workflow 解决能不能串起来,RL 后训练解决能不能从反馈中学会。
UniRL 当前统一了多模态模型的 RL 后训练,Creative Agent 是正在探索的下一层。
UniRL 也在积极迭代,欢迎大家参与到我们的社区。
谢谢!



