用 AI Agent 做正经事的团队越来越多,有个问题也跟着来了。AI 批了一笔贷款,调了一个剂量,你回头问它为什么这么干,没人答得上来。模型说不上来,系统里也没地方查,「当时是怎么考虑的」压根没被留下来。
平时这事不着急,但金融、医疗这种行业不行,监管隔几个月回头问一句为什么,你得拿得出东西。所以圈里最近老提一个词,AI 问责,意思是 AI 做的决定,得有人能负责,也得有地方可查。
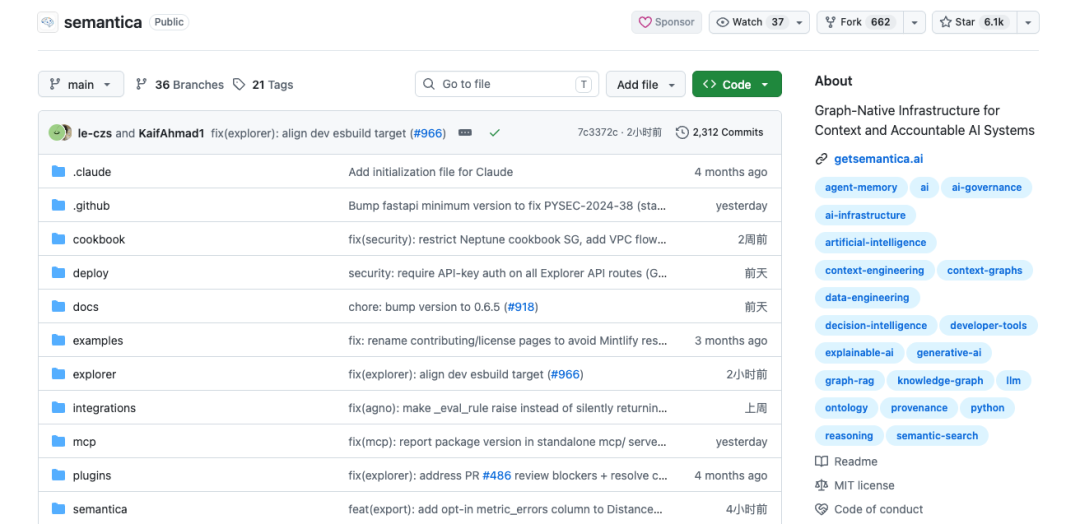
前两天刷 GitHub Trending,Semantica 这个开源项目登顶榜首,它干的就是这件事。
Semantica 是什么
Semantica 不是又一个 Agent 框架,也不是又一个向量库,而是垫在你现有技术栈底下的一层基础设施。原来的模型、向量库、Agent 框架都不用动,它补的是一直缺着的那一块:决策记录、因果推理、来源追溯、审计导出。 官方管自己叫 「给 AI Agent 用的开源版 Palantir」 。
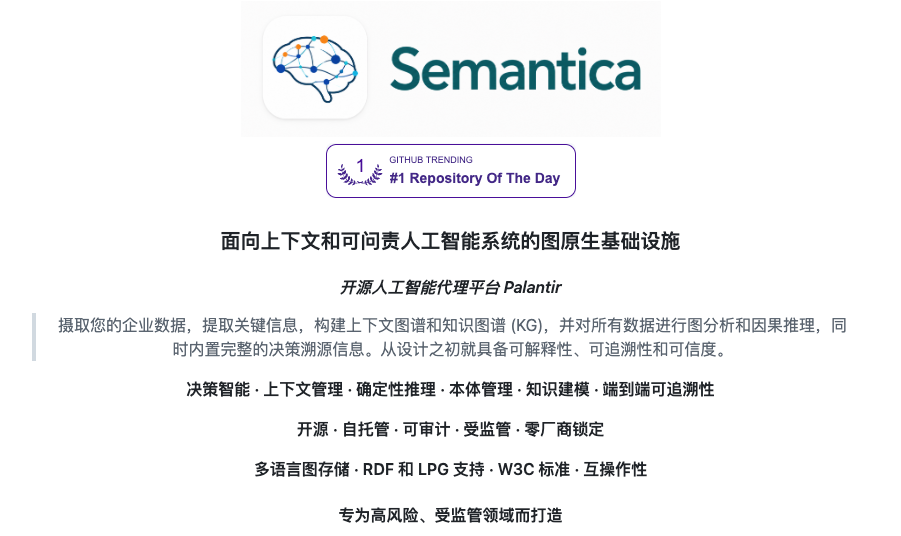
还有一点值得单独说,它的建图、推理、溯源这些核心环节不需要调大模型,是确定性运行的,同样的数据进去,出来的结果一样,每一步都能展开给人看。要拿去给审计看的东西,确定性是最要紧的,总不能监管问一次,系统给一个新答案。
功能详情
决策记录:每个决定都变成一条能查的账
这是 Semantica 最核心的一块功能,也是它跟普通知识图谱工具拉开差距的地方。
你可以把 AI 的每一次决策记成图里的一个节点,节点上带着场景、理由、结果、置信度这些信息。决策和决策之间还能标上因果关系,是谁导致了谁,谁影响了谁,或者谁参考了哪个先例。
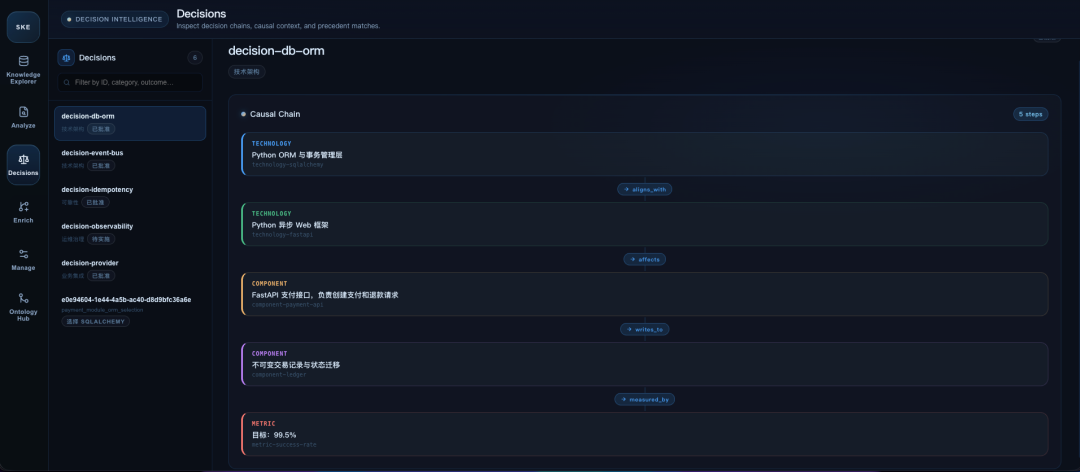
记完之后,想知道某个决定的来龙去脉,调一个接口就能把完整的因果链拉出来。想看看历史上有没有处理过类似的情况,可以按语义搜先例。
想知道这个决定后来影响了下游哪些环节,也有现成的分析接口可以用。最后审计要材料的时候,可以导出成 W3C PROV-O 格式,这是合规框架普遍接受的那类标准格式。
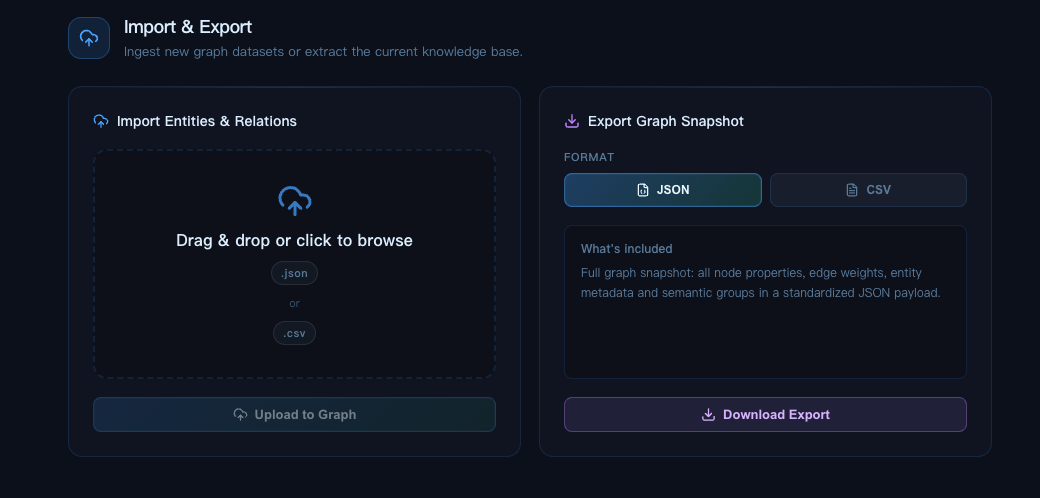
用一句话概括,决策在这个系统里不是一行刷过去就没影的日志,而是一个能被反复查询、能被追问的对象。问责这件事,就是这样落到实处的。
上下文图谱:不只回答「像不像」,还能回答「连不连着」
传统 RAG 靠向量相似度找内容,回答的问题是「什么东西和它像」。Semantica 的上下文图谱回答的是另一个问题,什么和什么连着,怎么连的,为什么连的。
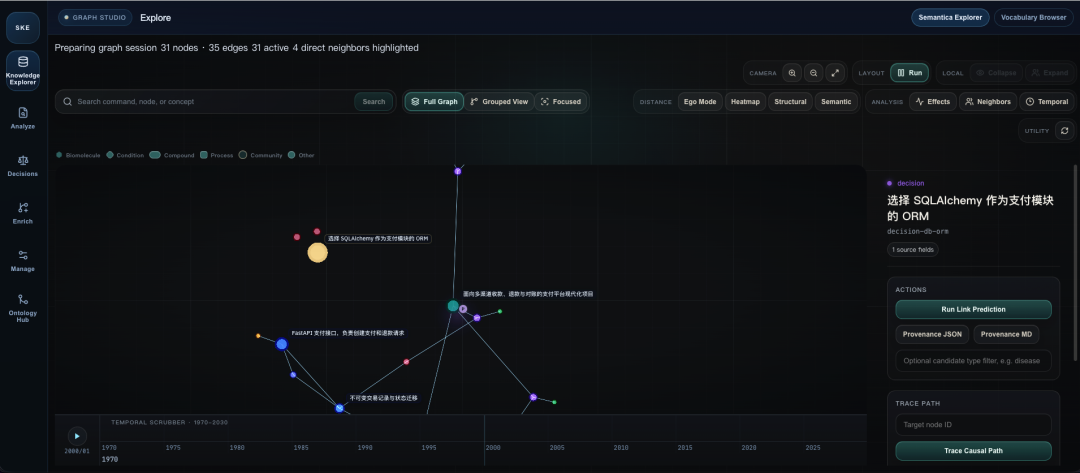
人、公司、合同、事件、决策,在图里都是节点,关系是边。哪怕一个人和一份合同中间隔了三层关系,图遍历也能一路走过去把它找出来,这种多跳关联是向量检索很难做到的。每条边还能带时间属性,所以你可以查这张图在过去某个时间点长什么样,相当于给整个知识库留了历史快照,想回放哪天的状态就回放哪天,不用把数据重新跑一遍。
冲突检测:两份数据打架,它会先标出来
从好几个来源往一个知识库里灌数据,数据打架是一定会发生的事。同一个员工,A 系统里写的职位是 CTO,B 系统里写的是技术副总裁。大多数方案的做法是后写进去的覆盖先写进去的,悄无声息,错的数据就这么留下来了,后面基于这个数据做的所有判断都跟着错。
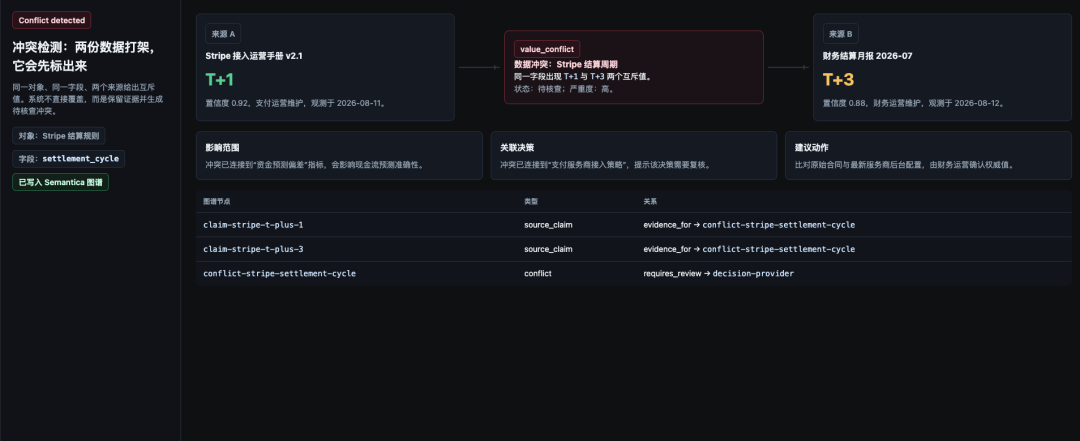
Semantica 的做法是先把这类冲突检测出来,标上严重程度,然后按你选的策略来处理。可以信来源可信度高的那个,可以信最新的那个,也可以让多个来源投票。重复实体也是类似的思路,先检测、再合并,合并的时候保留来源记录。整个过程都是摆在明面上的,数据脏不脏,脏在哪里,一查就知道。
来源追溯:每条事实都能问一句「你从哪来」
图里的每个实体、每条关系,都能挂上来源信息:来自哪个文件,第几页,哪个系统,用的什么提取器,置信度多少。任何时候你都可以反问任何一条数据的完整来历,顺着记录一直追到原始文档。
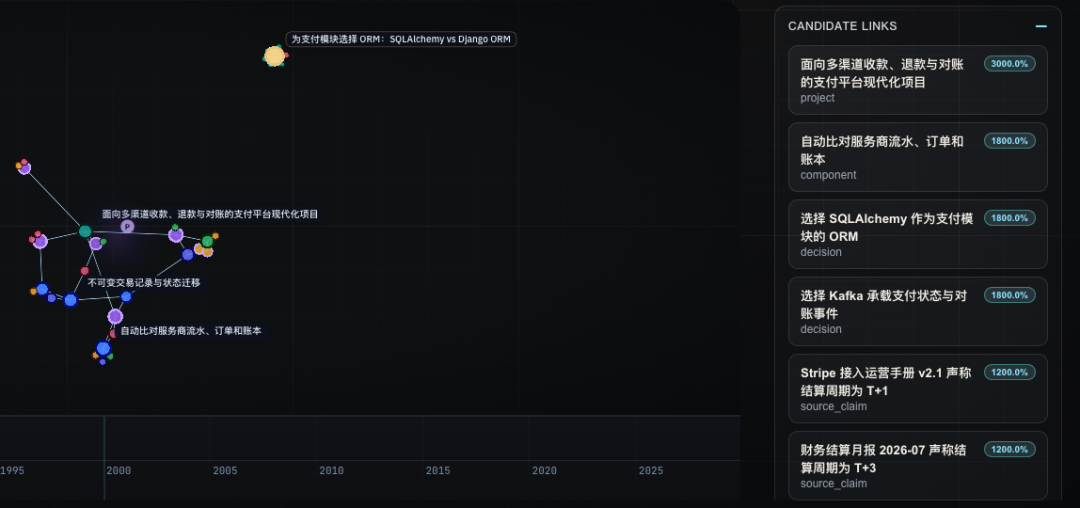
做过知识库的人都知道这个功能有多实在。数据出了问题,不用大海捞针,顺着溯源记录一查,就知道是哪个环节放进来的。
规则推理:写在明处的逻辑,推理路径能展开看
Semantica 内置了几种规则引擎,可以写条件规则跑推理。比如「金额超过一万、同时涉及某些地区的交易,标记为待审查」这种规则,写进去就能跑。跑出来的结论不是黑箱里蹦出来的,每一步推理路径都能展开,能说清楚这个结论是依据哪条规则、哪些事实得出来的。
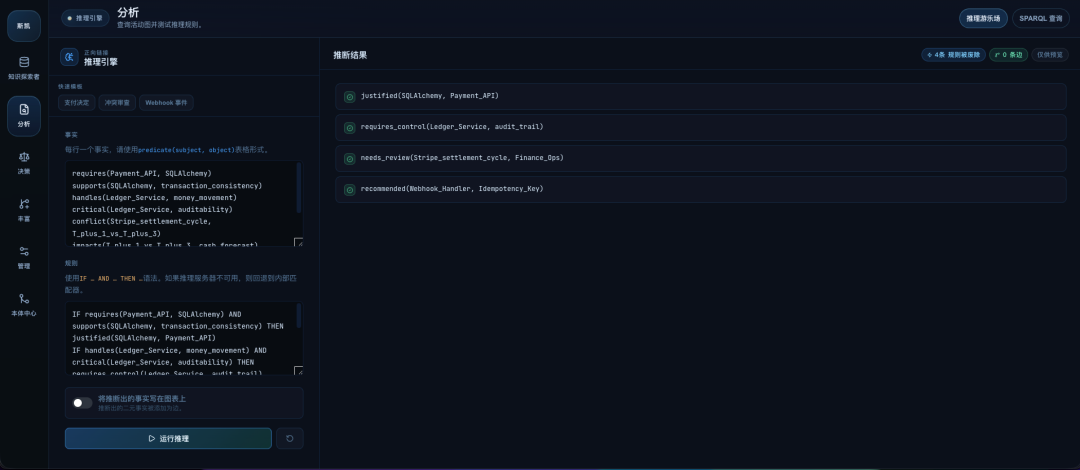
对问责和合规的场景来说,这点很关键。能被解释的规则,才是能拿去跟监管对话的规则。
数据接入和存储:进得来,也出得去
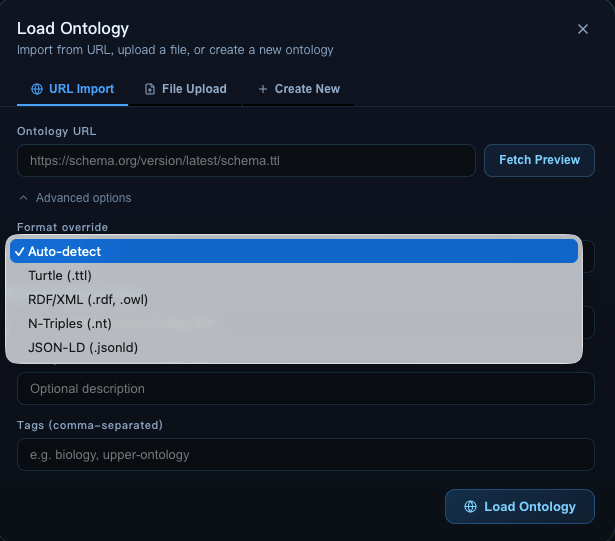
接入这块支持的很多,本地文件、网页、数据库、Kafka 这类消息流、Git 仓库、邮件都能进,Databricks 和 Snowflake 这种企业数据平台有现成的连接器,仓库里的表可以直接变成图节点,还带着血缘信息,省掉了先导出来再倒进去那一道工序。
存储这一侧也不挑,Neo4j、AWS Neptune 这类属性图数据库,或者各种 RDF 三元组库,再加上向量库,都可以换着用,换后端不用改业务代码。模型服务方面主流的都能接,DeepSeek 和 Ollama 本地模型也在支持列表里。导出格式有 RDF、JSON-LD、Parquet、Cypher 这些,不管是对接下游系统还是交审计材料都够用。
在 Codex 里直接用:决策记录跟着开发流程走
这部分是我觉得对开发者最实用的,Semantica 自带一个 MCP 服务器,也给 Codex 准备了现成的插件包,也就是说你在 Codex 里干活的时候,可以让它顺手把重要决策记进图谱里,不用单独写脚本。
先把 Semantica 的 MCP 服务跑起来:
python -m semantica.mcp_server
然后在 Codex 的配置文件 ~/.codex/config.toml 里加一段:
[mcp_servers.semantica]
command = "python"
args = ["-m", "semantica.mcp_server"]
重启 Codex 之后,Semantica 的能力就以工具的形式挂进去了,一共有16个,记决策、查决策历史、找先例、拉因果链、加实体、跑规则推理、导出图谱这些都在里面。
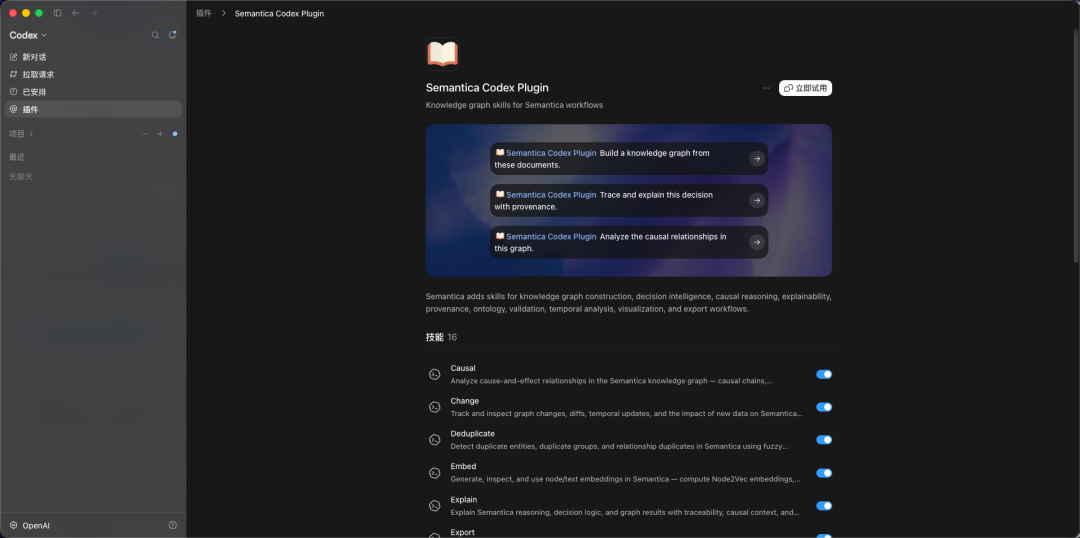
实际用的时候就是正常跟 Codex 说话,比如你们刚讨论完一个技术选型,可以直接让它把这个决定记下来:
「把刚才的决定记一下:支付模块的ORM选 SQLAlchemy 不选 Django ORM,原因是项目本来就用的 FastAPI,团队对 SQLAlchemy 更熟,置信度 0.9。」
它会调用 record_decision 把这条决策写进图谱。
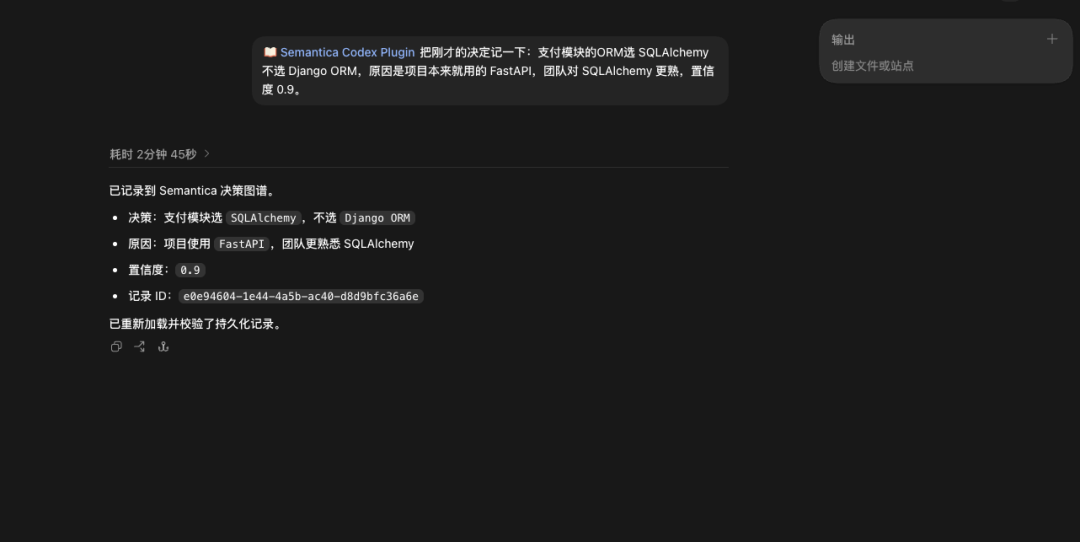
过段时间再想问起来,比如新来的同事不理解当初为什么这么选,你直接在 Codex 里问「当时支付模块为什么选 SQLAlchemy」,它会去图谱里把那条记录连理由一起翻出来。如果是一连串互相关联的决定,还能把完整的因果链拉出来看。
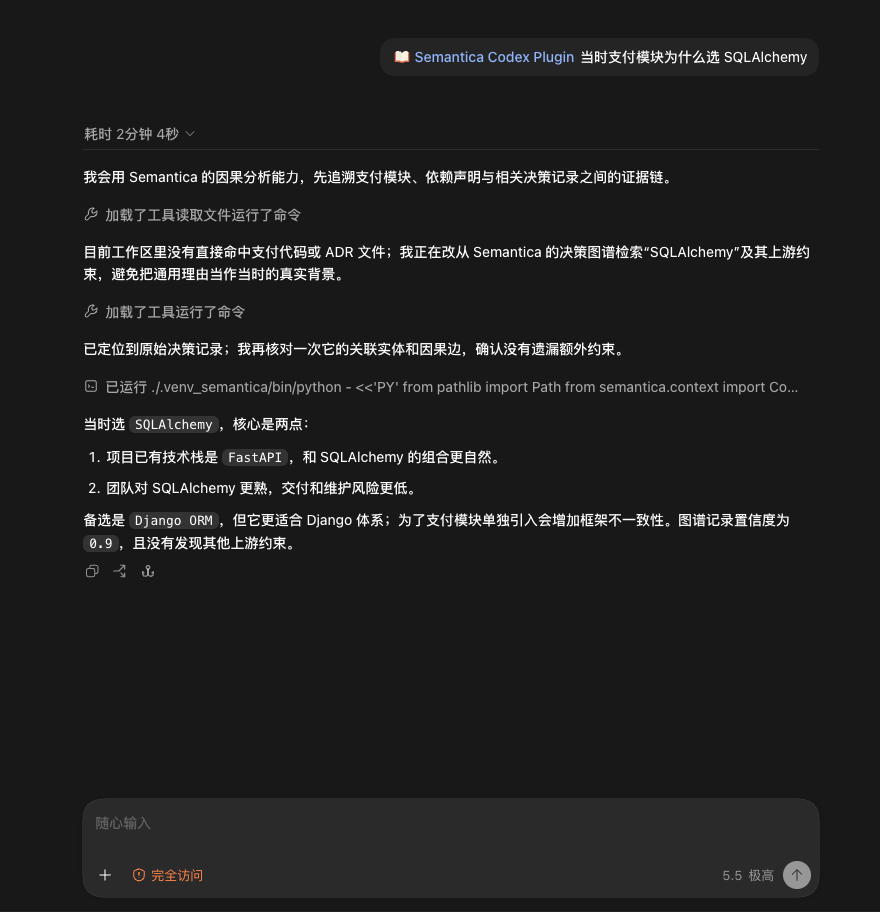
这个用法我觉得挺妙的。开发过程里的口头决策是最留不下来的东西,群里说一句就这么定了,三个月后没人记得为什么。现在讨论完顺手记一句,来龙去脉就存住了。
可视化和命令行:图是能用眼睛看的
它还带了一个浏览器里的可视化工作台,图结构、本体层级、时间线都能交互着看,决策的因果链也可以在工作台里一层层点开。
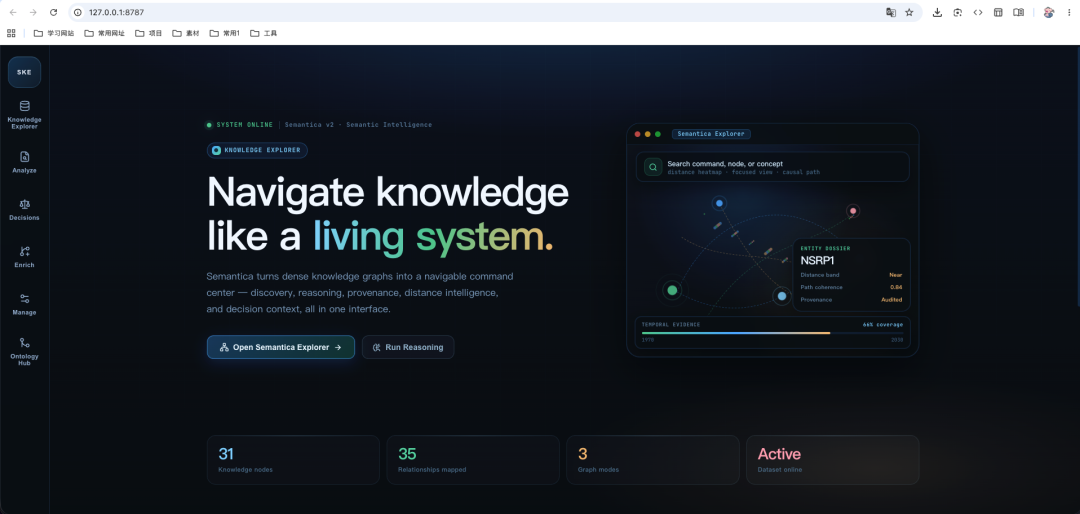
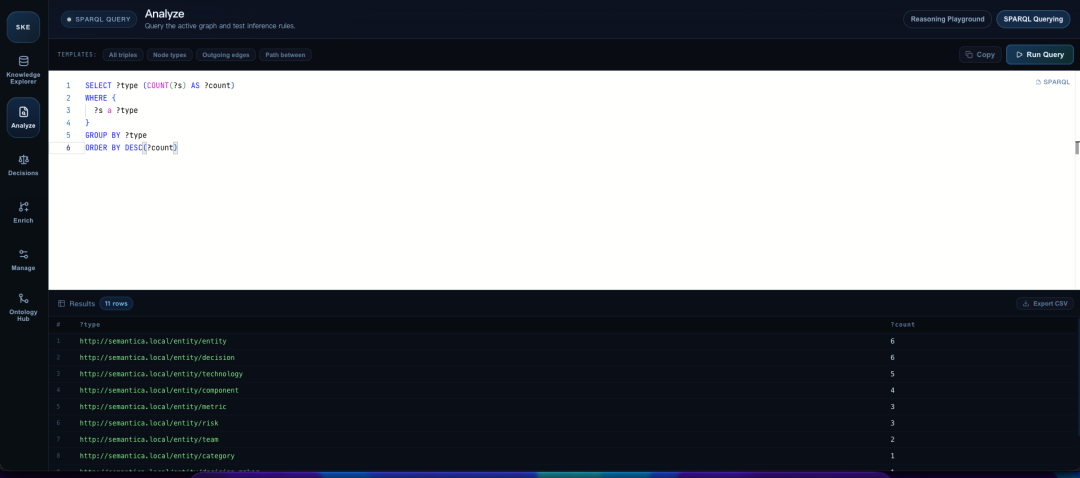
另外有个挺全的命令行工具,装包自带,不用额外装东西,从数据接入、建图、推理到导出都能在终端里完成。装完之后建议先跑一句
semantica doctor,它会自己检查环境有没有问题,这个细节做得挺好。
快速开始
安装就一行:
pip install semantica
装完跑个自检,确认环境没问题:
semantica doctor
然后可以拿最小的一段代码试试,记一条决策,再往回查一遍:
from semantica.context import ContextGraph

graph = ContextGraph(advanced_analytics=True)

decision_id = graph.record_decision(
    category="vendor_selection",
    scenario="为合规业务选云服务商",
    reasoning="签了数据处理协议,团队也熟",
    outcome="selected_aws",
    confidence=0.93,
)

chain   = graph.trace_decision_chain(decision_id)              # 查完整因果链
similar = graph.find_similar_decisions("云厂商选择", max_results=5)  # 找历史先例
不想写代码的话,用自带的 CLI 也能把主要功能都过一遍,上手成本不高。
使用场景
最典型的是银行信贷这类业务,AI 批了一笔贷款,从申请、审批到定利率,整条决策链都被记下来了,监管什么时候来查,什么时候都能完整拿出来。医疗场景也是一回事,用药审查、剂量调整这类决定,事后必须说得清依据,说清了才算数。
做企业知识图谱的团队也合适,特别是数据已经在 Databricks 或者 Snowflake 里的,连接器是现成的,不用再折腾数据搬运。合规和风控团队想要一份能直接交出去的审计材料,它能按标准格式导出。搞多 Agent 系统的也可以看看,几个 Agent 读写同一张上下文图,不用各记各的,事后出了问题也知道该找哪条记录。
还有就是上面说的开发团队自己用,技术选型、架构决策这些口头约定,用 Codex 顺手记进图谱,过几个月翻出来还是清清楚楚的。
反过来说,如果你只是写个聊天机器人,或者做个简单的文档问答,这套东西大概率用不上,没必要给自己增加复杂度。
最后聊聊
问责这个事,现在大家都在讨论 AI 该怎么管,我觉得管的前提是先能看见,看见它做了什么、为什么这么做,然后才谈得上负责。Semantica 做的就是「看见」这一层,如果你的 Agent 做的决定需要经得起几个月之后的一句「为什么」,值得认真试试。暂时没有这种需求的话,在 Codex 里挂上它记几天决策,体验一下每个决定都有账可查是什么感觉,也挺好。
开源地址
https://github.com/semantica-agi/semantica