今天分享一套能够快速产出论文的方法论,教大家如何解决各环节中常见卡点、轻松搭建论文生产链。
当然,基本每个环节我都准备了现成资源,主打一个一步到位,助你轻松科研~
下文中提到的90个深度学习数据集/100个医学数据集、各方向参考论文、366个即插即用模块、15个深度学习&机器学习必备画图工具都可直接扫码添加小享让TA无偿及时发送给你最新链接!
① 不用先学完所有理论,基础补到能做实验就行
已有基础可跳过。
高数、线代、概率论这些当然重要,但没必要一上来就把数学重新学一遍。更重要的是先掌握深度学习真正高频的部分:Python、Numpy、Pandas、Pytorch,以及数据预处理、模型训练、验证和测试这些基本流程。
做到:看到一篇论文 → 能看懂模型 → 能跑起来 → 能改代码。基础补到这个程度,就可以开始进入实战了。
② 定方向以后,第一件事是找数据
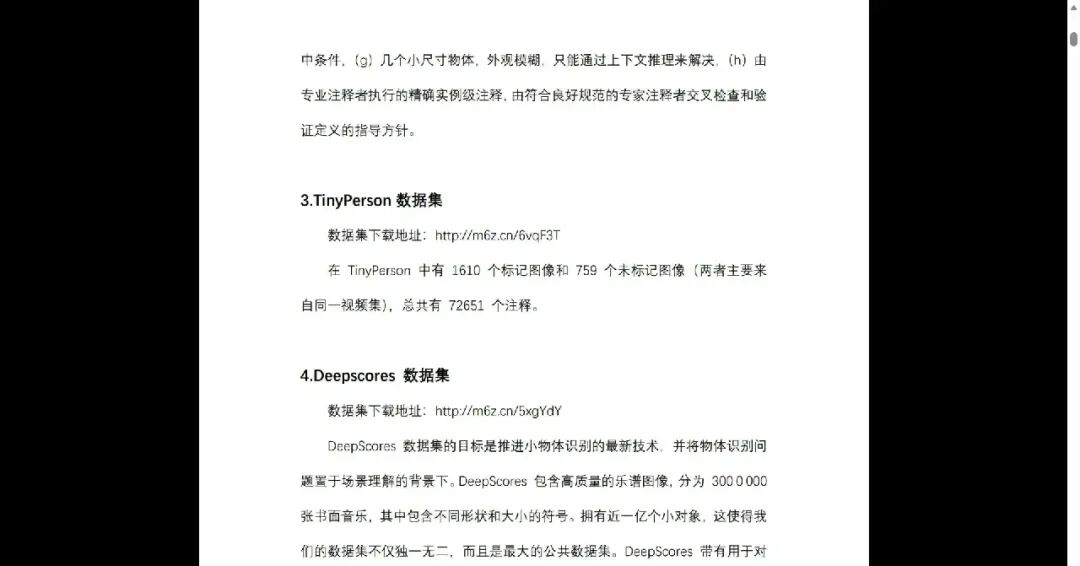
不要等创新点想好了才开始找数据。万一数据集不够合适咋办。所以确定研究方向后,可以先把这个方向常用的数据集看一遍,重点关注:
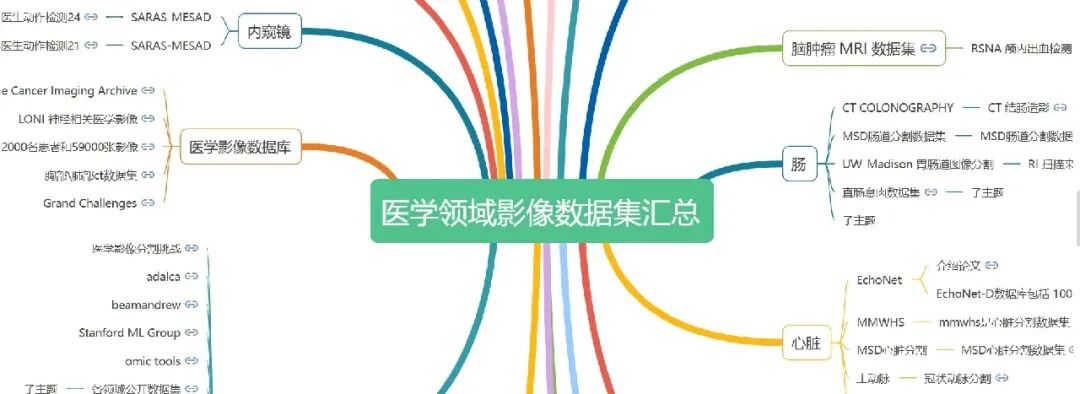
我自己整理了一份90个深度学习数据集,另外又整理了100个医学方向数据集,可以直接帮你找数据这个最容易浪费时间的环节省了。
③ Baseline不要乱选,选自己改得动的
很多人第一次做论文要么找一个五六年前的老模型,创新空间是有,但审稿人可能会问为什么不用更新的方法;要么直接追最新SOTA,结果模型太复杂、资源要求太高,最后连Baseline都没跑通。
更实际的思路是其实是找近几年性能不错、有代码、结构相对清晰,而且自己实验室资源能够承受的模型。
先完整复现一次。注意不要只看论文里的结构图,最好把每个模块、输入输出Tensor、数据流向都摸清楚。因为只有真正理解Baseline,后面才知道到底应该在哪里改。
各个大热方向及其相关方向的参考论文我基本都整理过一遍,可以加小享给TA发你的方向,有对应论文合集会直接发给你。
④ 第一次做创新,不一定非得从零造模型
对于刚开始做论文的人,我反而比较建议先从成熟的即插即用模块入手。比如:注意力机制 → 多尺度特征 → 特征融合 → 卷积改进 → Transformer模块 → 特征增强。
从不同论文里找到适合自己Baseline的模块,再尝试串联、并联或者交互融合。
关键不是缝得越多越好,而是要写清楚:为什么加这个模块?它解决了Baseline的什么问题?为什么组合以后应该有效?然后通过消融实验、对比实验把这个逻辑验证出来。
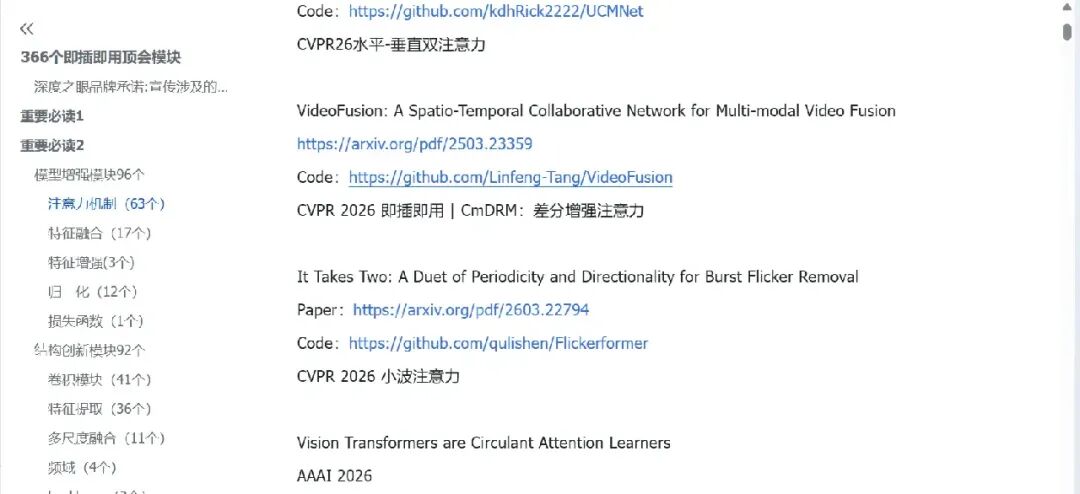
我这边也整理了366个即插即用模块,来源于CVPR、ICLR、ICML、NeurIPS等顶会,分为了5大类:模型增强、结构创新、前沿技术、效率优化、特定场景应用。你可以随时拿来调用,这肯定比自己从几百篇论文里翻模块省时间。
⑤ 实验做好以后,论文呈现也非常重要
很多论文做到最后,模型可能还不错,但图表、实验可视化、网络结构图做得比较粗糙,整体完成度一下就下来了,要知道漂亮的图表可以很大程度上提高审稿人的阅读体验(懂的都懂)。
所以我还整理了一套深度学习&机器学习常用画图工具,共15个,主要解决模型结构图、实验结果可视化、论文图表这些实际问题,帮你提高中稿率。




