随着开源模型能力不断提升,它们已经能够以极低的成本生成多个高质量候选方案,并进一步利用模型自身对这些结果进行验证、打分和筛选。斯坦福团队最新实验发现,使用 DeepSeek V4 Flash + LLM-as-a-Verifier 进行「自验证」,可以在 Terminal-Bench 2.1 上超越 Claude Fable 5,同时整体成本低约 11 倍。
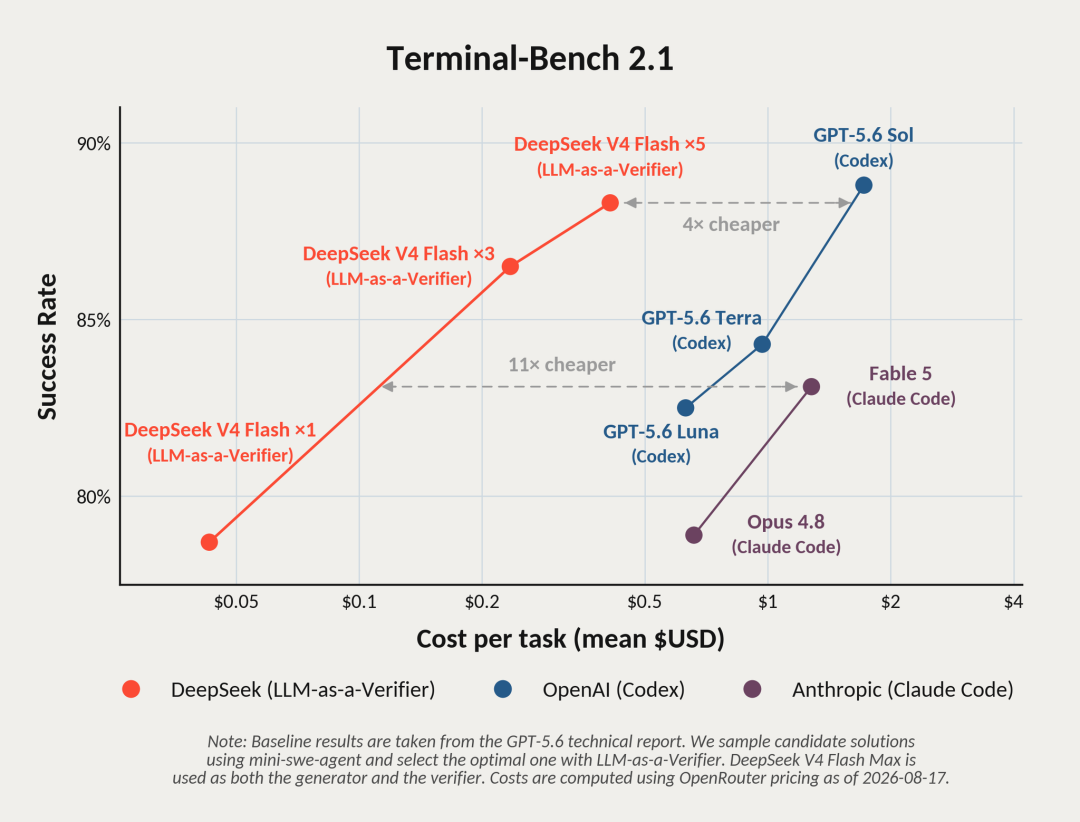
具体来说,团队首先让 DeepSeek V4 Flash 针对同一个任务生成 5 条候选 Agent 轨迹。随后,不引入任何能力更强的闭源模型,而是继续使用同一个 DeepSeek V4 Flash,通过 LLM-as-a-Verifier 验证框架对这些候选结果进行验证、打分和排序。最终,DeepSeek V4 Flash 在 Terminal-Bench 2.1 上的任务成功率从:79% → 88%。
值得注意的是,这里的成本并不只是验证成本,而是同时包含两部分:生成 5 个候选方案的成本,以及使用 DeepSeek V4 Flash 进行验证和筛选的成本。「自验证」确实会消耗更多 Token,但由于开源模型的 Token 成本足够低,即使加入额外的采样和验证,整体单任务成本依然显著低于闭源前沿模型。并且,上述成本已经按照 DeepSeek 涨价后的最新价格计算。
在延迟方面,自验证也不意味着需要串行等待 5 次完整生成。多个候选方案可以并行生成,大部分验证过程同样可以并行执行。在并发资源充足的情况下,整体延迟大致相当于:耗时最长的一次 Agent rollout + 少数几轮验证。因此,候选数量增加并不会让端到端延迟按比例增长。
随着实验结果发布,LLM-as-a-Verifier 在 X 上引发广泛讨论,同时也冲上了 GitHub Trending 热榜 #2。与此同时,开源社区已经开始在 DGX Spark 等本地硬件上部署 GLM、DeepSeek 等模型,并复现类似的自验证结果。这可能会成为本地 AI 非常重要的一条发展路线:当本地和开源模型足够便宜时,与其把所有希望押在一次生成上,不如通过「多次采样 → 自我验证 → 选择最优结果」,用更多廉价的推理计算持续换取更高的能力。
本项目由斯坦福大学 CS 博士生 Jacky Kwok 负责。通讯作者包括 Ion Stoica(UC Berkeley 教授、Databricks 联合创始人)、Azalia Mirhoseini(斯坦福大学教授,曾任职于 DeepMind 与 Anthropic)、Marco Pavone(NVIDIA AI 与自动驾驶研究总监)以及 Chelsea Finn(斯坦福大学教授、Physical Intelligence 联合创始人)。
API 文档:https://llm-as-a-verifier.com/docs
-
GitHub 代码:https://github.com/llm-as-a-verifier/llm-as-a-verifier
论文:https://arxiv.org/pdf/2607.05391
联系方式:jackykwok@stanford.edu
更多关于 LLM-as-a-Verifier 的实验结果与分析详见下文:
方法概述
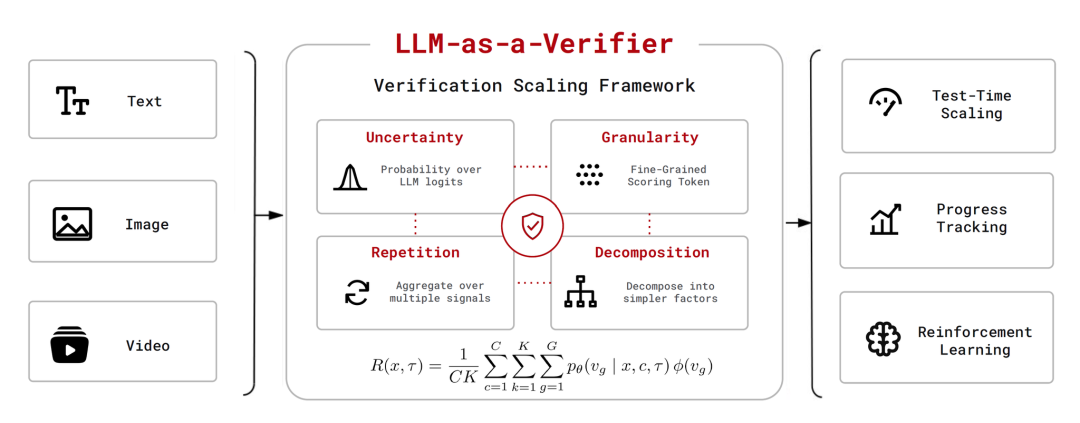
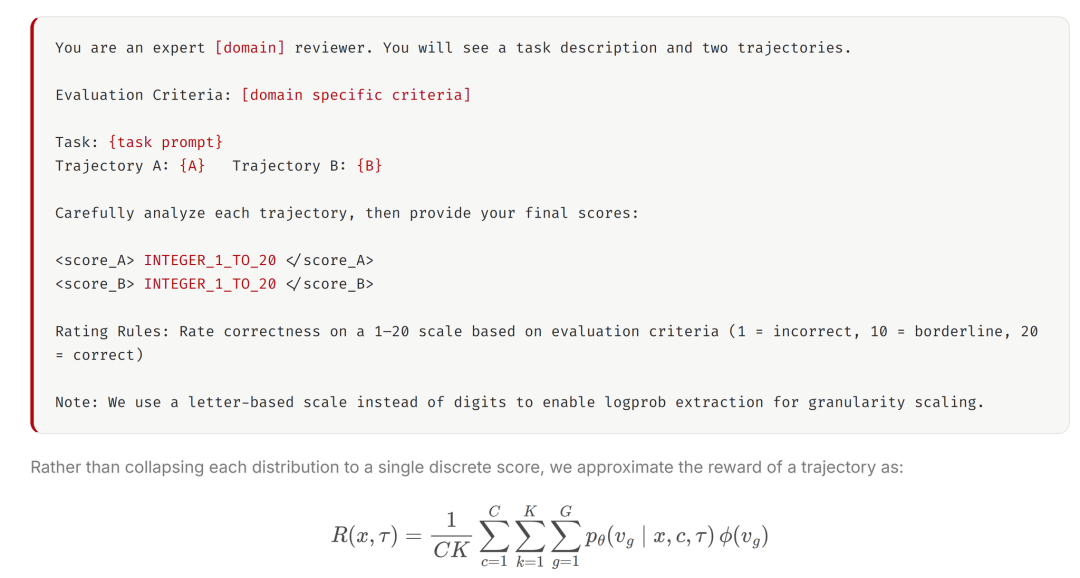
LLM-as-a-Verifier 是一个通用验证框架,无需额外训练,即可为不同模态的模型输出提供细粒度反馈。与传统 LLM-as-a-Judge 只输出单一离散分数不同,LLM-as-a-Verifier 利用了评分 Token 的完整 logit 概率分布,从而显式刻画模型在评价过程中的不确定性,并使验证能力能够沿着三个维度进一步扩展:评分粒度(score granularity)、重复评估(repeated evaluation)以及评价标准拆分(criteria decomposition)。由此得到的细粒度反馈可以进一步用于 Test-Time Scaling、任务进度追踪以及强化学习。
1)推理阶段扩展
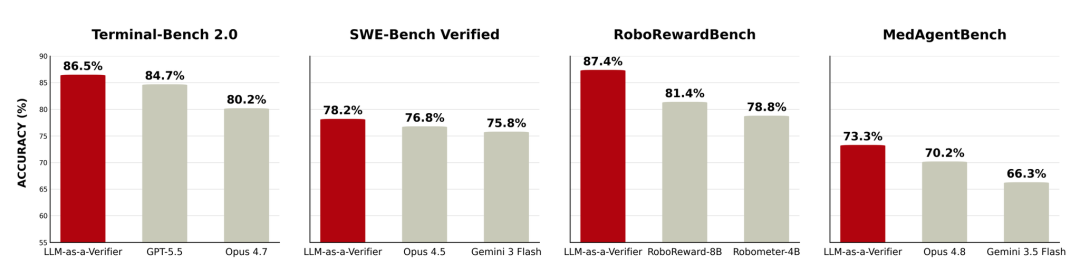
当 LLM-as-a-Verifier 被用作轨迹级 Reward Model,对多个候选解进行验证和排序时,在多个不同领域的 benchmark 上均取得了领先结果:Terminal-Bench V2 (86.5%), SWE-Bench Verified (78.2%), RoboRewardBench (87.4%), and MedAgentBench (73.3%)。
这些结果表明,同一套验证框架可以用于软件工程、机器人以及医疗 Agent 等不同任务,而无需针对每一个领域单独训练新的 Reward Model。
2)强化学习
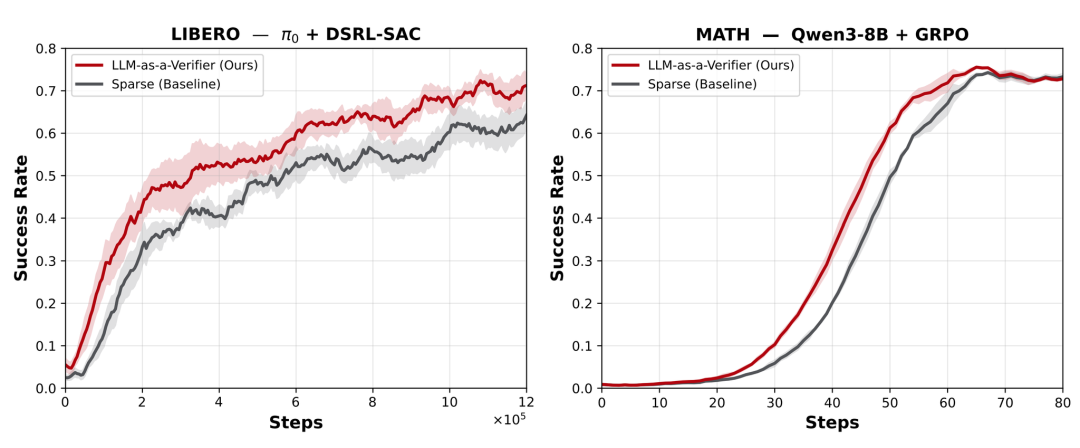
LLM-as-a-Verifier 也可以直接作为强化学习中的稠密奖励信号(dense reward)。实验显示,将其反馈接入 SAC 和 GRPO 后,可以在机器人控制与数学推理任务中提升训练的样本效率。
3)代码生成进度追踪
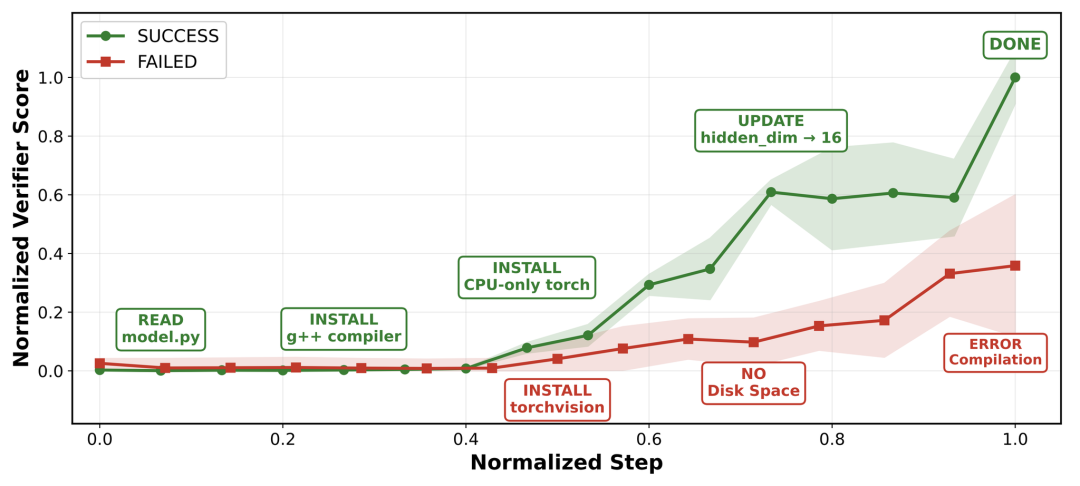
LLM-as-a-Verifier 给出的评分与代码 Agent 的实际任务进展之间存在明显相关性。随着代码生成和任务执行逐步接近正确解,Verifier 的分数通常也会随之提升。这意味着它不仅可以用于比较最终的多条候选轨迹,也可以用于实时追踪 Agent 是否正在朝正确方向推进。
4)机器人任务进度追踪
类似的现象也出现在机器人任务中。在一次完整的 robot rollout 过程中,LLM-as-a-Verifier 能够生成平滑、与时间进度对齐的奖励信号,并能够区分多种失败模式,例如:
机器人理解了错误的任务意图
抓取位置不准确
动作执行偏离目标
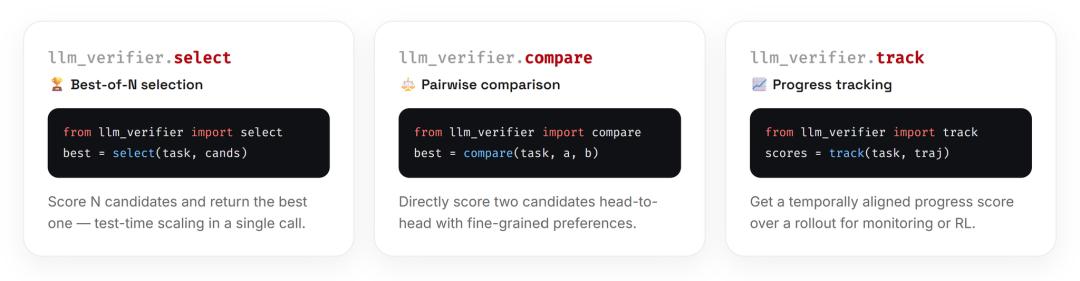
API:几行代码即可接入自己的任务
LLM-as-a-Verifier 已经提供开源 Python API,可以直接安装:
研究动机:Agent 往往「会做」,但不知道哪一次做对了
LLM-as-a-Verifier 背后的一个核心观察是:很多 Agent 其实已经「知道」如何完成任务,真正的问题是,它们不知道自己生成的哪一个答案才是正确的。
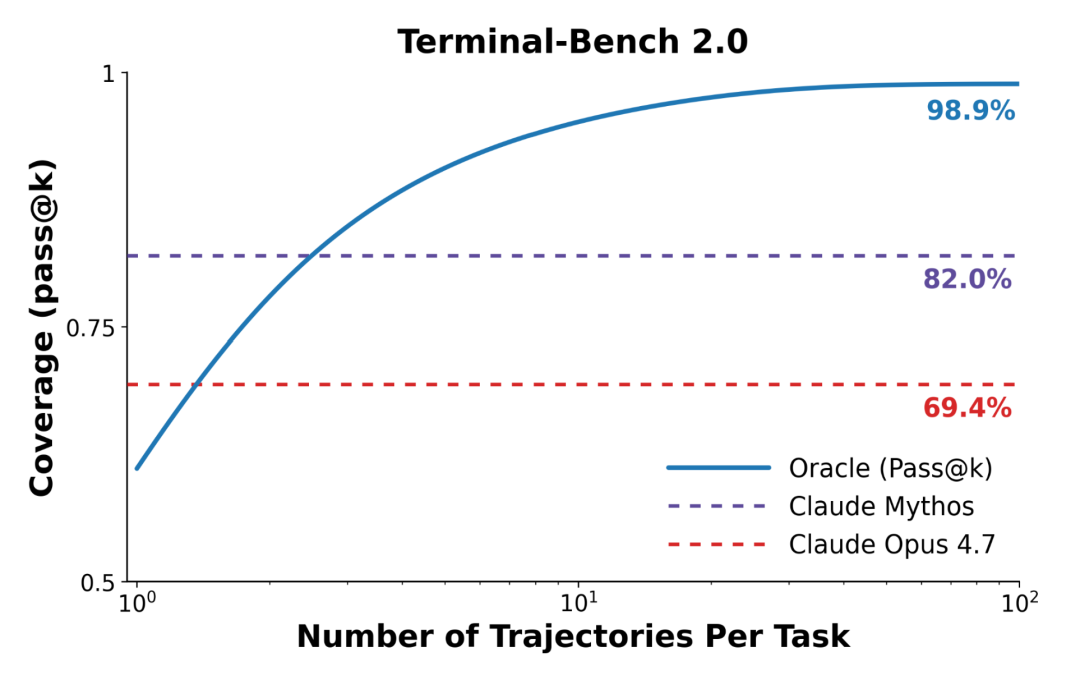
以 Terminal-Bench 为例,如果针对同一道任务反复采样大量轨迹,例如每道题生成 100 条候选轨迹,模型的 Pass@100 可以显著超过 Claude Mythos,并接近解决整个 benchmark。真正困难的问题变成了:如何从大量候选轨迹中,可靠地找出正确的那一个?这也是 Verification Scaling 希望解决的核心问题。
核心问题:平局
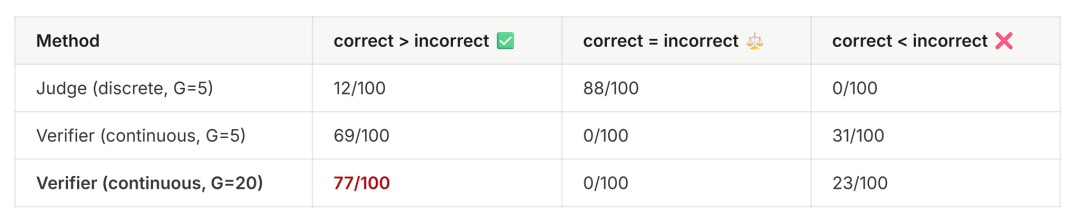
最简单的方法是让 LLM-as-a-Judge 对不同候选解进行评分。但问题在于,当候选方案都比较复杂、质量又比较接近时,传统 Judge 往往无法提供足够细粒度的区分能力。例如,在 Terminal-Bench V2 上,使用离散评分的标准 LLM-as-a-Judge 会出现高达 27% 的平局(tie)。两个质量明显不同的候选方案,可能都会被模型打成同一个分数。
案例分析:利用评分 Token 的概率分布
和更高的评分粒度打破平局
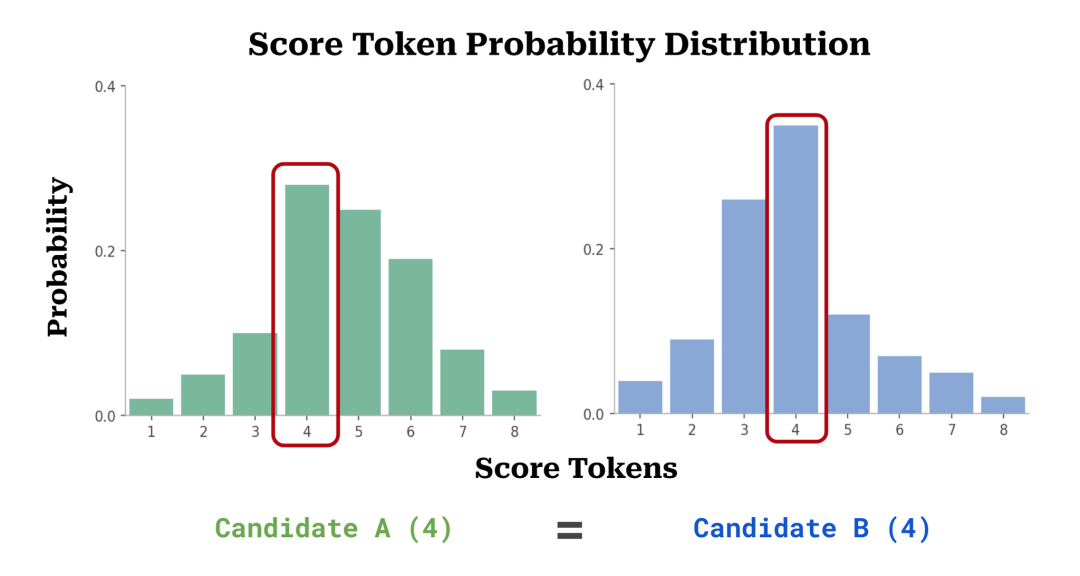
LLM-as-a-Verifier 的关键思路之一,是不再只读取模型最终输出的那个离散评分,而是进一步利用评分 Token 的完整 logit 概率分布。通过对评分分布求期望,可以把原本离散的评分转化为更加连续、细粒度的概率性评价。
以 query-optimize 任务为例,传统离散 Judge 几乎总是给两条轨迹相同的分数。而 LLM-as-a-Verifier 利用评分 Token 的概率分布以及更高的评分粒度(1-20)后,在 100 次比较中有 77 次正确选出了更好的轨迹,同时没有出现一次平局。
验证 Scaling Law:多个评估维度应协同扩展
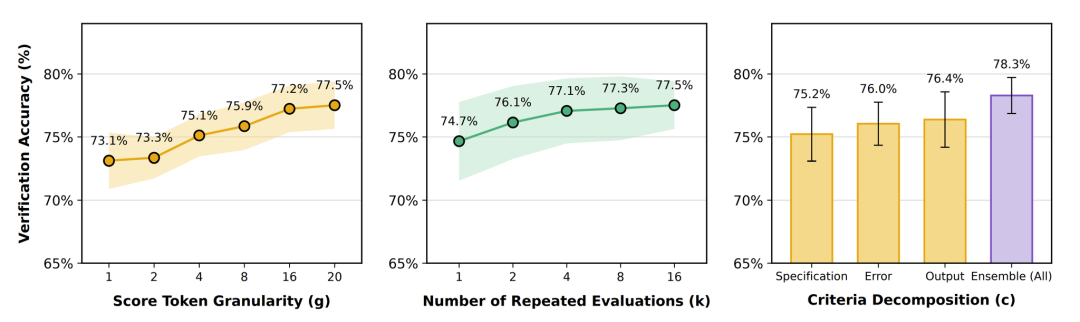
这种概率化的评价方式,使得 Verification 本身也可以像生成一样 Scale。与 Kaplan 等人提出的 Scaling Laws 类似:数据规模、模型规模和计算量需要协同扩展,才能获得最优性能。
团队的结果表明,评分粒度(score granularity)、重复评估(repeated evaluation)和评价标准(criteria decomposition)同样能够带来互补的性能增益,因此也应该进行联合扩展(scale in tandem)。
示例 Prompt 与细粒度奖励
排序算法:复杂度从 O (N²) 降至 O (Nk)
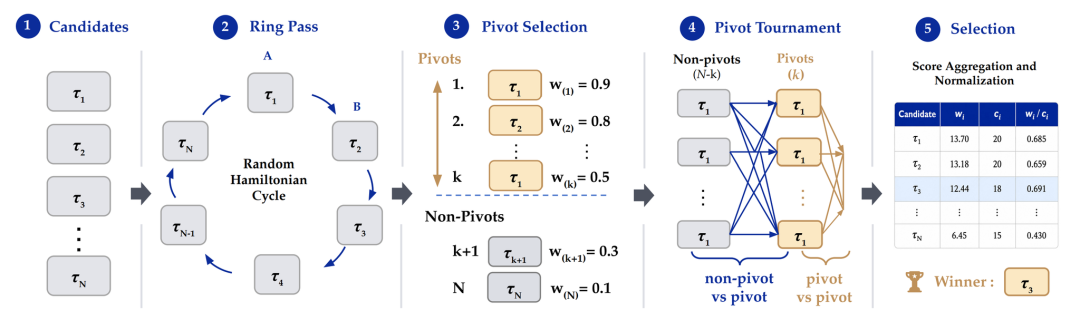
当候选数量不断增加时,另一个现实问题是验证成本。如果对 N 个候选方案进行完整的两两比较,需要进行大约 O (N²) 次验证。随着 N 增大,这种方法的成本会迅速上升。
为此,团队进一步提出了一种更加高效的候选选择算法。
该方法利用 Verifier 输出的 preference probability,只需要让每个候选方案与少量 pivot candidates 进行比较,就能够近似完成整个候选集合的排序。最终,选择复杂度可以从:O (N²) → O (Nk) 其中 k 是一个较小的 pivot 数量。
总结
随着开源模型能力不断提升、推理成本持续下降,「自验证」正在成为一种越来越可行、也越来越经济的能力扩展方式。Verification Scaling 也有可能成为继 Pre-training、Post-training 和 Test-Time Scaling 之后,另一条重要的 Scaling 路线。
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com