如今,大模型迭代速度越来越快,不但要会用,更会选择。
这时候有的人回去找排行榜,但排行榜上的跑分很难直观量化到具体工作;也有的人沿用上次体验,但科研不是聊天,单“凭感觉”还差一截。
本期我们不推荐,只把 GPT-5.6 Sol、DeepSeek V4 Pro 和 Gemini 3.5 Flash 放进同一场小测:先看纸面,再看它们怎样处理一份论文衍生出的微型任务。
| 01 纸面跑分
既然是评测,那么跑分总是要聊一下的。数据采用 2026 年 8 月 26 日保存的 Artificial Analysis Intelligence Index v4.1.1 快照。
1 智能指数
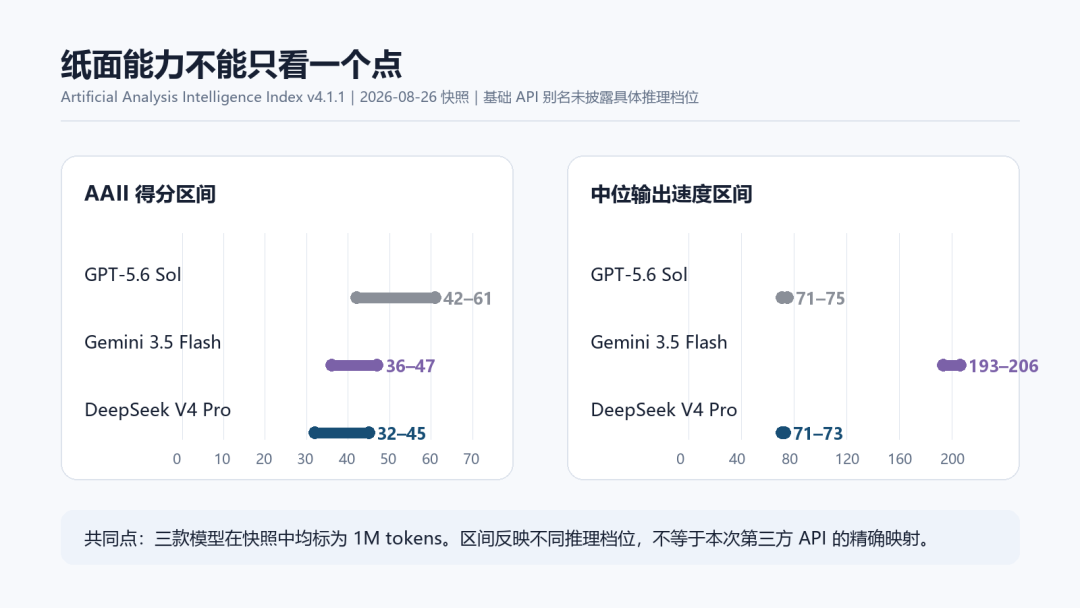
通通过表格不难看出,GPT-5.6 Sol 的上沿最高,说明它在较高推理档位上拥有更高的综合测试空间。DeepSeek V4 Pro 的基础版与高档差距明显,Gemini 3.5 Flash 也存在 minimal 与 medium 两档。
此外,这个分数差距同时也提醒了我们,哪怕是相同模型,在不同思考等级下,成绩也会有显著不同。
2 输出速度
榜单记录的中位输出速度中,Gemini 3.5 Flash 约为 193—206 tokens/s,GPT-5.6 Sol 约为 71—75 tokens/s,DeepSeek V4 Pro 约为 71—73 tokens/s。不过,这里的“快”指开始输出后的生成速度,不等于整项任务的等待时间;推理档位、首块延迟和接口链路都会改写实际体验。
3 上下文与价格
上下文方面,本次选取的这三款模型,均支持1M Tokens的上下文长度,这项指标如今也正在成为越来越多模型的标配。价格方面,可以看到 DeepSeek V4 Pro即使考虑到涨价,纸面价格还是有一定性价比的。
GPT-5.6价格表
DeepSeek V4 价格表
不过这里的价格都只是相对的。一方面,实际花销还要看各大模型的Tokens 消耗量;另一方面 由于本次测试中GPT和 Gemini 我们都采用的是第三方API转接,再加上DeepSeek的价格可能会随着使用时段而波动,因此价格其实不适合在这里硬比。
4 总结
如果只看纸面,GPT 的高档位更适合需要较强综合推理、又能接受更长等待的任务;Gemini 的生成速度适合批量整理和快速迭代;DeepSeek 的首块延迟在所列基础档位中较低,适合需要较快进入正文的工作流。
当然,这些只是榜单层面的适用倾向,接下来才是同题实测。
| 02 微型科研任务实测
1 测试流程
为了能够在可控成本下,评测三个模型在实际科研场景中的表现。我们从一篇 UGC 产品激励机制研究中,抽取了 8 个统计量,不提供原文,只保留局部频数、重要性指数和必要字段说明。
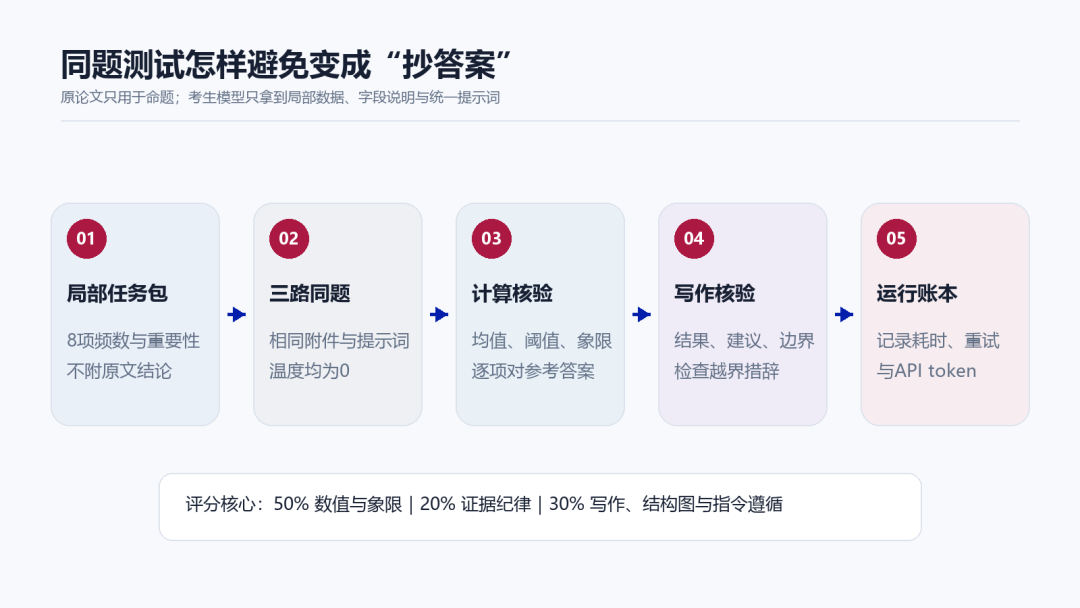
接下来将这些提取到的资料单独打包,再分别发给这三个模型。
为本次评测准备的”题目“
任务包要求模型完成五件事:从五级频数重算满意度均值、计算满意度和重要性阈值;划分四象限;找出优先差值最大的项目与近阈值敏感项;再把数字写成论文式结果、产品建议和证据边界。计算、解释、写作、克制,四种能力被压进同一份短答题。
2 统一提示词摘要
# 统一任务:UGC 设计因素的局部证据分析你是一名独立复现者。请只依据附件 `02_UGC局部数据.csv` 和 `03_研究情境与字段说明.md` 完成任务;不得联网,不得引入外部知识,不得假设附件未提供的样本特征、检验结果或因果关系。## 任务1. 对每个项目计算满意度加权均值: `满意度 = [1×不满意 + 2×较不满意 + 3×一般 + 4×较满意 + 5×满意] ÷ 该行样本数`2. 以 8 个项目的满意度均值之平均数为“满意度阈值”,以 8 个项目的重要性指数之平均数为“重要性阈值”。计算时保留未四舍五入值,展示时统一保留 4 位小数。3. 阈值相等时归入“高”;据此把每项归入以下一种: - 高满意-高重要:核心优势 - 高满意-低重要:维持项 - 低满意-高重要:优先缺口 - 低满意-低重要:低优先项4. 计算描述性“优先差值 = 重要性指数 − 满意度”。该差值不是效应量,也不代表因果效应。5. 找出满意度最接近阈值的项目,并说明其分类为何可能对阈值或抽样波动敏感。## 严格输出格式### A. 计算结果先报告两个阈值,再给出 8 行 Markdown 表格,列为:`项目ID|n|满意度|重要性|优先差值|象限`。不得遗漏项目。### B. 决策结构图给出一段可渲染的 Mermaid `flowchart`,最多 7 个节点,清楚表达“原始频数→计算指标→确定阈值→象限分类→建议”,并包含“证据边界”节点。不要重复粘贴整张结果表。### C. 学术结果叙述用 180–250 个汉字写成一段可放入论文结果部分的文字。区分数据事实与解释;报告主要高低模式和最接近阈值的项目;不得使用“导致、提升了、证明了、显著”等超出材料的措辞。### D. 产品建议用 120–180 个汉字提出两项建议。只选择“优先缺口”中优先差值最大的两个项目;每项均需说明数据依据,并把建议写成“待验证的设计方向”,不得声称实施后必然增加 UGC。### E. 证据边界恰好列 3 条,每条不超过 45 个汉字。至少覆盖:推断类型、样本/外推、缺失的统计或测量信息。若材料不能支持某项判断,直接写“无法判断”,不得补造。
三款模型拿到完全相同的附件和提示词,温度设为 0。GPT 与 Gemini 走同一第三方平台,DeepSeek 使用官方 API。为了防止AI输出过多内容,第一次输入时我们限制可见输出不超过 900 tokens;如果无法输出,则重试时不再设置过低的接口硬上限,避免隐藏推理先把额度用完。
评分表满分 100 分,计算与象限占一半,证据纪律占 20 分,其余考查学术写作、结构图和指令遵循。
评分标准(部分)
这套题并不追求难倒模型。它更像一张科研工作流切片:数字错一位,后面的象限就会跟着偏;措辞多走一步,描述性结果就可能被写成因果结论。模型要同时管住计算器和笔尖。
| 03 输出结果展示与评价
输出结果展示
3.1 GPT-5.6 Sol
GPT 一次完成,正文最紧凑。它把“T05 距阈值仅 0.0161”写得很清楚,还主动补上“象限只代表样本内描述,不表示统计显著性或因果效应”。建议部分没有把 UGC 行为当成已经发生的结果,整份答案像一位知道何时收笔的分析助理。
3.2 DeepSeek V4 Pro
DeepSeek 的成功稿最像复现记录:先声明“计算使用未四舍五入值”,又重申“阈值相等归入高”,证据边界也把横断面、单一平台、无概率抽样和缺失检验逐层交代。代价是隐藏推理很长。第一次请求在 8192 个输出 tokens 处结束,只返回思考内容;放宽后才交出正文。
3.1 Gemini 3.5 Flash
Gemini 的成功请求最快,学术段落也最顺滑。它对 T05 的敏感性解释完整,建议严格落在 T08、T07。
| 03 输出结果评价
先说结果。三款模型在成功返回的答案中,都算对了 8 个满意度均值、两项阈值和 8 个优先差值;四象限、优先缺口、建议顺序与近阈值项目也完全一致。它们都选择了 T08、T07 作为两项优先建议,并把 T05 识别为对阈值变化敏感的项目。
按照预先写好的评分表,因此按照预先设定的可量化评分标准,三份成功答案均为 100 分。题目边界清楚、数据规模小,内容质量出现了“满分饱和”。由此可见,对结构化的小型科研任务,一份写明计算口径、字数和禁用措辞的提示词,足以把模型差异压得很小。
模型 |
内容分 | 成功请求 | 首次记录 | 可见特点 |
GPT-5.6 Sol | 100 | 47.0秒
3,743 tokens | 一次完成 | 紧凑;边界措辞明确 |
Gemini 3.5 Flash | 100 | 19.8秒
6,159 tokens | 断连后成功 | 成功请求最快;计量字段异常 |
DeepSeek V4 Pro | 100 | 144.6秒
11,725 tokens |
放宽后成功 | 复现细节完整;隐藏推理较长 |
| 04 成本分析
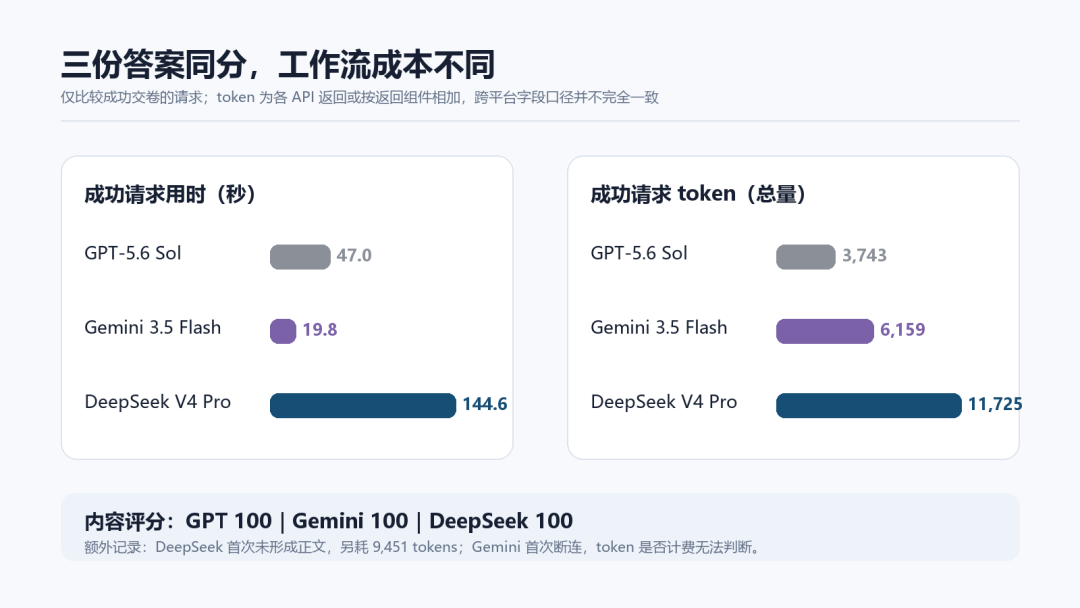
只看成功交卷的请求,GPT 用时 47.0 秒,API 报告总计 3743 tokens;Gemini 用时 19.8 秒,网关报告总计 6159 tokens;DeepSeek 用时 144.6 秒,按官方返回的 107 个未命中输入、1152 个缓存输入和 10466 个输出相加,共 11725 tokens。
但“成功请求”不是全部成本。DeepSeek 在此之前还有一次未形成可见答案的请求,消耗了 107 个未命中输入、1152 个缓存输入和 8192 个输出 tokens,合计 9451。Gemini 的首次请求由远端直接断开,接口没有返回 token 用量。GPT 在正式记录中一次完成。
当然由于三家接口的缓存、推理与可见输出字段定义不同,这些数字适合做“本次任务账本”,不宜换算成一张貌似精确的跨平台价目表。
| 05 尾声
这次横评最有意思的地方,不是三款模型谁“赢了”,而是它们在一张小试卷上同时拿满分后,真正可见的差别变成了等待、重试和 token。排行榜告诉我们能力上限,任务账本告诉我们今天这件事做起来顺不顺。
科研里很少有一个模型永久适合所有环节。真正省钱的选择,往往不是追逐当天最高分,而是知道这一步更缺速度、推理预算,还是一份能直接进入文稿的克制表达。



