论文初稿刚有点气势,GPT 下一句就开始后退:“可能”“或许”“仍需进一步验证”轮番出现。结论没错,读起来却像每句话都在先写免责声明。
常见补救是让它“大胆一点”或反复删犹豫词。面对短文还能救,到了长稿,它往往删完这一段,又在下一段补回更多限定。
这类过度防御想要收住。关键是先划清证据与任务边界,再规定哪些提醒该保留、放在哪里。下面从写作、代码和长对话三个场景逐一处理。
| 00 何为过度防御
这里说的“过度防御”,不是把必要的科研限定全部删掉,而是模型在没有新增信息的情况下,反复补充风险、例外和退路。它常见于三种地方:正文每段都加一句“仍需进一步研究”;代码为极小概率情形叠加校验、回退和兼容层;长对话中不断复述限制,主任务反而越说越散。
这通常不是一个词造成的。提示词没有说明证据边界,模型会自行猜测哪里可能出错;没有指定“局限性”该放在哪,它就把谨慎平均撒进全文;对话拉得太长,早先的提醒、后来的修订和当前任务混在一起,也容易让输出越来越保守。
判断起来很简单:删掉某句提醒后,事实边界有没有改变?如果没有,只是少了一层重复保险,它多半就是可以收回的防线。
| 01 写作里到处留后路
硕博生最容易在论文初稿里碰到这一类。让 GPT 解释一组结果,它先说“可能说明”,接着补“仍需谨慎解释”,段尾再来一句“未来研究可进一步验证”。单看每句都挑不出硬伤,连起来却把论点磨平了。讨论部分尤其明显:材料有多强,语气始终停在同一个低档位。
为什么会这样?一是模型看不到完整证据,只能用限定词保护不确定区域;二是任务只写了“保持严谨”,没有告诉它怎样分配谨慎;三是正文与局限性没有分工,模型只好边写边提醒。直接要求“删掉所有犹豫词”也不理想,相关关系可能被写成因果,样本内结论也可能被抬成普遍规律。
处理时先给主张分级:数据直接支持的结果,用清楚的陈述句;机制解释保留一次必要限定;样本、方法和外推边界集中放入“局限性”。再把禁止项写明,例如不要在每段重复“仍需研究”,不要为了显得谨慎连续叠加“可能、或许、一定程度上”。如果有高质量范文,可以让模型学习论证节奏和断言强度,但不要模仿原句。
提示词
# 任务根据我提供的结果、方法和参考材料,撰写或改写论文的。 # 证据边界- 只陈述材料能够支持的结论,不新增数据、因果关系或适用范围。- 数据直接支持的结果请直接表述;机制解释最多保留一次必要限定。- 样本、方法和外推限制统一放在“局限性”部分。 # 避免- 不要把“仍需进一步研究”“可能不具普遍性”等提醒散落到每一段。- 不要连续叠加“可能、或许、一定程度上”等同义限定。- 不要重复总结同一条风险,也不要用免责声明代替论证。 # 输出先给出连贯正文,再单列“局限性”。完成后自检:每个限定词是否改变事实边界;若没有,删除。 # 材料
| 02 代码越写越厚
代码场景里的过度防御更直观。你只想改一个数据清洗函数,Agent 却顺手加了哈希校验、兼容旧格式、静默回退、缓存和一套新抽象。代码量翻了几倍,真正要解决的 bug 只占几行。科研脚本本来就讲究可追溯,这种“先兜住再说”的写法还可能把错误吞掉,让异常数据悄悄进入后续分析。
问题往往出在边界模糊。模型不知道哪些输入由上游保证,也不知道项目是否真的需要兼容旧版本,于是把所有想象中的风险都写成分支。若代码库本身已有多层包装,它还会沿着现成模式继续加码。另一个诱因是验收条件太宽,只说“让它更稳定”,等于邀请模型自行定义稳定性。
最有效的做法,是把约束放进项目根目录的 AGENTS.md,让它每次编码都能读到:只改当前问题需要的部分;信任项目内部已经成立的契约;没有需求或失败测试,就不新增回退、兼容层和启发式修补;错误应明确暴露,不能静默吞掉。安全任务另当别论,真正需要校验、鉴权或加密时,要把威胁模型和验收标准写清楚。
提示词1 识别无关结构
# Minimal-change coding rules - 只实现当前任务明确要求的改动,并保持现有接口与项目结构。- 信任仓库内部已经成立的输入契约;不要为未出现、未要求、无失败测试支持的情形增加分支。- 禁止新增与任务无关的 fallback、兼容层、启发式修补、局部稳定化、后处理补丁或一次性抽象。- 不要静默吞掉错误。无法满足前置条件时,返回清楚的错误信息。- 只有在需求、威胁模型或测试明确要求时,才增加哈希、加密、重复校验或降级处理。- 修改前列出将要改动的文件和理由;完成后运行相关测试。测试通过且需求满足后停止,不扩展范围。
提示词2 最小修改方案
请修复:<具体问题>。 允许修改:<文件或模块范围>。验收条件:。 先说明你对现有契约的理解,再给出最小修改方案。不要添加任务未要求的 fallback、兼容层、哈希校验、缓存、重试或新抽象。若发现真实阻塞,先指出证据与影响,不要自行扩大任务。完成后只运行与本次改动相关的检查,并列出实际修改。
| 03 对话越长越保守
还有一种情况没有固定句式,却很容易察觉:同一会话聊了很久,GPT 开始重复背景、回顾旧要求、提前解释自己为什么这样写。你让它改一段摘要,它先花半页交代边界;再追问一次,它又把前几轮的限制全带回来。此时继续追加“别啰嗦”通常只会让上下文更杂。
长对话里混着多版目标、被否定的方案和临时备注。模型需要同时照顾它们,输出自然会变得分散。切换模式有时能改变表达节奏,但更通用的办法是新开会话,只带一份短简报。已经写出的内容则交给一个单独的编辑任务,只做删减,不再承担生成、论证和风险审查。
提示词1 一句话写清交付物
# 当前唯一任务 # 必须保留- # 本轮不要做- 不回顾历史讨论,不复述我已经确认的限制。- 不主动扩展任务,不增加额外建议或免责声明。- 需要限定时只写一次,并放到我指定的位置。 # 输出要求直接交付。若缺少会改变结果的关键信息,只提出一个具体问题;其余细节按现有材料处理。 # 核心材料
提示词2 过度防御清理
你现在只做编辑,不新增论点,也不重新论证。 请删除下文中重复的风险提醒、同义限定、免责声明式结尾和其他与主任务无关的自我解释。
保留真正改变事实边界的限定,并将它们集中到。
调整后直接输出全文,再附一份不超过 5 条的删改说明。
<粘贴原文>
| 04 工作流
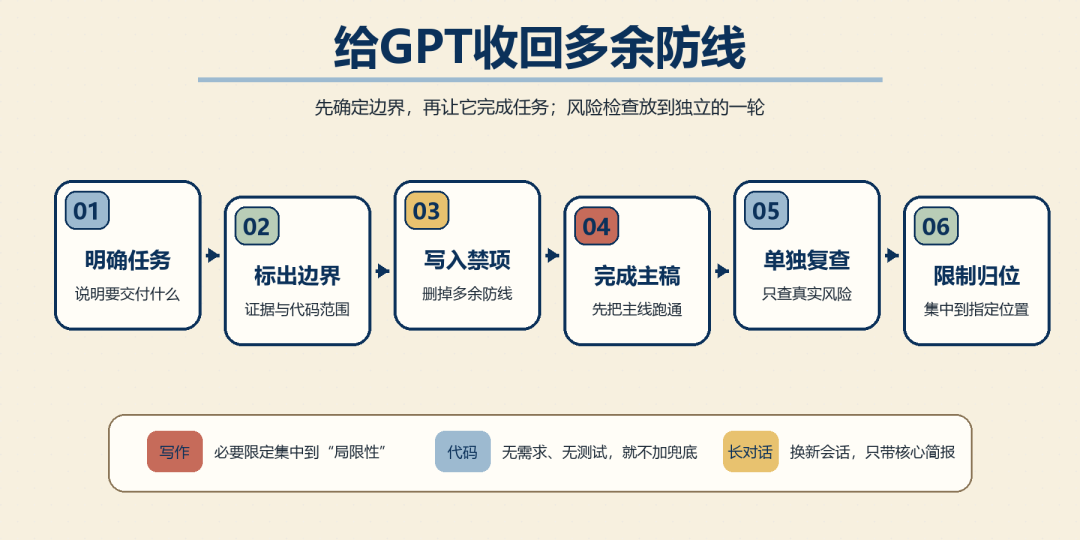
三个场景看似不同,处理顺序其实可以统一:先说清交付物,再划出证据或代码边界;把不希望出现的防御行为写成禁项;完成主稿后另开一轮,只检查真实风险;最后把必要限制集中放到指定位置。这样既不会把谨慎全部删光,也能避免模型边走边筑墙。
| 05 尾声
GPT 的谨慎有时是好习惯,失控后却会拖慢表达和开发。与其一遍遍喊“大胆一点”,不如把边界、禁项和限制位置一次写清。主任务先完成,风险再单独检查。这样收回的是多余防线,留下的才是真正有用的严谨。



