前段时间,Tibo的 X评论区炸锅了:大批用户抱怨自己的使用体验出现严重倒退,回答突然变短、变空,甚至有不少用户的模型明明选择的是Sol,问 AI自己才知道,已经被偷偷换成了 Gpt-5.5-mini。
同样的工作区、差不多的需求、甚至同一套提示词,前几天还能自己拆问题、补边界、顺手把 bug 收掉。这这几天突然开始反复确认已经说过的东西,改掉A忘了B、顺便把C和D的措辞也一并面目全非。
更让人无语的是,除了是网络波动这种可以被清晰感知的,很多时候,AI的智商是一点点下降的。温水煮青蛙,当你察觉AI的输出存在问题前,AI 已经“胡言乱语”有一段时间了。
接下来,我们会总结一些常见的AI“降智”表现,如何识别他们,以及真的遭遇 AI模型异常,如何止损。
| 01 AI"降智"现场
1 回答缩水
把同一条提示词原样保存,连续运行两次,重点比较任务完成度,而不只是字数:引用是否还在,步骤有没有被跳过,代码能否运行,结论有没有凭空增加。
尤其要记录“以前稳定完成、现在反复漏掉”的具体环节。单次回答变差,只能说明这次输出不理想;多次复现,才值得进入排查。
2 能力退步
长对话里,模型可能面对越来越多的历史指令、附件和工具结果。页面显示的模型名称也不一定等于每次请求的底层路由。
你会看到:前面已经确认的约束被遗忘,旧版本的格式要求重新出现,或者同一句话在新会话里正常、旧会话里异常。
| 02 测一测你的AI
当察觉输出内容有问题的时候,除了回去认真检查AI输出结论,我们还可以通过以下三个小问题来对AI进行测试。其中,标识核对回答“这次请求究竟由什么会话和模型处理”,行为测试回答“它现在还能不能稳定完成任务”。
1 标识核对
首先,是让AI确认当前实际正在使用的模型版本,确认是否有被Agent偷偷替换。
提示词
请只报告当前界面或系统明确公开给你的信息:Model ID、模型版本、路由标识、会话 ID,以及本轮是否启用了工具或文件读取。
如果某一字段不可见,请明确写“无法判断”,不要根据回答风格、模型名称或历史记忆推测。不要解释原因,也不要补充不存在的字段。
2 行为测试
确认当前使用的模型版本和Agent显示的一致后,我们可以从两个方向向AI进一步发问。
首先,我们可以直接从科研场景入手,直接问问AI有关之前正在进行的研究的内容,这样不仅科研判断AI当前的智商,也能确认一下记忆是否牢固。
提示词:
你是科研证据审计助手。我会提供一篇论文及其参考文献。请只依据已提供材料,围绕“研究问题—核心变量—识别策略—证据链”完成审计。输出四个部分:1)作者明确报告的事实;2)从方法到结论之间可以成立的推断;3)证据不足或相互冲突之处;4)至少两项可执行的复核步骤。逐条标出原文位置;没有页码或段落定位时写“材料未提供”。不得补造文献、样本量、统计量或作者意图。最后用一段话说明:哪些结论可以保留,哪些只能写成“待验证”.
这个任务足够聚焦,也足够容易比较。你可以把同一提示词、同一附件、同一输出格式放进新旧会话各跑两次,比较遗漏项、引用位置和越界推断。
如果手头没有比较合适的论文,也能问问 AI 这个问题。
提示词:
有一个水杯配对游戏。共有 4 种不同颜色的水杯,每种颜色各有两个。将同色的两个水杯分别放在上下两层,因此上下两层各有 4 个水杯。下层 4 个水杯按某个未知顺序排列,挑战者无法看到它们;上层水杯的颜色和位置则完全可见。游戏开始后,挑战者可以反复进行以下操作:1. 向裁判询问当前有多少个位置满足“上下两个水杯颜色相同”。裁判只回答匹配位置的总数,不透露具体是哪些位置;2. 根据目前获得的所有信息,挑战者可以选择交换上层任意两个相邻位置的水杯。注意只能是相邻,不能是任意两个。
当 4 个位置全部匹配时,游戏结束。问题:
1.挑战者应采用何种策略,才能保证对于下层水杯的任意排列都能完成配对?2.所有能保证成功的策略中,最坏情况所需的交换次数最少是多少?
回答时请不要进行联网搜索,也不要写代码来辅助计算(包括思考过程中)。假设答案是 x ,你需要给出严格的证明,为什么 x 可行,为什么小于 x 不可行。
这道题大家自己也可以试着做做,正确答案是8.
在网络良好的情况下,AI回答正确且完成时间超过5min,可大致判断AI的能力正常;回答错误且输出时间很短,则有很大风险发生了“降智”;如果AI只用了很短时间就给出正确答案,也不要太高兴,把证明结果发给xhigh模式审核一下,看看是不是过程中存在错误。
小编用手头的GPT-5.6 Sol 测试了下,比较庆幸的是结果没问题。
后来,我还用Luna模式也跑了一遍。高情商来说,成功证明了不同等级的AI模型,确实能力上确实存在不小的差距。
除了ChatGPT,小编顺便也考了一考Deepseek V4 Pro,结果没问题,但最直观的感受是输出时间比 Gpt-5.6-Sol 长了非常多。梁小弟还得加油呀。
| 03 发现异常这样止损
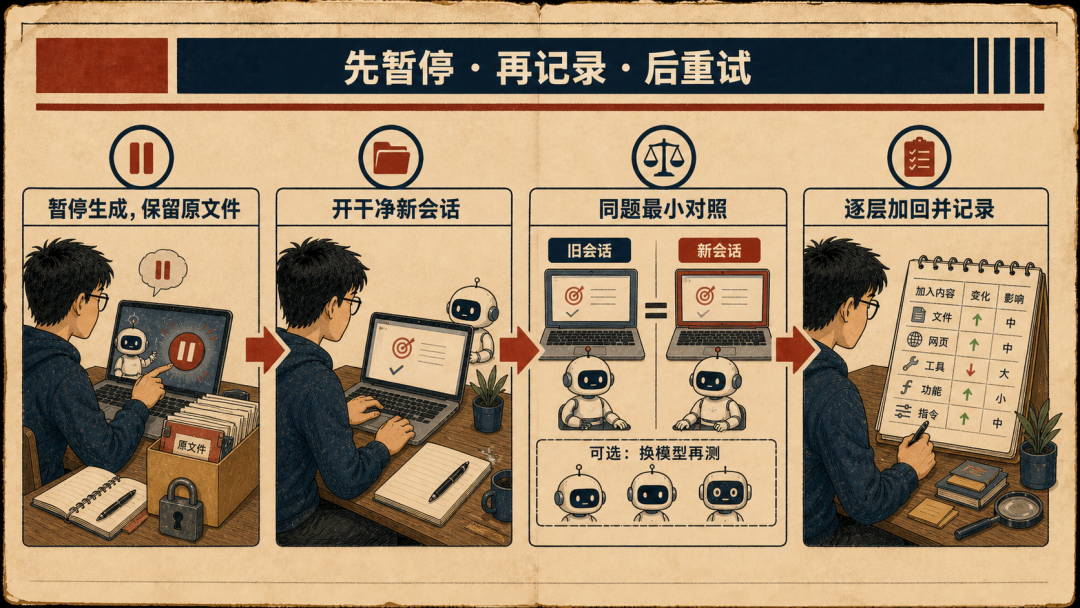
暂停继续生成。不要让一个可疑会话把新的分析、代码或修改覆盖到原文件上;重要材料先保留只读副本。
开一个干净的新会话,只放当前目标、必要材料和明确的输出标准。不要一上来把整段旧对话全部粘回去,否则很难判断问题是否来自历史上下文。
用同一提示词做最小对照:新旧会话各运行两次,必要时换一个官方入口或另一个模型做参照。只比较预先规定的指标,例如是否完成全部步骤、引用是否可核验、代码是否通过基本检查。
再逐层加回材料和工具权限。每增加一层,就记录表现是否改变。这样可以分辨是上下文、附件、工具权限还是路由变化在起作用。
尾声
“AI 降智”有时是模型问题,有时是会话管理问题,也有时只是任务写得太大、太杂。把它当成一个待排查的现象,反而比急着给模型下诊断更省时间。
让 AI 处理检索、整理、格式转换和重复检查,把研究问题、证据判断和最终签字留在自己手里。记录做得足够细,模型状态真的变了,你能拿出对照;如果只是上下文或权限出了问题,也能更快止损。