制作PPT时候,很多同学的论文、实验图、统计表和零散笔记全堆在桌面上,哪段该留下,哪张图能撑住结论,前后页面怎么接,都得重新想一遍。等内容勉强塞进去,字号、配色和版式又乱成了几套,返工时间常常比写大纲还长。
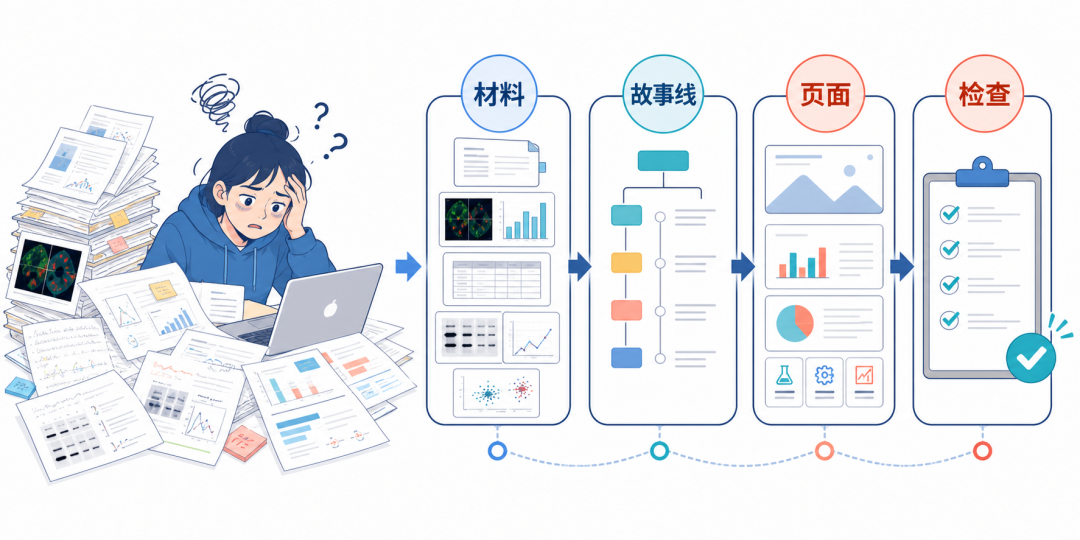
先找模板,再对着模板一页页搬内容。这条路当然能走,只是很吃时间,也容易出现一个问题:页面看起来统一了,故事线仍旧是散的。
AI 在这里最适合接手两件事,一是把材料压成可以汇报的叙事顺序,二是按照这个顺序生成初稿,让我们把时间留给事实核对和最后修改。
接下来,我们将主要基于学术场景,不依赖任何高门槛Skills,只用最基础的对话和提示词,来演示一下如何用 Codex 和 Workbuddy 制作出直观又清晰的PPT。
| 01 确定大纲
本期我们虽然主打简单,但拿到材料后,页别急着直接和大模型说“帮我做一套 PPT”。先让 AI 交付故事线和逐页大纲。这样可以提前检查内容是否缺页、重复,或者把方法和结果放反了。
以下的展示我们将会优先基于 Codex+ChatGPT-5.6-sol 的组合。如果无法使用GPT,通过 Workbuddy搭配 Kimi-K3,也能取得还不错的效果,提示词和输入给 ChatGPT 的完全一致。
任务提示词:
请读取我提供的材料,先规划一套用于【填写汇报场景】的 PPT。
要求:1. 先判断这套 PPT 属于商务汇报、公众演示还是知识讲授,并说明判断依据。2. 用一句话概括整套 PPT 希望听众记住的结论。3. 输出完整故事线,说明开头如何提出问题,中间如何展开,结尾如何收束。4. 按“页码、页面标题、这一页要说明什么、需要哪些文字、建议使用的图表或图片”输出逐页大纲。5. 标出材料中没有提供、需要我补充或核实的信息,不要自行编造。6. 先只输出 Markdown 大纲,不制作 PPT
接下来的全程,我们都会以为论文《基于外泌体 miR-219 探讨参知健脑方干预脑小血管病认知障碍的作用》中“参知健脑方对 CSVCI 大鼠脑功能的保护作用及机制研究”的这部分为主要内容,制作一份用来在组会上讲解这部分,原作者采用的使用方法的PPT。
如果采用的是ChatGPT,对于制作PPT这种比较严谨的任务,大家可以全程保持在Sol模式,减少一点日后返工的风险。
| 03 分情况选择方案
大纲确认后,我们可用先确认一下自己手头有无现成/学校统一规定的模板,再结合自己可以采用的工具(Codex 或 WorkBuddy),选择更适合的方案。
1 无模板,可用Codex
如果更看重视觉,可以先让 ChatGPT-5.6 把逐页大纲做成图片版页面,再让 Codex 的原生 Presentations 参考图片重建成 PPT。
这里要提前说明,重建并不等于无损转换;图片中的复杂插画仍可能作为整图保留,文字、标题和基础图形则可以重新做成可编辑元素。
如果更看重可编辑性,也可以跳过图片稿,直接把故事线、逐页大纲和视觉要求交给 Codex。后面那套 5 页科研 PPT,我采用的就是这条路。
2 有模板,可用Codex
把参考 PPT 模板和大纲同时交给 Codex,让它先识别母版、标题位置、字号层级、配色和常用页面结构,再用原生 Presentations 生成新页面。
模板越规范,复用效果通常越稳定;如果参考文件本身混用了多套字体和版式,AI 也会跟着犹豫。
3 无模板,只能用 WorkBuddy
无法稳定使用 GPT 时,可以在 WorkBuddy 中选择 Kimi-K3,把已经确认的逐页大纲直接交给它生成 PPT。WorkBuddy 可以围绕主题搜集材料并生成演示文稿,也支持根据模板制作。省事之处在于资料读取、生成、预览和下载都在同一个工作区完成。
4 有模板,只能用 WorkBuddy
把参考模板、大纲和必须保留的内容一起上传,再明确要求沿用哪些页面。模型会更容易抓住配色和页面分区,但复杂图表、数字和引用仍要逐项检查。模板只能约束外观,不能替我们判断内容是否正确。
| 04 实战演示1——Codex
在确认大纲后,我们就可以开始制作PPT了
制作提示词:
请使用 Codex 原生 Presentations,把已经确认的 5 页大纲制作成一套 16:9 可编辑 PPT。 视觉要求:- 白色背景,深蓝和青绿色作为强调色;- 科研组会风格,减少装饰,不使用复杂渐变;- 标题要直接说明这一页的结论,正文只保留汇报时需要的信息;- 一页只承担一个主要任务,避免把论文段落整段搬进页面;- 流程关系使用简单的时间线或箭头,检测项目使用分区排版;- 不生成虚构数据,不绘制不存在的结果图;- 每页备注中写明内容来自论文“研究四”的实验方法。 完成后导出 PPTX,并逐页检查文字是否溢出、标题是否换行、元素是否重叠。
等待AI完成输出后,让我们检查一下GPT制作的PPT
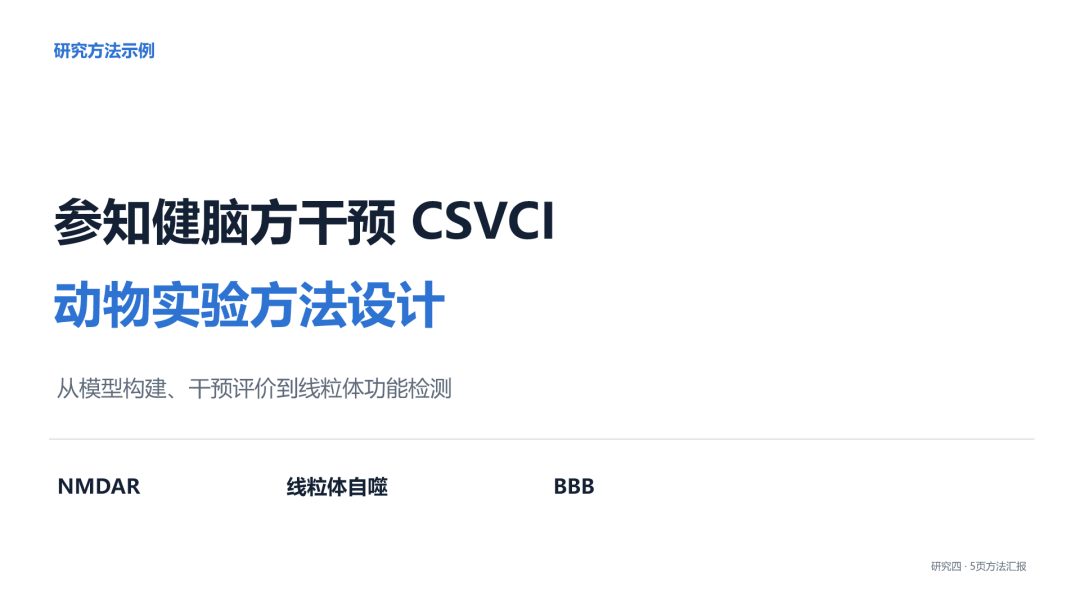
第一张先把研究对象和机制假设交代清楚。没有堆背景,只留下 NMDAR、线粒体自噬和 BBB 三个后面会反复出现的词。
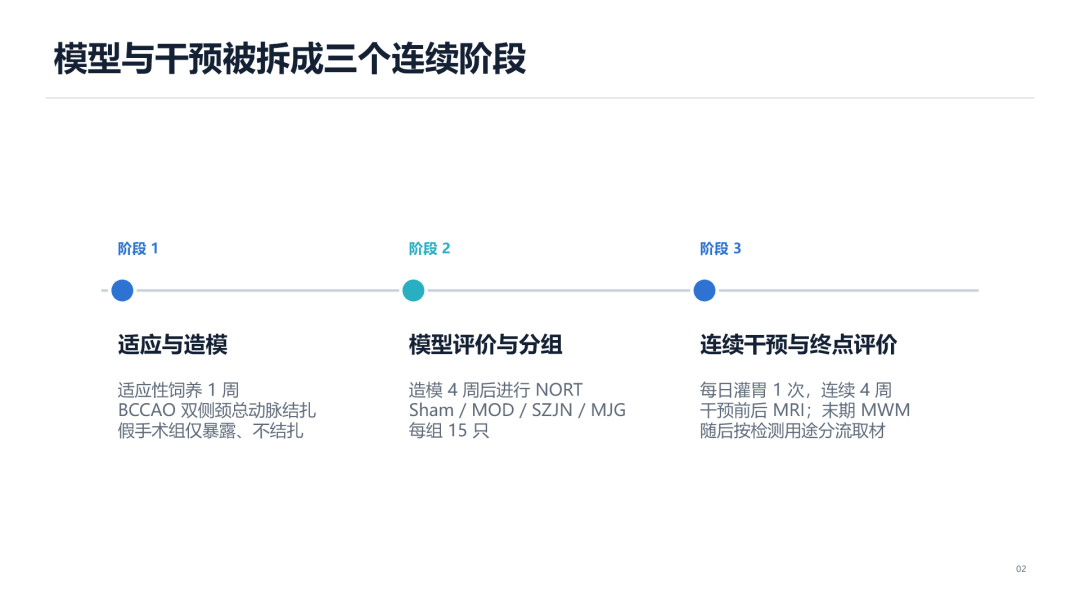
第二张按时间展开。适应和造模、模型评价与分组、连续干预与终点评价放在同一条线上,读者能直接看出实验顺序。
第三张处理的是容易写乱的 MRI 和取材。左边列四种扫描序列,右边把取材用途分开,避免把固定组织、电镜样本和新鲜组织混为一谈。
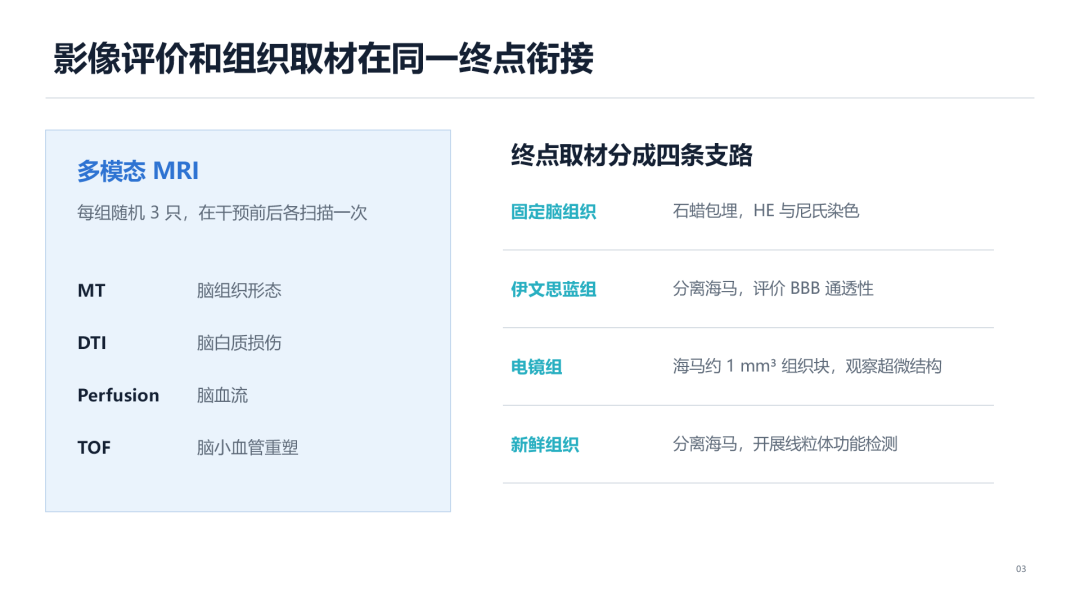
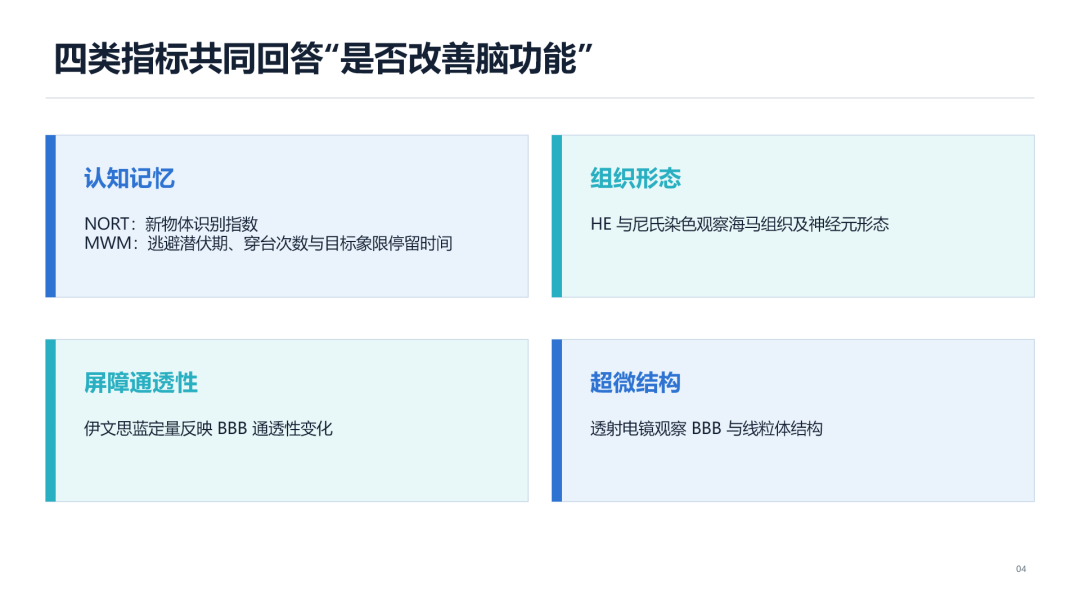
第四张不按实验步骤写,而是按“要评价什么”重新分组。认知记忆、组织形态、屏障通透性和超微结构各占一个区域,汇报时更容易讲。
最后一张回到机制检测。JC-1、ROS 和统计方法被放在右侧,左边保留论文提出的机制路径。到这里,方法部分形成了“行为、影像、组织、线粒体”的检测链条。
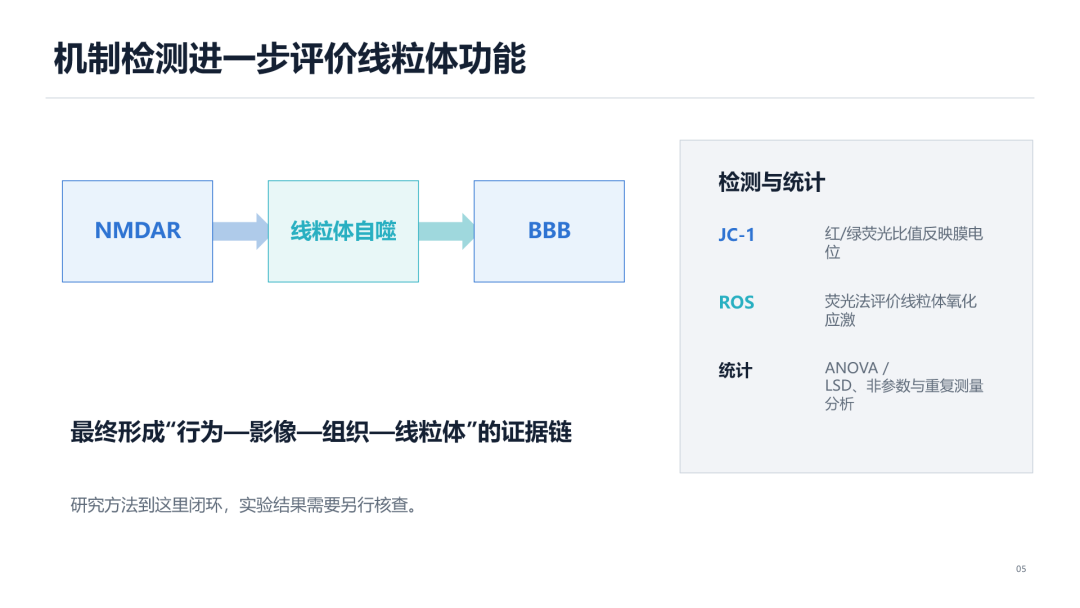
可以看到这套页面没有依赖现成模板,也没有为了“像科研 PPT”塞进大段文字,只需要把字体大小和措辞稍微调整一下即可。
当然比起这些,更重要的其实是核对具体内容:组别是不是四组,NORT 和 MWM 分别出现在哪个时间点,MRI 扫描了几只,论文没有给出的结果有没有被模型擅自补上。
| 05 实战演示2——WorkBuddy
在 WorkBuddy 的流程,和 Codex 上完全一致,先输出大纲,确认大纲后选择 Kimi-K3,并说明页数、场景和配色,它可以直接生成一版供我们修改。这里只展示输出效果。
小编评价
两份PPT,与其说哪份一定更好,不如说是代表了两种不一样的风格。虽然相对ChatGPT-5.6,Kimi-K3输出的PPT信息密度明显更高。但更丰富信息,代价就是讲解起来需要费更多功夫,讲述者要频繁引导听众的注意力。
如果任务是“只把研究方法部分讲清楚”,ChatGPT-5.6输出的版本更守题、更适合作为可编辑初稿;Kimi-K3 的版本更像一套已经带入研究背景、结果图和结论的组会汇报,视觉完成度更高,但已经越过了“只做方法、不补结果”的边界。可能更适合发给老师细看,而非现场讲解。
尾声
做 PPT 这件事,工具装得再多,也不会自动产生一条好故事线。对刚开始用 AI 的研究生来说,先跑通“读材料、定大纲、生成页面、逐页核对”这条线,比反复更换平台更有用。等这套流程顺手以后,再决定要不要先生成图片稿、是否复用模板,或者把任务换到 WorkBuddy。
AI 可以把第一页更快地摆到我们面前,最终哪些内容值得放上去,仍然要由做研究的人来定。